Verwaltung ausgehender A2P-SMS-Warteschlangen: Annahme, Abbau und Wiederherstellung
Ein Leitfaden für den Betrieb: Legen Sie fest, welche Nachrichten die Warteschlange annimmt, wie Fehler klassifiziert werden, wann Nachrichten ablaufen und wie sich der Nachrichtenfluss wiederherstellen lässt, ohne die Annahme durch nachgelagerte Systeme mit der Zustellung an den Empfänger zu verwechseln.
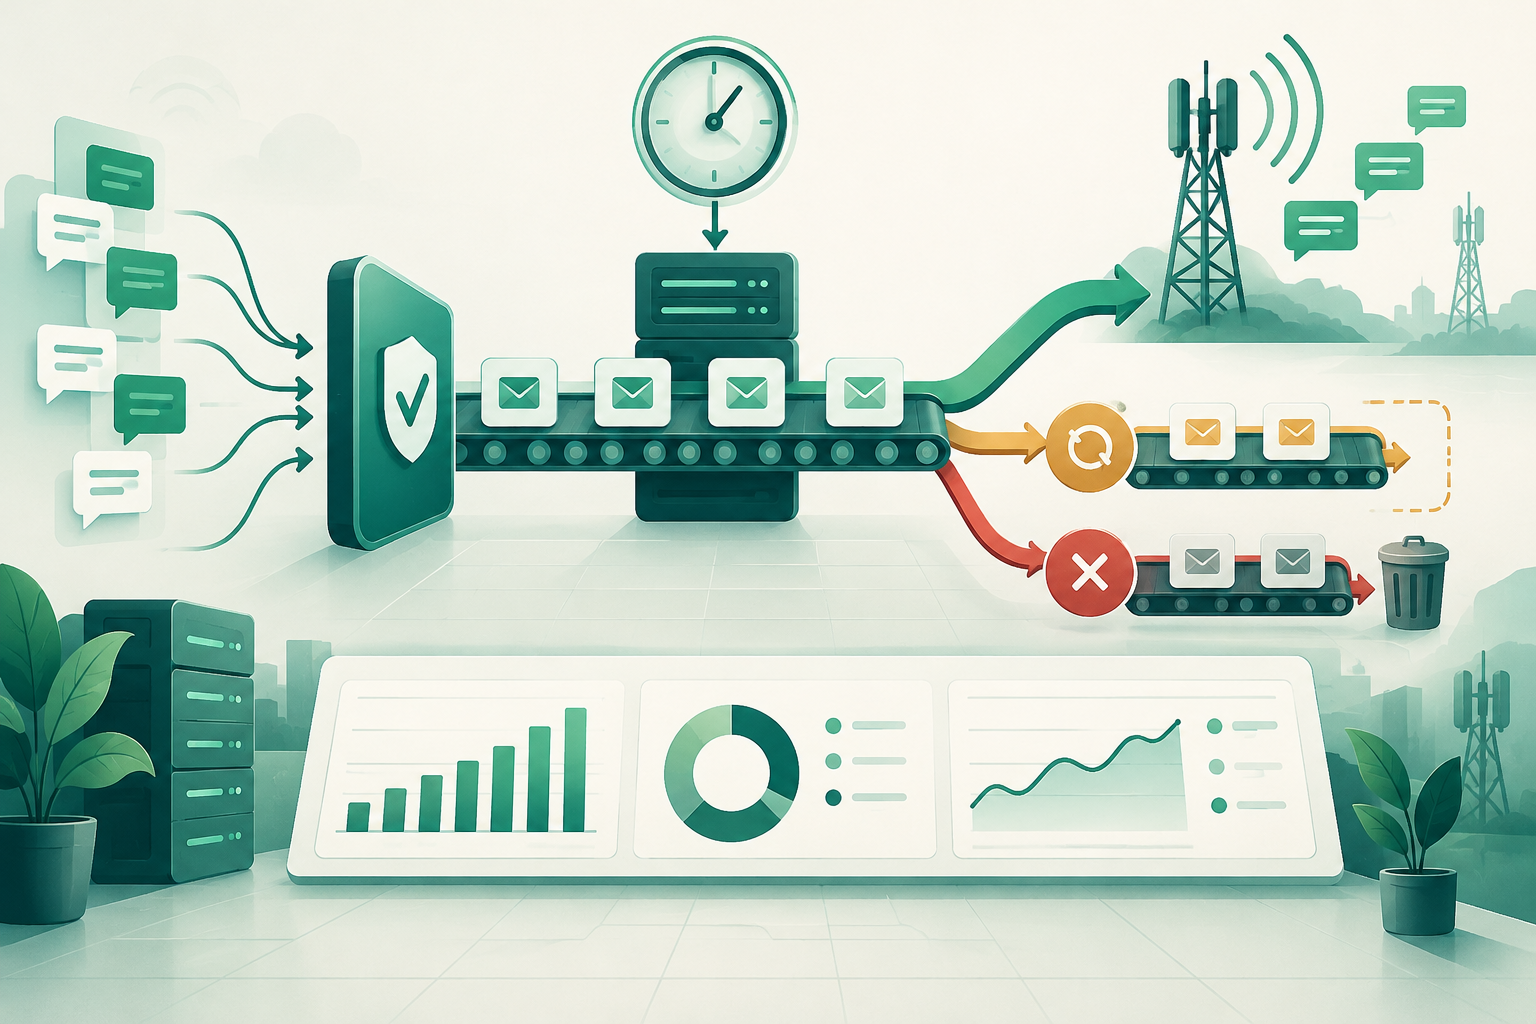
Die Warteschlange beginnt dort, wo ein System die Nachricht zurückhält
In einer A2P-Nachrichtenkette kann es mehrere Warteschlangen geben: in der sendenden Anwendung, auf der Messaging-Plattform, über eine Verbindung oder einen Vermittler sowie in nachgelagerten Systemen. Damit der Betrieb transparent bleibt, sollten Sie festhalten, welche Warteschlange Sie messen und wer für die einzelnen Übergänge verantwortlich ist.
Eine Nachricht, die sich „in der Warteschlange“ befindet, wurde noch nicht zwangsläufig vom nächsten System angenommen. Und auch dessen Annahme belegt nicht, dass die Nachricht das Mobiltelefon erreicht hat. Legen Sie die Verantwortungsgrenze ausdrücklich fest, etwa anhand der folgenden Ereignisse: Eingang der Nachricht auf der Plattform, Sendeversuch, Annahmebestätigung des nächsten Systems und – sofern verfügbar – späteres Zustellergebnis.
- Weisen Sie jeder Nachricht eine Kennung zu, die sich über die von Ihnen kontrollierten Systeme hinweg zuordnen lässt.
- Protokollieren Sie, wann die Nachricht in die Warteschlange gelangt, wann ihre Verarbeitung versucht wird und welches Ergebnis das nächste System zurückmeldet.
- Halten Sie interne Statusangaben und Statusangaben aus externen Schnittstellen oder Berichten getrennt.
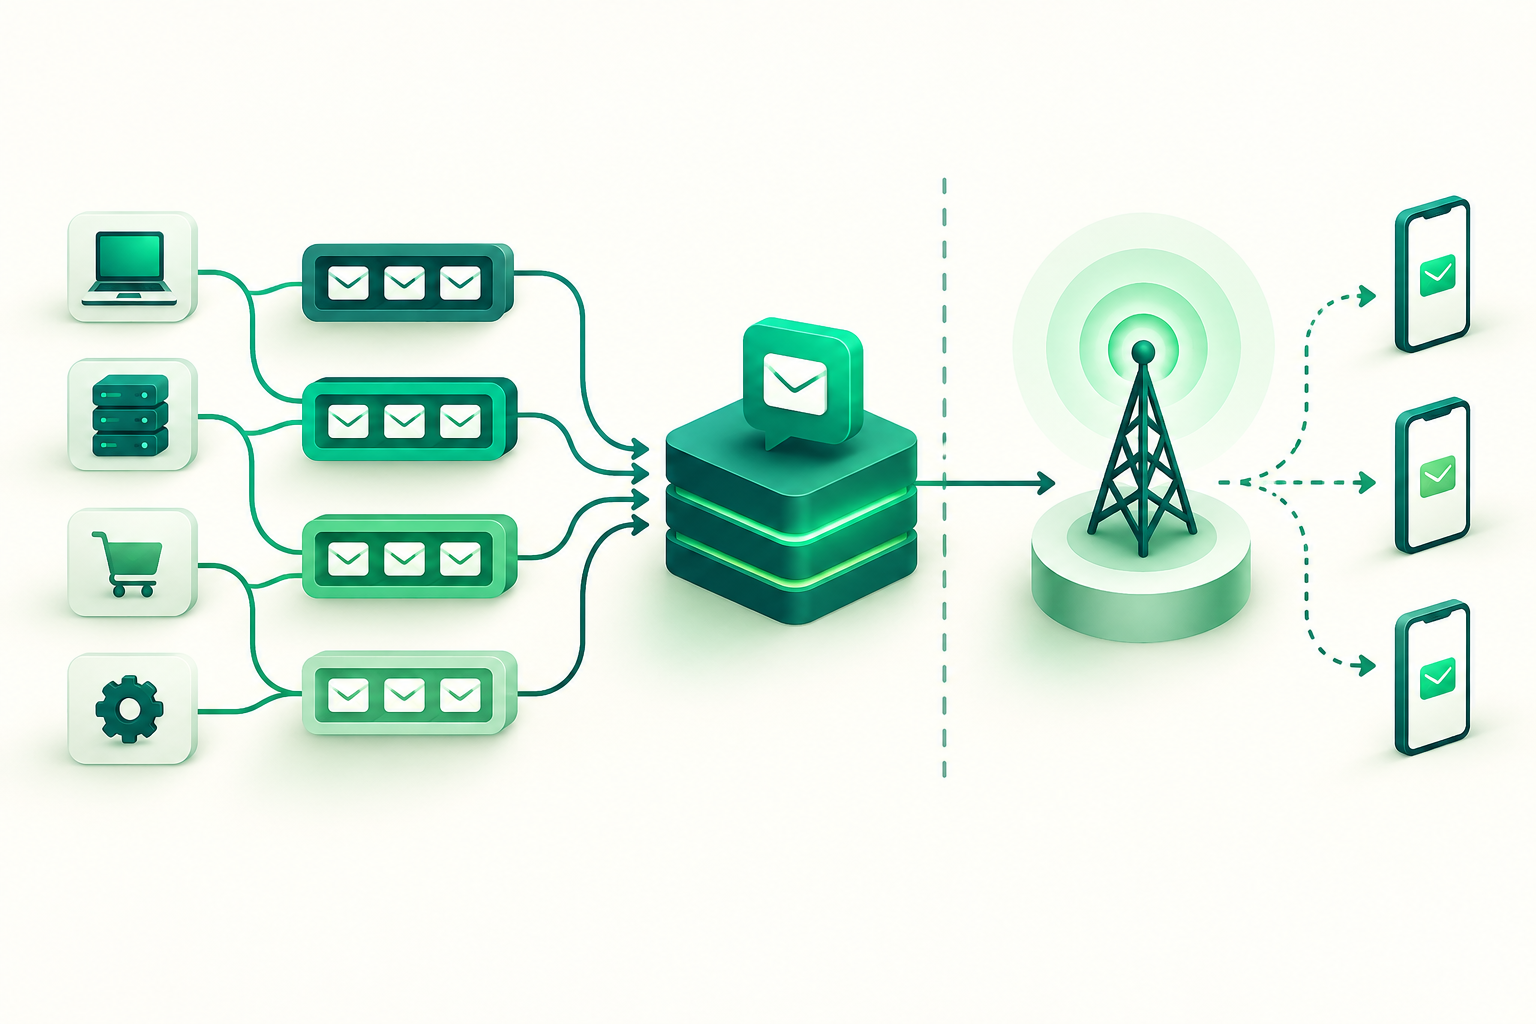
Status definieren, die den tatsächlichen Ablauf abbilden
Ein nützliches internes Modell unterscheidet zwischen ausstehender Arbeit, laufender Verarbeitung und Nachrichten, für die bereits eine Antwort des nächsten Systems vorliegt. Außerdem sollte es zurückgestellte, abgelaufene und zur Prüfung vorgemerkte Nachrichten abbilden. Das sind Betriebskategorien: Sie sollten weder als normativ festgelegte SMPP-Statusliste dargestellt noch automatisch mit Codes einer Schnittstelle gleichgesetzt werden.
Dokumentieren Sie zulässige Statusübergänge, das auslösende Ereignis und das System, das den Nachweis liefert. So kann eine Annahmebestätigung des nachgelagerten Systems die Verantwortung der lokalen Warteschlange beenden. Als endgültige Zustellung an den Empfänger darf sie jedoch nur bezeichnet werden, wenn dafür geeignete Nachweise vorliegen.
- Ausstehend: von der Plattform angenommen, aber noch nicht aktiv bearbeitet.
- In Bearbeitung: Ein Worker verarbeitet den Sendevorgang.
- Nachgelagert angenommen: Das nächste System hat die Nachricht angenommen; dies bedeutet nicht, dass sie auf dem Endgerät eingegangen ist.
- Zurückgestellt: Die Verarbeitung wird gemäß einer festgelegten Richtlinie aufgeschoben.
- Abgelaufen: Die zeitliche Nutzbarkeit der Nachricht ist beendet; sie sollte nicht mehr so versendet werden, als wäre sie noch gültig.
- Zur Prüfung: Vor der Fortsetzung oder dem Abschluss ist eine betriebliche Entscheidung erforderlich.
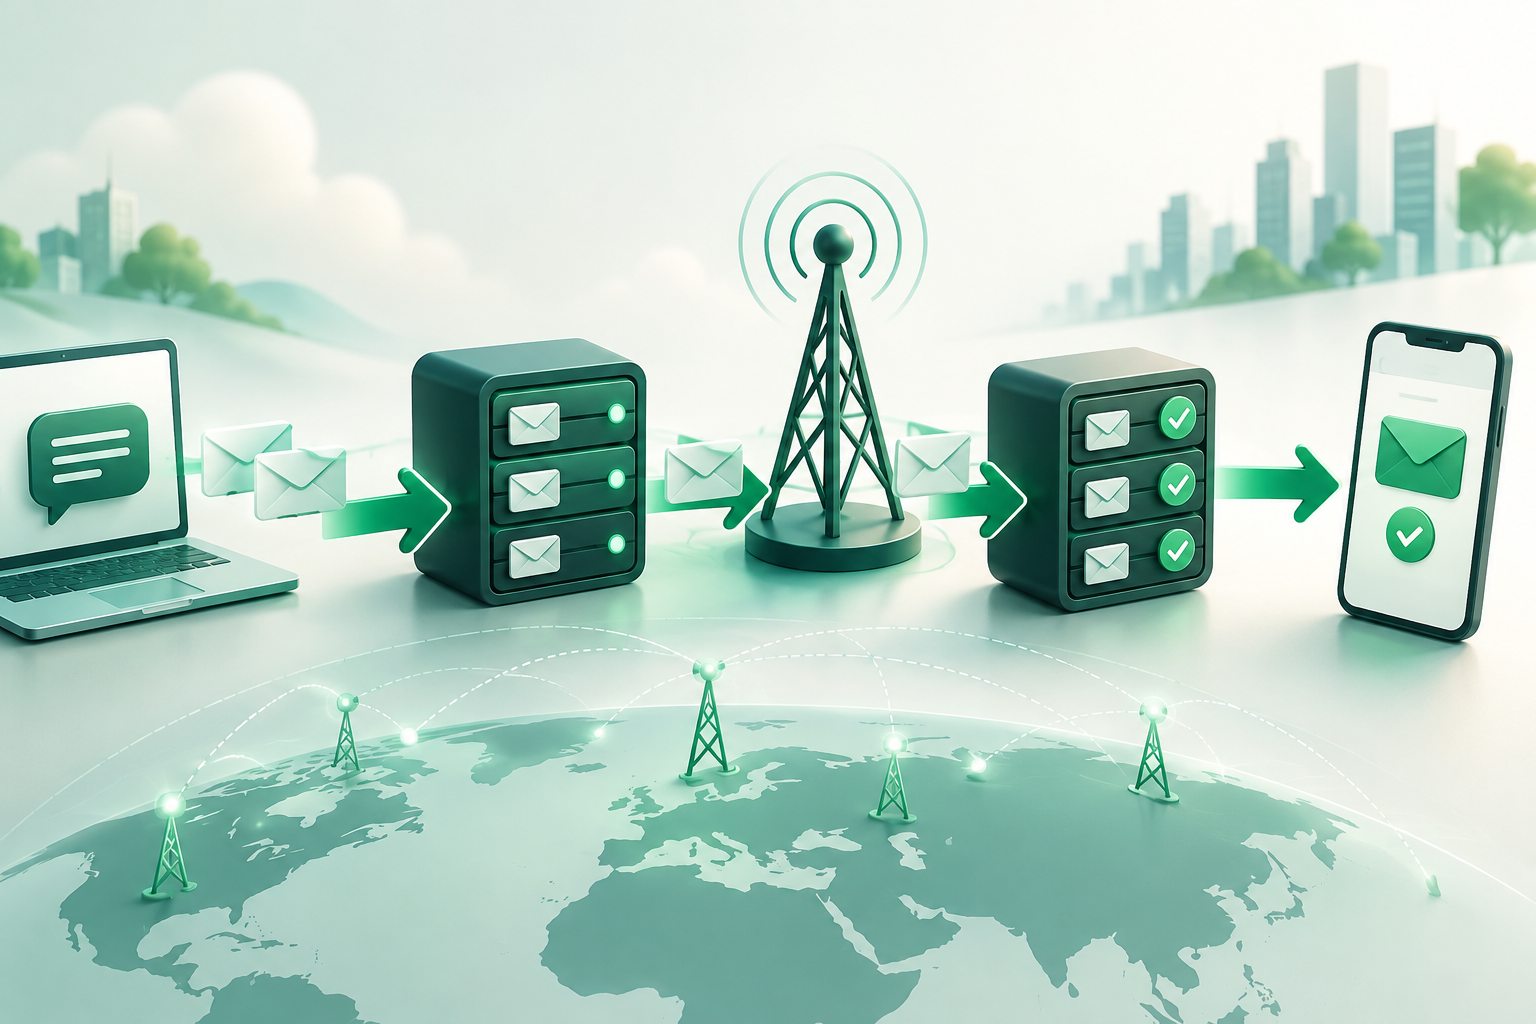
Nachrichten so annehmen, dass die Kapazität geschützt bleibt
Eine Warteschlange sollte nicht unbegrenzt anwachsen. Legen Sie Annahme- und Kapazitätsgrenzen anhand der Ressourcen fest, die Sie tatsächlich kontrollieren: Speicher, verfügbare Worker, Verbindungen und die konfigurierte Kapazität für Ziele oder Verkehrsklassen. Ohne Kenntnis der Architektur, Vereinbarungen und beobachteten Auslastung lässt sich kein allgemeingültiger Schwellenwert festlegen.
Eine Aufteilung nach Ziel oder Klasse kann verhindern, dass ein problematischer Nachrichtenstrom sämtliche Ressourcen anderer Ströme belegt. Die Aufteilung erhöht allerdings auch die Komplexität: Definieren Sie, was beim Erreichen einer Grenze geschieht, wie das Ergebnis dem Absender mitgeteilt wird und wer die Richtlinie anpassen darf. Nehmen Sie eine Nachricht nicht an, wenn das System sie nicht zuverlässig bis zur Verarbeitung speichern oder eindeutig ablehnen kann.
- Legen Sie Grenzen für jede Warteschlange und für Segmente mit unterschiedlichem Verhalten oder abweichenden Anforderungen fest.
- Definieren Sie eine klare Maßnahme bei Erreichen der Kapazität: ablehnen, zurückstellen oder eine andere dokumentierte Richtlinie anwenden.
- Stellen Sie sicher, dass die sendende Anwendung Annahme und Ablehnung unterscheiden und eigene Wiederholungsversuche ohne doppelte Sendungen steuern kann.
- Überprüfen Sie die Grenzwerte anhand von Eingangs- und Ausgangsdaten, Nachrichtenalter und Ressourcen – nicht anhand allgemeiner Richtwerte.
Fehler vor einem erneuten Versuch klassifizieren
Nicht jeder Fehler rechtfertigt dieselbe Behandlung. Vorübergehende Überlastung, Nichtverfügbarkeit, möglicherweise vorübergehende Ablehnung und Fehler, die eine Korrektur der Nachricht oder Konfiguration erfordern, haben unterschiedliche Folgen. Klassifizieren Sie die Antwort anhand der konkreten Rückmeldung der Schnittstelle oder des verbundenen Systems und der einschlägigen Dokumentation. Erfinden Sie keine Entsprechungen zwischen Codes.
Dokumentieren Sie für jede Fehlerklasse, ob die Nachricht erneut versucht, zurückgestellt, abgelehnt oder zur Prüfung vorgemerkt wird. Wiederholungsversuche müssen begrenzt und zwischen Absender und Plattform abgestimmt sein: Wiederholen beide Seiten den Sendevorgang ohne Koordination, können sie die Last erhöhen und Duplikate erzeugen. Bewahren Sie das ursprüngliche Ergebnis zur Diagnose auf.
- Überlastung: Ressourcen schützen und die festgelegte Annahme- oder Zurückstellungsrichtlinie anwenden.
- Nichtverfügbarkeit: Prüfen, ob Warten und ein erneuter Versuch angemessen sind; Grund dokumentieren und Wiederholungen begrenzen.
- Möglicherweise behebbare Ablehnung: Klären, welche Bedingung sich ändern muss, bevor ein neuer Versuch erfolgt.
- Permanenter oder nicht automatisch behebbarer Fehler: Wiederholungsschleifen vermeiden und den Fall abschließen oder zur Prüfung weiterleiten.
- In allen Fällen die beobachtete Antwort und die getroffene Entscheidung protokollieren.
Reihenfolge und Priorität ohne Verhungern
FIFO – First In, First Out, also zuerst eingegangen, zuerst verarbeitet – ist eine einfache Option, wenn für alle Nachrichten einer Warteschlange ähnliche Dringlichkeitsanforderungen gelten und es keinen betrieblichen Grund gibt, die Reihenfolge zu ändern. Gibt es Klassen mit unterschiedlicher Gültigkeitsdauer oder Priorität, kann eine ausdrückliche Richtlinie besser geeignet sein. Sie muss jedoch die Nachverfolgbarkeit sichern und verhindern, dass Nachrichten niedrigerer Priorität auf unbestimmte Zeit blockiert werden.
Legen Sie vor der Einführung von Prioritäten fest, welche Nachrichten zu welcher Klasse gehören dürfen, wer die Klassifizierung bestimmt und wie sich die Wirksamkeit der Richtlinie überprüfen lässt. Richten Sie Prioritäten nicht nach sensiblen Inhalten aus und nutzen Sie sie nicht, um Einwilligungs- oder Compliance-Kontrollen zu umgehen.
- FIFO verwenden, wenn die Reihenfolge wichtig ist und die Nachrichten einer homogenen Klasse angehören.
- Klassen nur dann trennen, wenn ein begründeter und überprüfbarer betrieblicher Bedarf besteht.
- Wartezeiten je Klasse messen und prüfen, ob eine Priorisierung andere Klassen verhungern lässt.
- Das Verhalten bei gleicher Priorität und bei Änderungen der Klassenzuordnung dokumentieren.
Die Gültigkeitsdauer an den Nutzen der Nachricht anpassen
Die Gültigkeitsdauer gibt an, wie lange es sinnvoll bleibt, eine Nachricht zu senden. Ein Einmalcode, eine Transaktionsbenachrichtigung und eine autorisierte Kampagne können unterschiedliche zeitliche Anforderungen haben. Gehen Sie nicht davon aus, dass für alle derselbe Zeitraum geeignet ist. Der Verantwortliche für die Nachricht sollte ihren Nutzen festlegen; die Plattform sollte eine damit abgestimmte Richtlinie anwenden.
Nach Ablauf der Gültigkeit darf eine Nachricht nicht stillschweigend so versendet werden, als wäre sie noch gültig. Protokollieren Sie den Ablauf und melden Sie das Ergebnis so, dass die sendende Anwendung entscheiden kann, wie sie weiter verfährt. Ein möglicher neuer Versand muss als neue Geschäftsentscheidung behandelt werden, nicht als automatische Wiederholung veralteter Inhalte.
- Die Gültigkeitsdauer für jeden Anwendungsfall gemeinsam mit dem Verantwortlichen der Nachricht festlegen.
- Vor jedem neuen Versuch das Alter prüfen, sofern die Richtlinie dies verlangt.
- Ablauf von Ablehnung und fehlgeschlagener Zustellung unterscheiden.
- Abgelaufene Nachrichten nicht ohne ausdrückliche Entscheidung automatisch wieder aktivieren.
Den Dienst mit einem kontrollierten Abbau wiederherstellen
Nach einer Unterbrechung bedeutet die Wiederherstellung nicht einfach, alle ausstehenden Sendungen fortzusetzen. Prüfen Sie zunächst, ob die Ursache des Rückstaus behoben ist und das nächste System Nachrichten annehmen kann. Geben Sie die Arbeit anschließend schrittweise und entsprechend der verfügbaren Kapazität frei. Die Grenzen für die Parallelverarbeitung müssen sich nach der Konfiguration und den geltenden Vereinbarungen richten.
Überwachen Sie während des Abbaus, ob das Nachrichtenalter oder die Warteschlangentiefe erneut steigt, Ablehnungen zunehmen und die erwarteten Ergebnisse weiterhin erreicht werden. Eine schrumpfende Warteschlange ist kein ausreichender Beleg für eine erfolgreiche Wiederherstellung, wenn Nachrichten ablaufen, abgelehnt oder unbemerkt zur Prüfung weitergeleitet werden.
- Die Ursache der Unterbrechung ermitteln und beheben, bevor der Versand beschleunigt wird.
- Mit kontrollierten Grenzen fortsetzen, statt angesammelte Nachrichten unbegrenzt auf einmal freizugeben.
- Annahme durch nachgelagerte Systeme und spätere Ergebnisse getrennt überprüfen.
- Ein Verfahren bereithalten, um den Versand erneut anzuhalten, wenn sich der Rückstau wieder aufbaut oder die Ergebnisse schlechter werden.
Den Zustand der Warteschlange überwachen – nicht nur ihre Größe
Die Warteschlangentiefe zeigt, wie viele Nachrichten warten, erklärt für sich genommen aber nicht, ob sich die Lage verbessert. Ergänzen Sie sie durch das Alter der ältesten Nachricht, Ein- und Ausgangsrate sowie nach Ziel und Klasse aufgeschlüsselte Ergebnisse. Bewerten Sie diese Kennzahlen zusammen mit Ereignissen zu Annahme, Ablehnung, Zurückstellung und Ablauf.
Die Annahme durch das nächste System muss als Annahme und nicht als endgültige Zustellung ausgewiesen werden. Wenn Zustellberichte eingehen, hängt ihre Bedeutung von der Quelle und dem Grad der Überprüfung ab: Ein empfangener DLR bedeutet nicht zwangsläufig, dass der Eingang auf dem Endgerät unabhängig bestätigt wurde. Dokumentieren Sie diese Unsicherheit in Dashboards und Berichten.
- Warteschlangentiefe und Alter der ältesten Nachricht.
- Ein- und Ausgangsraten in Zeitintervallen, die zum Betrieb passen.
- Annahmen, Ablehnungen, Zurückstellungen, abgelaufene Nachrichten und zur Prüfung weitergeleitete Nachrichten.
- Ergebnisse nach Ziel und Klasse aufgeschlüsselt, mit einheitlichen Definitionen.
- Warnmeldungen anhand eigener betrieblicher Schwellenwerte, die mit realen Daten überprüft werden.
Häufige Fragen
Bedeutet die Annahme einer Nachricht durch ein nachgelagertes System, dass sie zugestellt wurde?
Nein. Sie zeigt an, dass das nächste System die Nachricht laut beobachteter Antwort angenommen hat. Für sich allein beweist das nicht, dass sie das Mobiltelefon erreicht hat. Auch Zustellberichte müssen abhängig von ihrer Quelle und ihrem Verifizierungsgrad interpretiert werden.
Wie groß sollte eine ausgehende Warteschlange maximal sein?
Es gibt keinen allgemeingültigen Wert für alle Plattformen. Der Grenzwert hängt von Ressourcen, Zielen, Verkehrsklassen, Vereinbarungen und beobachtetem Verhalten ab. Legen Sie ihn anhand betrieblicher Daten fest und definieren Sie eine klare Maßnahme für den Fall, dass er erreicht wird.
Sollte jede abgelehnte Nachricht erneut versucht werden?
Nein. Ermitteln Sie zunächst anhand der Antwort und der Dokumentation der verbundenen Schnittstelle, ob die Ursache vorübergehend, behebbar oder permanent ist. Begrenzen Sie Wiederholungsversuche, vermeiden Sie unkoordinierte Wiederholungen durch Absender und Plattform und versuchen Sie nicht automatisch, abgelaufene Inhalte erneut zu senden.
Sollte immer FIFO verwendet werden?
FIFO ist sinnvoll, wenn die Reihenfolge erhalten bleiben muss und die Nachrichten ähnliche Anforderungen haben. Falls Prioritäten erforderlich sind, definieren Sie Klassen und Regeln ausdrücklich und überwachen Sie, ob eine Klasse dazu führt, dass eine andere unbegrenzt warten muss.
Verwendete Quellen
- SMPP v3.4, Issue 1.2SMPP Developers Forum
- HTTP Semantics (RFC 9110)IETF
- 3GPP specifications by series3GPP
- ITU-T Recommendation E.164International Telecommunication Union
- GSMA networks resourcesGSMA