Étiquettes de trafic A2P SMS : concevoir une taxonomie utile pour analyser la qualité, les coûts et les incidents
Une taxonomie d’étiquettes A2P SMS permet de distinguer l’intention d’envoi des résultats observés, de comparer les segments de manière cohérente et de protéger les données personnelles dans les opérations.
Pourquoi les états de livraison ne suffisent pas
Les états de livraison constituent une partie importante des éléments de preuve opérationnels, mais ils ne décrivent pas à eux seuls le contexte d’un envoi. Dans les SMS, les rapports d’état, les tentatives de transfert, certaines causes d’erreur et les nouvelles tentatives liées à la disponibilité du terminal font partie d’un cycle technique comportant plusieurs résultats possibles.
Un même état agrégé peut avoir des implications opérationnelles différentes selon le cas d’usage, la criticité, le pays de destination, le type d’expéditeur, la politique de routage appliquée ou la version du contenu. Sans ces dimensions, une variation de l’acceptation, des DLR ou de la latence peut être visible, mais difficile à attribuer et à investiguer.
Une taxonomie d’étiquettes A2P SMS apporte ce contexte de manière structurée. Son objectif n’est pas de remplacer les événements techniques ni les identifiants de corrélation, mais de permettre leur segmentation au moyen de catégories stables, comparables et auditables.
- Séparer le trafic OTP, les alertes transactionnelles et les campagnes avec consentement.
- Distinguer les messages critiques des messages non critiques afin de prioriser la réponse opérationnelle.
- Comparer les résultats par pays ou territoire, politique logique de routage et version de modèle.
- Éviter qu’une baisse agrégée ou une amélioration apparente masque des comportements divergents entre les segments.
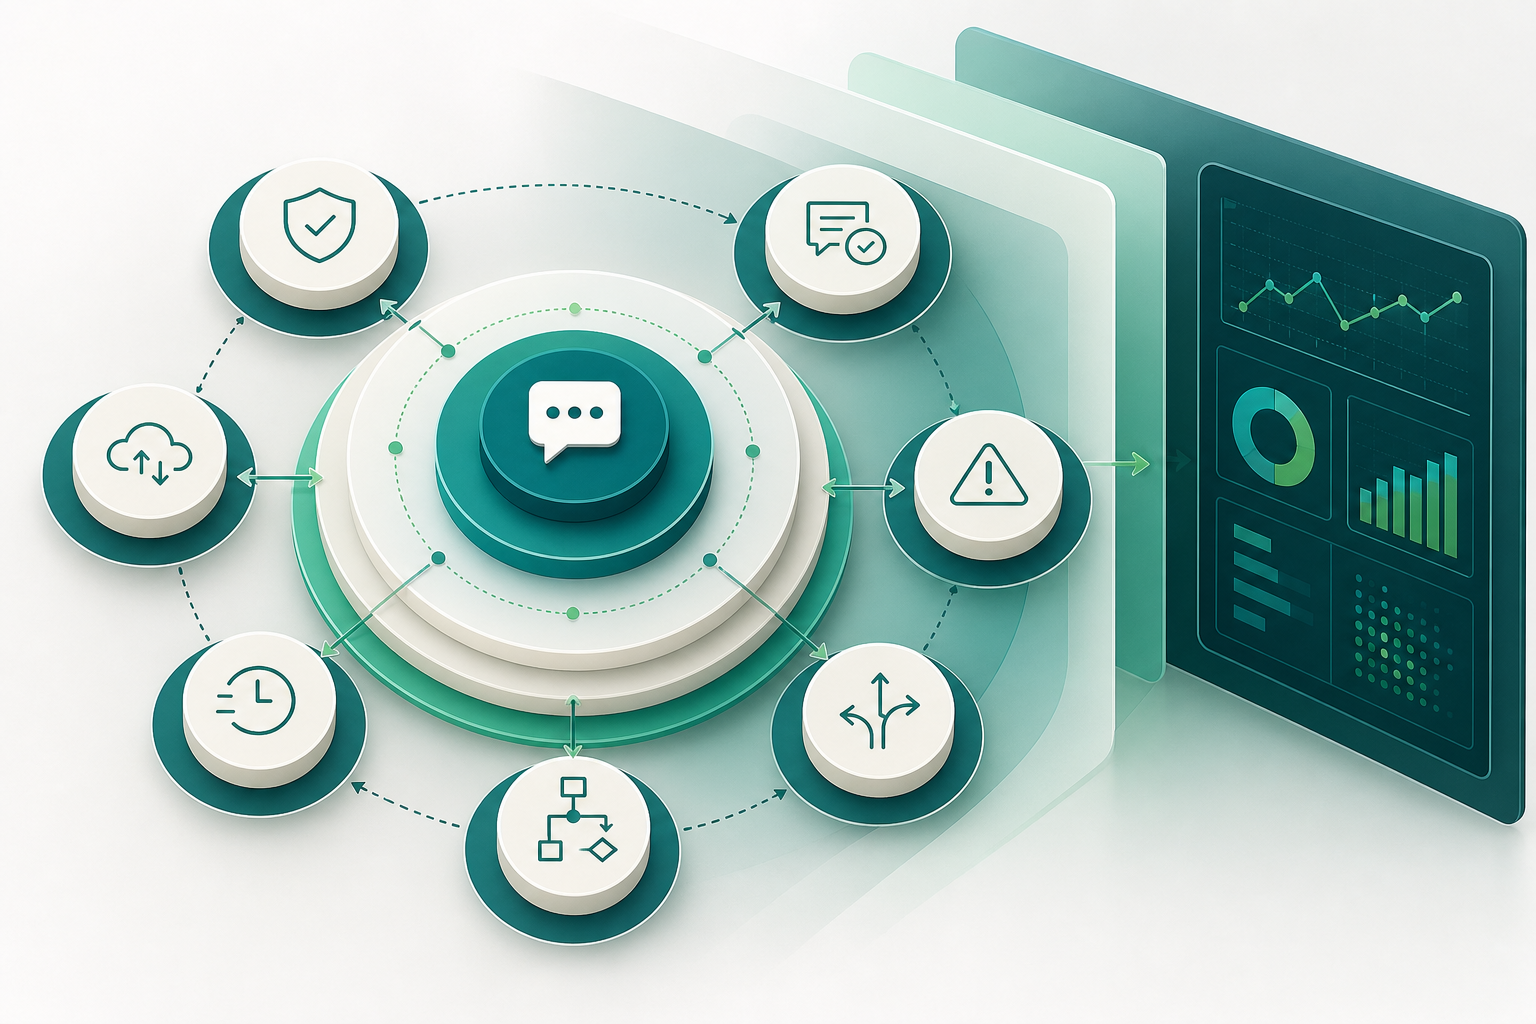
Principe de conception : identité technique, classification opérationnelle et données personnelles sont des couches distinctes
Le premier principe consiste à séparer trois catégories souvent mélangées : l’identité technique servant à corréler les événements, la classification opérationnelle servant à analyser le trafic, et les données personnelles ou contenus sensibles qui doivent être minimisés.
L’architecture SMS utilise des identifiants et des rapports pour associer les messages aux événements techniques. Ces identifiants sont utiles pour reconstruire une séquence précise, mais ne doivent pas devenir la taxonomie analytique. De même, les catégories métier ne font pas nécessairement partie des identifiants réseau et doivent être gérées comme des métadonnées propres à la plateforme.
La classification opérationnelle doit répondre à des questions répétables : qu’était-il prévu d’envoyer, selon quelle politique la décision d’envoi a-t-elle été prise, et dans quel segment doit-il être comparé ? Les données personnelles, en revanche, ne doivent pas être introduites dans les étiquettes par commodité analytique.
- Identité technique : identifiant interne du message, identifiant de corrélation et références d’événements protégées.
- Classification préalable : cas d’usage, criticité, pays de destination, type d’expéditeur, canal d’origine, campagne, route logique et version de modèle.
- Résultat observé : acceptation, état ou DLR, cause d’échec, horodatages et latence calculée.
- Données à éviter : MSISDN complet, texte du SMS, OTP, nom d’une personne, adresse et identifiants de compte reconnaissables.
Champs minimaux d’une taxonomie opérationnelle
L’ensemble exact dépend du modèle opérationnel, mais une taxonomie minimale doit offrir une capacité de segmentation sans créer une combinatoire ingérable. Chaque champ doit avoir une finalité d’analyse précise, une source définie et des valeurs contrôlées.
Il est préférable de conserver les étiquettes de classification avec l’enregistrement de l’envoi, et de stocker les résultats observés en tant qu’événements distincts ou champs d’état assortis d’horodatages. Cette séparation évite qu’une observation ultérieure réécrive l’intention ou la décision d’origine.
Un schéma pratique peut employer des noms techniques stables, de préférence indépendants de la langue des tableaux de bord. Par exemple, use_case ou logical_route peuvent être conservés comme clés système, tandis que leurs descriptions sont affichées dans la langue des utilisateurs internes.
- use_case : finalité opérationnelle, telle que otp, transactional_alert ou consented_marketing.
- criticality : priorité métier ou opérationnelle, par exemple critical, high, standard ou low.
- destination_country : pays ou territoire dérivé de la structure de numérotation internationale ; et non le numéro complet.
- sender_type : classification de l’expéditeur utilisée par les opérations, telle que alphanumeric, long_number, short_code ou toute autre valeur applicable à l’environnement.
- origin_channel : système ou canal à l’origine de l’envoi, par exemple api, smpp, portal ou system_event.
- campaign_class : catégorie de regroupement opérationnel, telle que lifecycle, service_notice ou consented_promotion ; et non un nom libre contenant des informations client.
- logical_route : profil, politique ou décision logique de routage sous le contrôle des opérations.
- provider_logical : référence interne au fournisseur ou à la capacité logique, sans affirmer un cheminement physique non observé ou non vérifiable. N’utilisez pas de nom commercial s’il n’est pas nécessaire à l’analyse autorisée. Un identifiant interne stable, protégé par des contrôles d’accès appropriés à la finalité opérationnelle correspondante, peut également être utilisé. La valeur doit représenter l’entité ou la capacité sélectionnée logiquement, et non une garantie quant au trajet réel que suivra le message sur l’ensemble des segments réseau. Son périmètre analytique doit être documenté et elle doit rester stable tant qu’elle est en vigueur. Si le fournisseur ou la configuration sous-jacente change, ce changement doit être traité comme une modification de configuration avec une date d’effet et une traçabilité suffisantes. Cela évite que les séries historiques mélangent des décisions différentes sous la même valeur d’étiquette et préserve la capacité à comparer les résultats de manière reproductible au fil du temps opérationnel. La documentation doit préciser la finalité et les limites de chaque code interne utilisé par l’organisation. Seules les équipes qui en ont besoin pour les opérations, l’achat de capacité, l’investigation d’incidents ou le respect d’obligations applicables doivent pouvoir accéder à la correspondance entre le code et l’entité réelle, conformément aux contrôles internes établis. L’étiquette ne doit pas contenir d’identifiants d’accès, de conditions commerciales, d’informations contractuelles ni de données personnelles de contacts. Elle ne doit pas non plus servir à déduire la propriété d’une infrastructure réseau, une qualité garantie ou une couverture effective dans une destination précise. Il s’agit d’une référence analytique relative à la décision logique ; elle doit être interprétée avec les événements observés, les horodatages et le reste du contexte d’envoi afin de tirer des conclusions prudentes. Les changements doivent être consignés avec des responsables clairement identifiés et des éléments documentaires disponibles pour les revues autorisées. Cela facilite les audits et réduit les écarts entre les équipes consultant les mêmes données tout au long de chaque période documentée d’analyse et d’opération interne. La définition doit être réexaminée avant d’étendre son usage à de nouveaux systèmes.
Distinguer les décisions préalables des résultats observés
Une étiquette de décision préalable décrit le contexte disponible avant la transmission du message. Par exemple, use_case=otp, criticality=critical, logical_route=priority_policy et template_version=otp_v3 indiquent comment l’envoi a été classé ou traité lors de sa création.
Un résultat observé est généré après l’envoi : acceptance_state, DLR ou état signalé, failure_class et horodatages. Il est déconseillé d’enregistrer un résultat comme s’il s’agissait d’une caractéristique permanente du message, ou d’utiliser une étiquette préalable pour présumer un résultat ultérieur.
Cette distinction est déterminante pour l’investigation. Si un segment présente des changements dans les états de livraison, il doit être possible de vérifier si la politique de route, la version de modèle, le mix de destinations ou la composition du trafic a changé avant d’attribuer cette évolution à une cause unique.
- Avant l’envoi : use_case, criticality, destination_country, sender_type, origin_channel, campaign_class, logical_route, provider_logical, template_version et taxonomy_version.
- Après l’envoi : acceptance_state, delivery_state ou DLR, failure_class, event_timestamp et les horodatages nécessaires au calcul de la latence.
- Dérivé analytiquement : fenêtres de latence, ratios par segment et classification des résultats incertains.
- Ne pas réécrire la classification d’origine sur la base d’informations obtenues après l’envoi ; ajouter des événements ou champs observés avec leur propre date.
Valeurs contrôlées, noms stables et hiérarchies utiles
Une étiquette n’est utile que si une même valeur conserve le même sens au fil du temps. Les valeurs libres, les abréviations incohérentes et les modifications de définition sans historique réduisent la capacité à comparer les périodes et affaiblissent les éléments de preuve lors d’un incident.
Définissez un dictionnaire pour chaque champ : finalité, responsable, valeurs autorisées, signification, source, date de création, date de retrait et règles de transition. La nomenclature doit être lisible par les machines et les personnes, sans toutefois dépendre de noms temporaires, de campagnes précises ou d’accords commerciaux évolutifs.
Les hiérarchies permettent de conserver le niveau de détail sans sacrifier la comparabilité. Par exemple, use_case peut comporter une famille de premier niveau et un sous-type contrôlé. Si le détail ne modifie pas une décision analytique, il ne mérite pas une nouvelle dimension.
- Utiliser des valeurs au format cohérent, telles que des minuscules et des séparateurs stables : transactional_alert ou consented_marketing.
- Éviter les synonymes parallèles : ne pas mélanger otp, one_time_password et verification_code pour une même signification.
- Conserver une valeur unknown ou unclassified uniquement lorsqu’une politique claire existe pour l’investiguer et la réduire.
- Ajouter de nouvelles valeurs au moyen d’une demande documentée ; ne pas réutiliser une valeur retirée avec une autre signification.
- Versionner le schéma avec taxonomy_version afin d’interpréter correctement les données historiques.
Exemple de schéma pour les OTP, alertes et campagnes avec consentement
L’exemple suivant présente une classification orientée vers les opérations. Il ne prétend pas définir des catégories universelles et ne remplace pas les exigences réglementaires, contractuelles ou de consentement applicables à chaque organisation et destination.
L’essentiel est que les étiquettes reflètent des faits de configuration ou de classification connus de l’émetteur, et non des suppositions sur le destinataire ou des affirmations non vérifiées sur le réseau.
- OTP : use_case=otp ; criticality=critical ; campaign_class=authentication ; template_version=otp_v3 ; origin_channel=api.
- Alerte transactionnelle : use_case=transactional_alert ; criticality=high ; campaign_class=service_notice ; template_version=alert_v2 ; origin_channel=system_event.
- Campagne avec consentement : use_case=marketing ; criticality=standard ; campaign_class=consented_promotion ; template_version=promo_v5 ; origin_channel=portal ou api.
- Dans tous les cas : destination_country avec une valeur normalisée, sender_type applicable, logical_route selon la politique choisie, provider_logical selon la référence interne et taxonomy_version conformément au schéma en vigueur.
Comment analyser l’acceptation, les DLR, la latence et les résultats incertains
Les étiquettes permettent de segmenter les métriques, mais elles ne modifient pas la signification des éléments de preuve. Une acceptation peut indiquer qu’une plateforme ou un segment a admis une demande ; un DLR ou état de livraison représente un rapport dans le cycle technique de transfert SMS. Aucun de ces éléments ne doit, à lui seul, être présenté comme une preuve de lecture humaine, de conversion ou d’action du destinataire.
Pour l’analyse, comparez toujours des segments homogènes. Une baisse des DLR pour des OTP de criticité élevée vers un pays donné et sous une même route logique est plus facile à investiguer qu’une moyenne globale mélangeant campagnes, destinations, types d’expéditeurs et politiques différentes.
La latence nécessite une définition explicite. Documentez les horodatages soustraits, le fuseau horaire de normalisation, les événements éligibles et le traitement des messages qui ne comportent pas d’événement ultérieur dans la fenêtre définie. Les résultats sans DLR ou avec des informations incomplètes doivent rester incertains, et ne pas être automatiquement reclassés comme livrés ou définitivement en échec.
- Analyser acceptance_state par use_case, destination_country, logical_route et sender_type.
- Analyser les DLR ou delivery_state par cohortes utilisant le même modèle, la même version et la même période.
- Calculer la latence uniquement lorsque les horodatages nécessaires sont comparables et présents.
- Séparer failure_class des états inconnus ou en attente.
- Conserver les dénominateurs, la fenêtre d’observation et la version de taxonomie dans chaque rapport.
Segmentation des incidents avec des éléments de preuve reproductibles
Une taxonomie bien conçue transforme un incident générique en une suite de questions vérifiables. Au lieu de se demander uniquement pourquoi les résultats ont baissé, l’équipe peut isoler le moment où le changement a commencé, les populations affectées et les configurations qu’elles partageaient.
La segmentation ne prouve pas à elle seule la causalité. Elle réduit toutefois le champ de l’investigation, permet de confronter les hypothèses aux événements, aux changements documentés et aux données de configuration, et aide à éviter les attributions fondées sur des moyennes trop larges.
Les éléments de preuve doivent conserver la période d’analyse, les filtres appliqués, la version du schéma, les définitions métriques et la source de chaque événement. Ainsi, une autre équipe peut répéter la requête et évaluer la même conclusion.
- Le changement affecte-t-il uniquement un pays ou territoire, ou plusieurs ?
- Se concentre-t-il sur un cas d’usage, une criticité ou une catégorie de campagne ?
- Coïncide-t-il avec une modification de logical_route, provider_logical ou template_version ?
- S’agit-il d’une variation de l’acceptation, des DLR, de la latence ou de la proportion de résultats incertains ?
- La composition du trafic a-t-elle changé, modifiant la comparaison avec la période précédente ?
- Une cause d’échec prédominante est-elle documentée dans les événements disponibles ?
Questions fréquentes
Qu’est-ce qu’une taxonomie d’étiquettes A2P SMS ?
Il s’agit d’un ensemble documenté de champs et de valeurs contrôlées qui classifie les envois A2P SMS afin de les analyser de manière cohérente. Elle peut inclure le cas d’usage, la criticité, le pays de destination, le canal d’origine, la route logique et la version de modèle, entre autres données opérationnelles.
Un DLR positif prouve-t-il que le destinataire a lu le SMS ?
Non. Un DLR est un rapport ou un état au sein de l’architecture de transfert SMS. Il ne prouve ni la lecture humaine, ni l’interaction, ni la conversion, ni aucun autre résultat commercial ultérieur.
Dois-je inclure le numéro de téléphone dans les étiquettes ?
Non, pas en tant qu’étiquette analytique. Le MSISDN complet est une donnée personnelle et ne doit pas être dupliqué dans les étiquettes, les noms de campagnes ou les journaux largement accessibles. Lorsqu’une corrélation est nécessaire, utilisez des identifiants internes protégés et des contrôles d’accès adaptés à la finalité.
Quelle est la différence entre une route logique et une route physique ?
La route logique représente une décision sous le contrôle des opérations, telle qu’un profil ou une politique de sélection. Elle ne doit pas être utilisée pour affirmer un cheminement physique précis ni un opérateur final lorsque cette information n’est pas observée ou ne peut pas être vérifiée.
Comment éviter que la taxonomie se détériore au fil du temps ?
Désignez un responsable, maintenez un dictionnaire de données, contrôlez les valeurs autorisées, versionnez le schéma, consignez les changements et retirez les valeurs obsolètes sans les réutiliser avec une autre signification.
Combien d’étiquettes un envoi doit-il comporter ?
Suffisamment pour répondre aux décisions opérationnelles pertinentes, mais pas au point de fragmenter le trafic en segments sans volume ou de générer une combinaison impossible à maintenir. Commencez par les champs qui expliquent les différences d’usage, de priorité, de destination, d’origine, de décision logique et de version de contenu.
Sources consultées
- 3GPP TS 23.040 — realización técnica del SMS (Release 16)ETSI / 3GPP
- Portal de especificaciones 3GPP — TS 23.0403GPP
- Recomendación E.164 — plan internacional de numeración públicaInternational Telecommunication Union
- NIST SP 800-92 — Guide to Computer Security Log ManagementNational Institute of Standards and Technology
- NIST SP 800-92 Rev. 1 — Cybersecurity Log Management Planning Guide (borrador público)National Institute of Standards and Technology
- Data minimisationInformation Commissioner's Office
- System and network security — evaluación de la información registrada en logsInformation Commissioner's Office