A2P-SMS-Traffic-Tags: So entwerfen Sie eine hilfreiche Taxonomie zur Analyse von Qualität, Kosten und Vorfällen
Eine Taxonomie für A2P-SMS-Tags ermöglicht es, die Versandabsicht von beobachteten Ergebnissen zu trennen, Segmente konsistent zu vergleichen und personenbezogene Daten im Betrieb zu schützen.
Warum Zustellstatus nicht ausreichen
Zustellstatus sind ein relevanter Teil der operativen Evidenz, beschreiben jedoch nicht allein den Kontext einer Sendung. Bei SMS gehören Statusberichte, Übertragungsversuche, bestimmte Fehlerursachen und Wiederholungsversuche im Zusammenhang mit der Verfügbarkeit des Endgeräts zu einem technischen Zyklus mit mehreren möglichen Ergebnissen.
Derselbe aggregierte Status kann je nach Anwendungsfall, Kritikalität, Zielland, Absendertyp, angewendeter Routing-Policy oder Inhaltsversion unterschiedliche operative Auswirkungen haben. Ohne diese Dimensionen kann eine Veränderung bei Annahme, DLR oder Latenz sichtbar sein, ist aber schwer zuzuordnen und zu untersuchen.
Eine Taxonomie für A2P-SMS-Tags liefert diesen Kontext strukturiert. Ihr Ziel ist nicht, technische Ereignisse oder Korrelationskennungen zu ersetzen, sondern sie anhand stabiler, vergleichbarer und auditierbarer Kategorien segmentierbar zu machen.
- OTP-Traffic, transaktionale Benachrichtigungen und einwilligungsbasierte Kampagnen trennen. Die Kennzeichnung consented_marketing dokumentiert dabei nur eine interne Klassifizierung oder einen internen Status und ersetzt keine unabhängigen Einwilligungsprüfungen.
- Kritische von nicht kritischen Nachrichten unterscheiden, um die operative Reaktion zu priorisieren.
- Ergebnisse nach Land oder Gebiet, logischer Routing-Policy und Vorlagenversion vergleichen.
- Verhindern, dass ein aggregierter Rückgang oder eine scheinbare Verbesserung voneinander abweichende Verhaltensweisen zwischen Segmenten verdeckt.
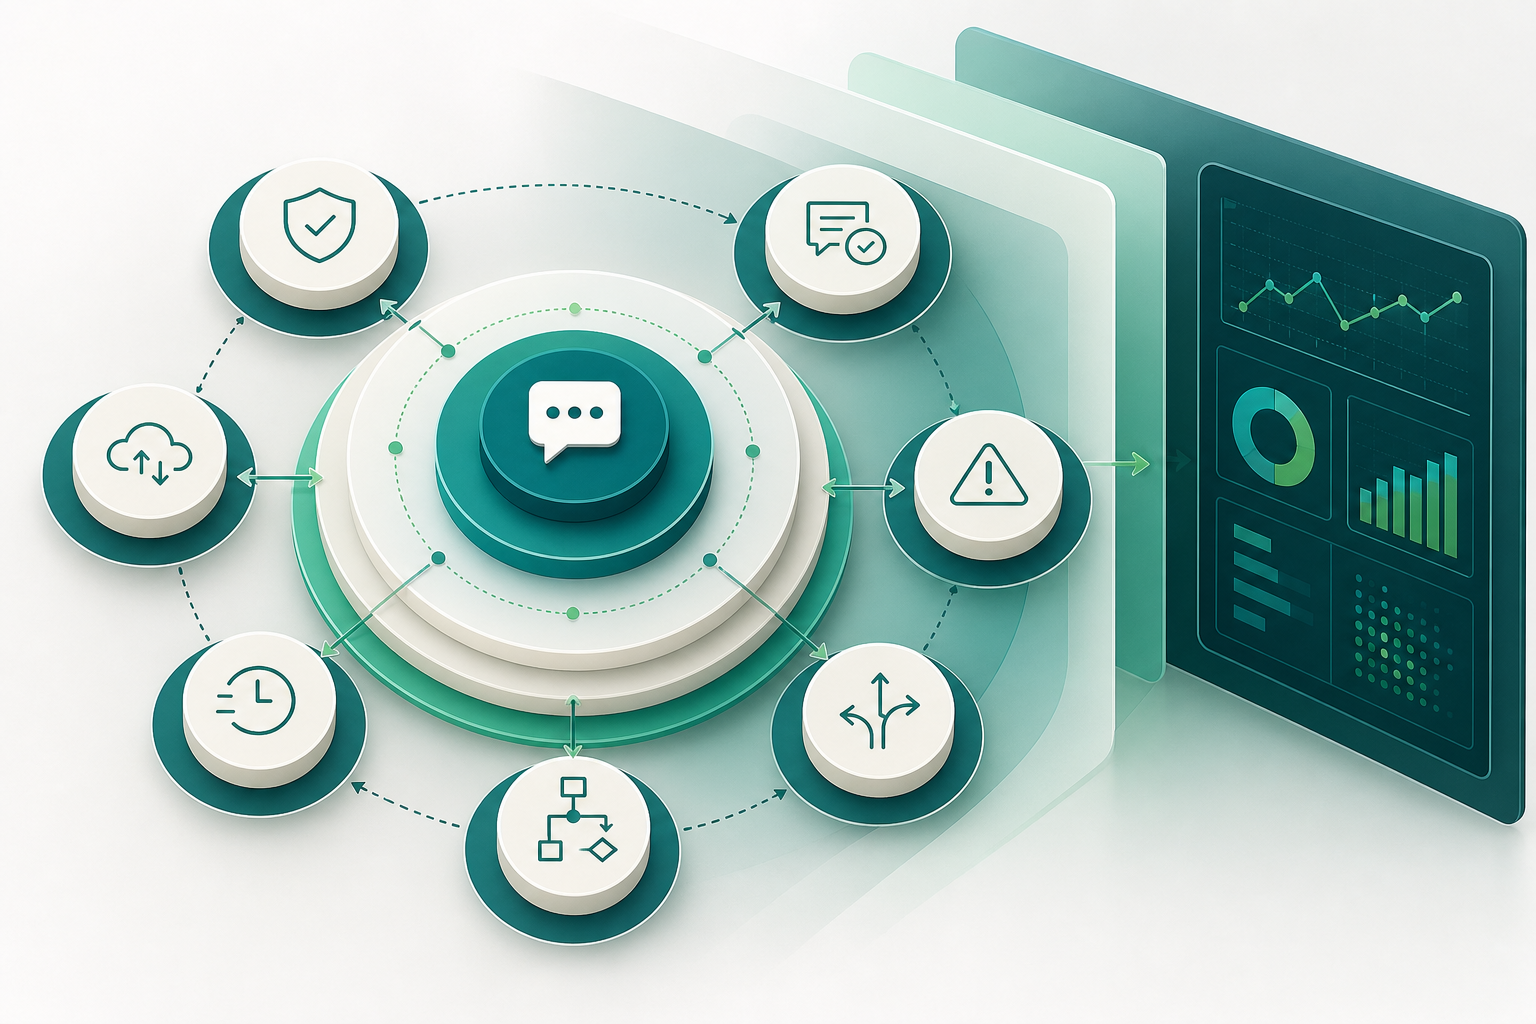
Gestaltungsprinzip: Technische Identität, operative Klassifizierung und personenbezogene Daten sind getrennte Ebenen
Das erste Prinzip besteht darin, drei häufig vermischte Kategorien zu trennen: die technische Identität zur Korrelation von Ereignissen, die operative Klassifizierung zur Analyse des Traffics sowie personenbezogene oder sensible Inhaltsdaten, die minimiert werden müssen.
Die SMS-Architektur nutzt Kennungen und Berichte, um Nachrichten mit technischen Ereignissen zu verknüpfen. Diese Kennungen sind nützlich, um einen konkreten Ablauf zu rekonstruieren, sollten aber nicht zur analytischen Taxonomie werden. Ebenso sind Geschäftskategorien nicht zwingend Teil von Netzkennungen und müssen als plattformeigene Metadaten verwaltet werden.
Die operative Klassifizierung sollte wiederholbare Fragen beantworten: Was sollte gesendet werden, nach welcher Policy wurde der Versand entschieden und mit welchem Segment soll verglichen werden? Personenbezogene Daten hingegen dürfen nicht aus analytischer Bequemlichkeit in Tags aufgenommen werden.
- Technische Identität: interne Nachrichten-ID, Korrelations-ID und geschützte Ereignisreferenzen.
- Klassifizierung vor dem Versand: Anwendungsfall, Kritikalität, Zielland, Absendertyp, Ursprungskanal, Kampagne, logische Route und Vorlagenversion.
- Beobachtetes Ergebnis: Annahme, Status oder DLR, Fehlerursache, Zeitstempel und berechnete Latenz.
- Zu vermeidende Daten: vollständige MSISDN, SMS-Text, OTP, Personenname, Adresse und erkennbare Konto-IDs.
Mindestfelder einer operativen Taxonomie
Der genaue Umfang hängt vom Betriebsmodell ab, doch eine Mindesttaxonomie sollte Segmentierung ermöglichen, ohne eine unbeherrschbare Kombinatorik zu erzeugen. Jedes Feld benötigt einen konkreten Analysezweck, eine definierte Quelle und kontrollierte Werte.
Es empfiehlt sich, Klassifizierungs-Tags zusammen mit dem Sendungsdatensatz zu speichern und beobachtete Ergebnisse als separate Ereignisse oder als Statusfelder mit Zeitstempeln abzulegen. Diese Trennung verhindert, dass eine spätere Beobachtung die ursprüngliche Absicht oder Entscheidung überschreibt.
Ein praktisches Schema kann stabile technische Namen verwenden, vorzugsweise unabhängig von der Sprache der Dashboards. Beispielsweise können use_case oder logical_route als Systemschlüssel beibehalten werden, während ihre Beschreibungen für interne Nutzer übersetzt angezeigt werden.
- use_case: operativer Zweck, etwa otp, transactional_alert oder consented_marketing.
- criticality: geschäftliche oder operative Priorität, zum Beispiel critical, high, standard oder low.
- destination_country: Klassifizierung nach Land oder Gebiet auf Grundlage des internationalen Nummerierungsplans, nicht die vollständige Nummer. Sie beschreibt nicht zwingend den physischen oder aktuellen Aufenthaltsort des Empfängers, etwa bei Portabilität, nicht geografischen Nummernbereichen oder internationalen Routen.
- sender_type: im Betrieb verwendete Klassifizierung des Absenders, etwa alphanumeric, long_number, short_code oder ein anderer für die Umgebung geltender Wert. Verfügbarkeit, Regulierung und Bedeutung können je nach Land und Anbieter variieren.
- origin_channel: System oder Kanal, der den Versand ausgelöst hat, etwa api, smpp, portal oder system_event.
- campaign_class: Klasse zur operativen Gruppierung, etwa lifecycle, service_notice oder consented_promotion; kein freier Name mit Kundeninformationen. Die Klasse belegt nicht für sich allein das Bestehen oder die Gültigkeit einer Einwilligung.
- logical_route: Profil, Policy oder logische Routing-Entscheidung unter Kontrolle des Betriebs.
- provider_logical: stabile interne Referenz auf einen Anbieter oder eine logische Kapazität. Sie beschreibt den logischen Geltungsbereich einer internen Entscheidung, nicht den tatsächlichen physischen Weg, eine garantierte Qualität oder Abdeckung. Die Zuordnung sollte zugriffsgeschützt sein; Änderungen sind mit Wirksamkeitsdatum und nachvollziehbarer Dokumentation zu erfassen. Dies ist eine allgemeine Praxis interner Governance und keine Aussage über eine verfügbare Plattformfunktion.
Entscheidungen vor dem Versand von beobachteten Ergebnissen unterscheiden
Ein Tag für eine Entscheidung vor dem Versand beschreibt den verfügbaren Kontext, bevor die Nachricht übertragen wird. Beispielsweise zeigen use_case=otp, criticality=critical, logical_route=priority_policy und template_version=otp_v3, wie die Sendung bei ihrer Erstellung klassifiziert oder behandelt wurde.
Ein beobachtetes Ergebnis entsteht danach: acceptance_state, DLR oder gemeldeter Status, failure_class und timestamps. Die genaue Bedeutung eines DLR oder Zustellstatus hängt von der Implementierung, dem Anbieter und dem verfügbaren Statuscode ab. Ein Ergebnis sollte nicht erfasst werden, als wäre es eine dauerhafte Eigenschaft der Nachricht; ebenso sollte ein vorheriges Tag nicht genutzt werden, um ein späteres Ergebnis vorauszusetzen.
Diese Unterscheidung ist für Untersuchungen entscheidend. Wenn ein Segment Veränderungen bei Zustellstatus aufweist, muss überprüfbar sein, ob sich die Routing-Policy, die Vorlagenversion, der Zielmix oder die Zusammensetzung des Traffics geändert haben, bevor die Veränderung einer einzigen Ursache zugeschrieben wird.
- Vor dem Versand: use_case, criticality, destination_country, sender_type, origin_channel, campaign_class, logical_route, provider_logical, template_version und taxonomy_version.
- Nach dem Versand: acceptance_state, delivery_state oder DLR, failure_class, event_timestamp und die zur Berechnung der Latenz erforderlichen timestamps.
- Analytisch abgeleitet: Latenzfenster, Kennzahlen je Segment und Klassifizierung unsicherer Ergebnisse.
- Die ursprüngliche Klassifizierung nicht mit nach dem Versand gewonnenem Wissen überschreiben; Ereignisse oder beobachtete Felder mit eigenem Datum ergänzen.
Kontrollierte Werte, stabile Namen und hilfreiche Hierarchien
Ein Tag ist nur nützlich, wenn derselbe Wert im Zeitverlauf dieselbe Bedeutung hat. Freie Werte, inkonsistente Abkürzungen und Definitionsänderungen ohne Historie verringern die Vergleichbarkeit von Zeiträumen und schwächen die Evidenz während eines Vorfalls.
Definieren Sie für jedes Feld ein Wörterbuch: Zweck, Verantwortlicher, zulässige Werte, Bedeutung, Quelle, Einführungsdatum, Ausmusterungsdatum und Übergangsregeln. Die Benennung sollte maschinen- und menschenlesbar sein, aber nicht von temporären Namen, konkreten Kampagnen oder veränderlichen Handelsvereinbarungen abhängen.
Hierarchien helfen, Detailgrad zu bewahren, ohne die Vergleichbarkeit zu beeinträchtigen. Beispielsweise kann use_case eine Familie der obersten Ebene und einen kontrollierten Untertyp haben. Wenn ein Detail keine analytische Entscheidung verändert, verdient es keine neue Dimension.
- Werte in konsistentem Format verwenden, etwa Kleinbuchstaben und stabile Trennzeichen: transactional_alert oder consented_marketing.
- Parallele Synonyme vermeiden: Für dieselbe Bedeutung nicht otp, one_time_password und verification_code mischen.
- Einen Wert unknown oder unclassified nur beibehalten, wenn es eine klare Policy gibt, ihn zu untersuchen und seinen Anteil zu verringern.
- Neue Werte über einen dokumentierten Antrag hinzufügen; einen ausgemusterten Wert nicht mit anderer Bedeutung wiederverwenden.
- Das Schema mit taxonomy_version versionieren, um historische Daten korrekt zu interpretieren.
Beispielschema für OTP, Benachrichtigungen und einwilligungsbasierte Kampagnen
Das folgende Beispiel zeigt eine auf den Betrieb ausgerichtete Klassifizierung. Es soll keine universellen Kategorien definieren und ersetzt weder regulatorische, vertragliche noch einwilligungsbezogene Anforderungen, die für die jeweilige Organisation und das Zielgebiet gelten.
Entscheidend ist, dass die Tags Tatsachen der Konfiguration oder Klassifizierung widerspiegeln, die dem Absender bekannt sind, und keine Annahmen über den Empfänger oder nicht überprüfte Aussagen über das Netz enthalten.
- OTP: use_case=otp; criticality=critical; campaign_class=authentication; template_version=otp_v3; origin_channel=api.
- Transaktionale Benachrichtigung: use_case=transactional_alert; criticality=high; campaign_class=service_notice; template_version=alert_v2; origin_channel=system_event.
- Einwilligungsbasierte Kampagne: use_case=marketing; criticality=standard; campaign_class=consented_promotion; template_version=promo_v5; origin_channel=portal oder api. Diese Klassifizierung ersetzt keine unabhängigen Kontrollen der Einwilligung.
- In allen Fällen: destination_country mit normalisiertem Wert auf Grundlage des Nummerierungsplans, anwendbarer sender_type, logical_route gemäß gewählter Policy, provider_logical gemäß interner Referenz und taxonomy_version entsprechend dem gültigen Schema.
Annahme, DLR, Latenz und unsichere Ergebnisse analysieren
Tags ermöglichen die Segmentierung von Metriken, verändern aber nicht die Bedeutung der Evidenz. Eine Annahme kann bedeuten, dass eine Plattform oder ein Abschnitt eine Anfrage angenommen hat; ein DLR oder Zustellstatus stellt je nach Implementierung, Anbieter und verfügbarem Statuscode einen Bericht innerhalb des technischen SMS-Übertragungszyklus dar. Keines davon darf für sich allein als Nachweis menschlichen Lesens, einer Konversion oder einer Aktion des Empfängers dargestellt werden.
Vergleichen Sie bei Analysen stets homogene Segmente. Ein Rückgang der DLR bei OTP mit kritischer Kritikalität in ein bestimmtes Land und unter derselben logischen Route ist besser untersuchbar als ein globaler Durchschnitt, der Kampagnen, Ziele, Absendertypen und unterschiedliche Policies vermischt.
Latenz benötigt eine explizite Definition. Dokumentieren Sie, welche Zeitstempel voneinander abgezogen werden, auf welche Zeitzone sie normalisiert werden, welche Ereignisse zulässig sind und wie Nachrichten behandelt werden, die innerhalb des festgelegten Fensters kein nachgelagertes Ereignis aufweisen. Ergebnisse ohne DLR oder mit unvollständigen Informationen müssen als unsicher erhalten bleiben und dürfen nicht automatisch als Zustellung oder endgültiger Fehler umklassifiziert werden.
- acceptance_state nach use_case, destination_country, logical_route und sender_type analysieren.
- DLR oder delivery_state nach Kohorten mit derselben Vorlage, Version und demselben Zeitraum analysieren.
- Latenz nur berechnen, wenn die erforderlichen Zeitstempel vergleichbar und vorhanden sind.
- failure_class von unbekannten oder ausstehenden Status trennen.
- In jedem Bericht Nenner, Beobachtungsfenster und Taxonomieversion beibehalten.
Segmentierung von Vorfällen mit reproduzierbarer Evidenz
Eine gut gestaltete Taxonomie verwandelt einen allgemeinen Vorfall in eine Abfolge überprüfbarer Fragen. Statt nur zu fragen, warum die Ergebnisse zurückgegangen sind, kann das Team eingrenzen, wann die Veränderung begann, welche Populationen betroffen waren und welche Konfigurationen sie gemeinsam hatten.
Segmentierung beweist für sich genommen keine Kausalität. Sie verringert jedoch den Untersuchungsraum, ermöglicht den Abgleich von Hypothesen mit Ereignissen, dokumentierten Änderungen und Konfigurationsdaten und hilft, Zuschreibungen auf Basis zu breit gefasster Durchschnittswerte zu vermeiden.
Die Evidenz muss den Analysezeitraum, die angewandten Filter, die Schemaversion, die Metrikdefinitionen und die Quelle jedes Ereignisses enthalten. So kann ein anderes Team dieselbe Abfrage wiederholen und dieselbe Schlussfolgerung bewerten.
- Betrifft die Veränderung nur ein Land oder Gebiet oder mehrere?
- Konzentriert sie sich auf einen Anwendungsfall, eine Kritikalität oder eine Kampagnenklasse?
- Fällt sie mit einer Änderung von logical_route, provider_logical oder template_version zusammen?
- Handelt es sich um eine Veränderung bei Annahme, DLR, Latenz oder dem Anteil unsicherer Ergebnisse?
- Hat sich die Zusammensetzung des Traffics verändert und den Vergleich mit dem vorherigen Zeitraum beeinflusst?
- Gibt es eine in den verfügbaren Ereignissen dokumentierte vorherrschende Fehlerursache?
Häufige Fragen
Was ist eine Taxonomie für A2P-SMS-Tags?
Sie ist ein dokumentierter Satz aus Feldern und kontrollierten Werten, der A2P-SMS-Sendungen für eine konsistente Analyse klassifiziert. Sie kann unter anderem Anwendungsfall, Kritikalität, Zielland, Ursprungskanal, logische Route und Vorlagenversion enthalten.
Beweist ein positiver DLR, dass der Empfänger die SMS gelesen hat?
Nein. Ein DLR ist je nach Implementierung, Anbieter und verfügbarem Statuscode ein Bericht oder Status innerhalb der SMS-Übertragungsarchitektur. Er belegt weder menschliches Lesen noch Interaktion, Konversion oder ein anderes nachgelagertes kommerzielles Ergebnis.
Sollte ich die Telefonnummer in Tags aufnehmen?
Nein, nicht als analytisches Tag. Eine vollständige MSISDN kann ein personenbezogenes Datum sein, wenn sie eine Person identifiziert oder identifizierbar macht, und sollte nicht in Tags, Kampagnennamen oder breit zugänglichen Logs dupliziert werden. Wenn eine Korrelation erforderlich ist, verwenden Sie geschützte interne Kennungen und Zugriffskontrollen, die dem Zweck angemessen sind.
Was ist der Unterschied zwischen einer logischen und einer physischen Route?
Die logische Route stellt eine Entscheidung dar, die unter Kontrolle des Betriebs steht, etwa ein Auswahlprofil oder eine Policy. Sie darf nicht genutzt werden, um einen konkreten physischen Weg oder einen finalen Betreiber zu behaupten, wenn diese Information nicht beobachtet oder nicht überprüft werden kann.
Wie lässt sich verhindern, dass die Taxonomie mit der Zeit an Qualität verliert?
Weisen Sie einen Verantwortlichen zu, pflegen Sie ein Datenwörterbuch, kontrollieren Sie zulässige Werte, versionieren Sie das Schema, protokollieren Sie Änderungen und mustern Sie veraltete Werte aus, ohne sie mit einer anderen Bedeutung wiederzuverwenden.
Wie viele Tags sollte eine Sendung haben?
Genug, um relevante operative Entscheidungen zu unterstützen, aber nicht so viele, dass der Traffic in volumenarme Segmente zerfällt oder eine nicht wartbare Kombination entsteht. Beginnen Sie mit den Feldern, die Unterschiede bei Nutzung, Priorität, Ziel, Ursprung, logischer Entscheidung und Inhaltsversion erklären.
Verwendete Quellen
- 3GPP TS 23.040 — realización técnica del SMS (Release 16)ETSI / 3GPP
- Portal de especificaciones 3GPP — TS 23.0403GPP
- Recomendación E.164 — plan internacional de numeración públicaInternational Telecommunication Union
- NIST SP 800-92 — Guide to Computer Security Log ManagementNational Institute of Standards and Technology
- NIST SP 800-92 Rev. 1 — Cybersecurity Log Management Planning Guide (borrador público)National Institute of Standards and Technology
- Data minimisationInformation Commissioner's Office
- System and network security — evaluación de la información registrada en logsInformation Commissioner's Office