Dare priorità al traffico SMS A2P quando la capacità si riduce
Una guida operativa per distinguere OTP, avvisi e notifiche, assegnare priorità interne e gestire la congestione senza confondere la priorità con una consegna garantita.
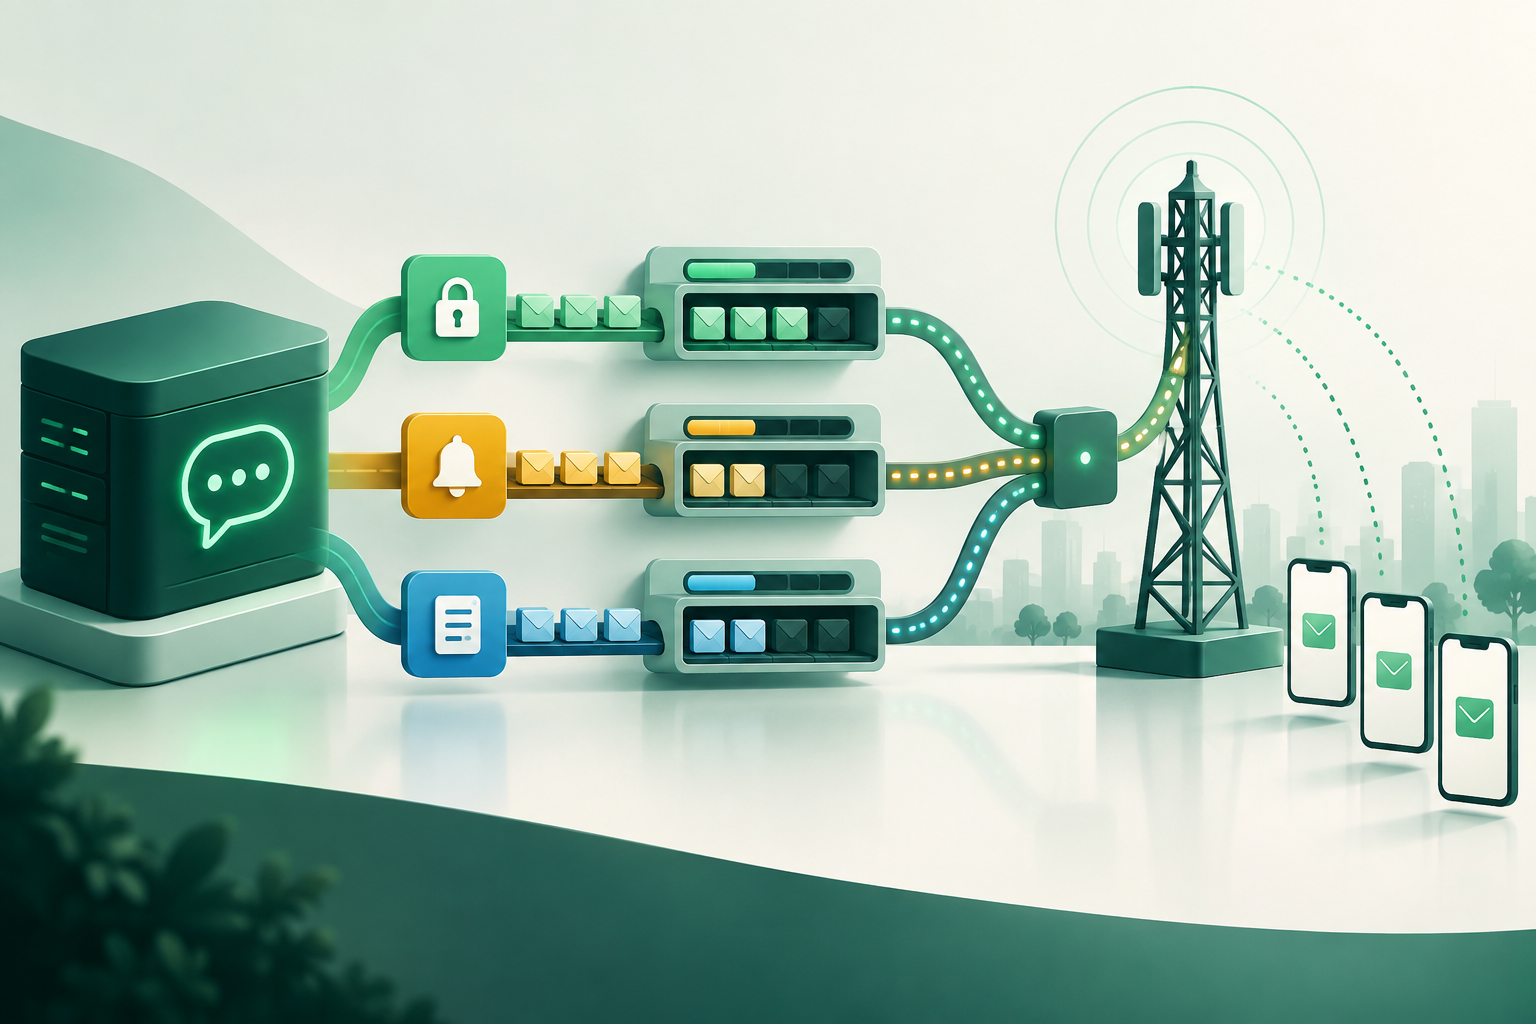
Perché una coda condivisa può penalizzare i flussi critici
Se messaggi destinati a usi diversi condividono una coda e lo stesso limite di invio, un picco di traffico non urgente può assorbire risorse necessarie anche ai messaggi sensibili al fattore tempo. Separare i flussi può aiutare a controllare come vengono accettati ed elaborati nei sistemi gestiti dall’organizzazione.
La separazione è una scelta operativa, non una garanzia di precedenza lungo l’intera catena. Il percorso, i sistemi intermedi e la rete mobile possono applicare i propri controlli. Una priorità interna non assicura che un messaggio arrivi prima né che venga ricevuto sul terminale.
- Individua i punti in cui esiste una coda condivisa: applicazione, piattaforma di messaggistica, connessione con il fornitore o altri componenti sotto il tuo controllo.
- Registra i limiti e le politiche configurati in ogni segmento e quelli che dipendono da terzi.
- Non promettere al team di prodotto o al business una consegna prioritaria end-to-end se non è stata dimostrata e concordata per il percorso utilizzato.
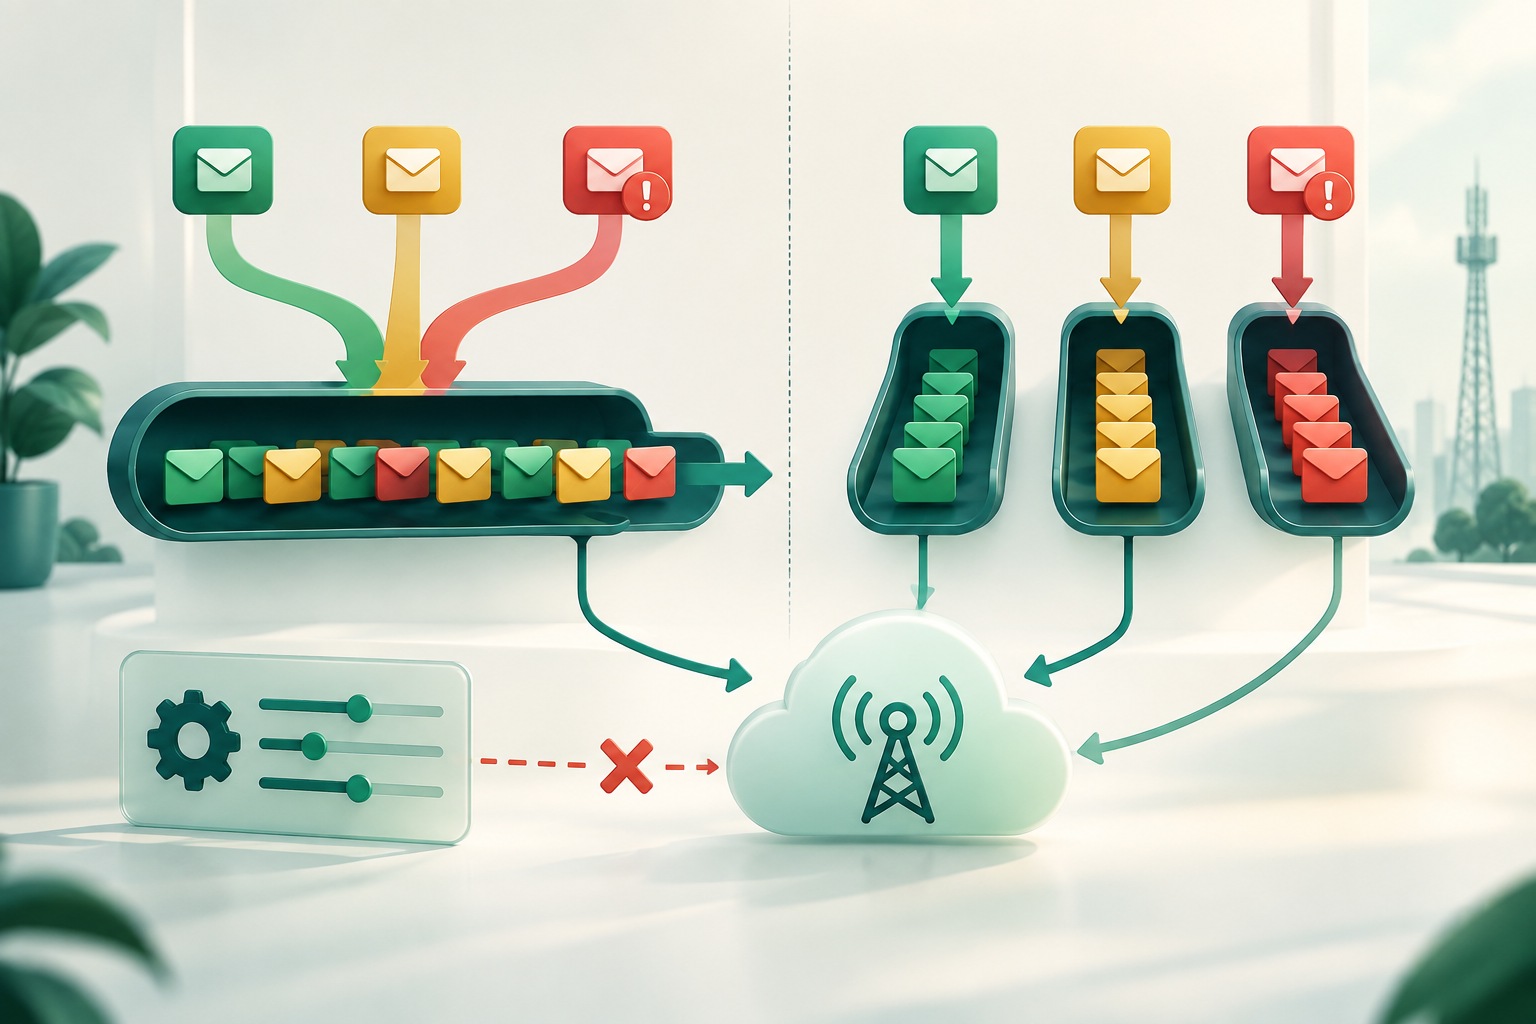
Scopo, criticità e priorità operativa sono concetti distinti
Lo scopo descrive perché viene inviato il messaggio: per esempio, autenticare un’operazione tramite OTP, segnalare un avviso o inviare una notifica transazionale. La criticità indica l’impatto che un ritardo o la mancata ricezione tempestiva avrebbe per l’utente. La priorità operativa determina il trattamento del flusso nei sistemi controllati dal mittente.
Queste dimensioni non vanno confuse con una classificazione normativa. La classificazione interna serve a gestire la capacità; da sola non stabilisce se un messaggio è consentito, se esiste un consenso valido o quali requisiti legali si applicano. Verifica separatamente tali obblighi in base al caso e alla giurisdizione.
- Etichetta ogni flusso in base al suo effettivo scopo ed evita categorie vaghe come «urgente» senza una definizione verificabile.
- Valuta la criticità considerando l’impatto del ritardo, il periodo di validità del messaggio e la possibilità di completare l’operazione tramite un altro canale.
- Tieni separati i controlli sul consenso, sui contenuti e sulla conformità dalla priorità operativa.
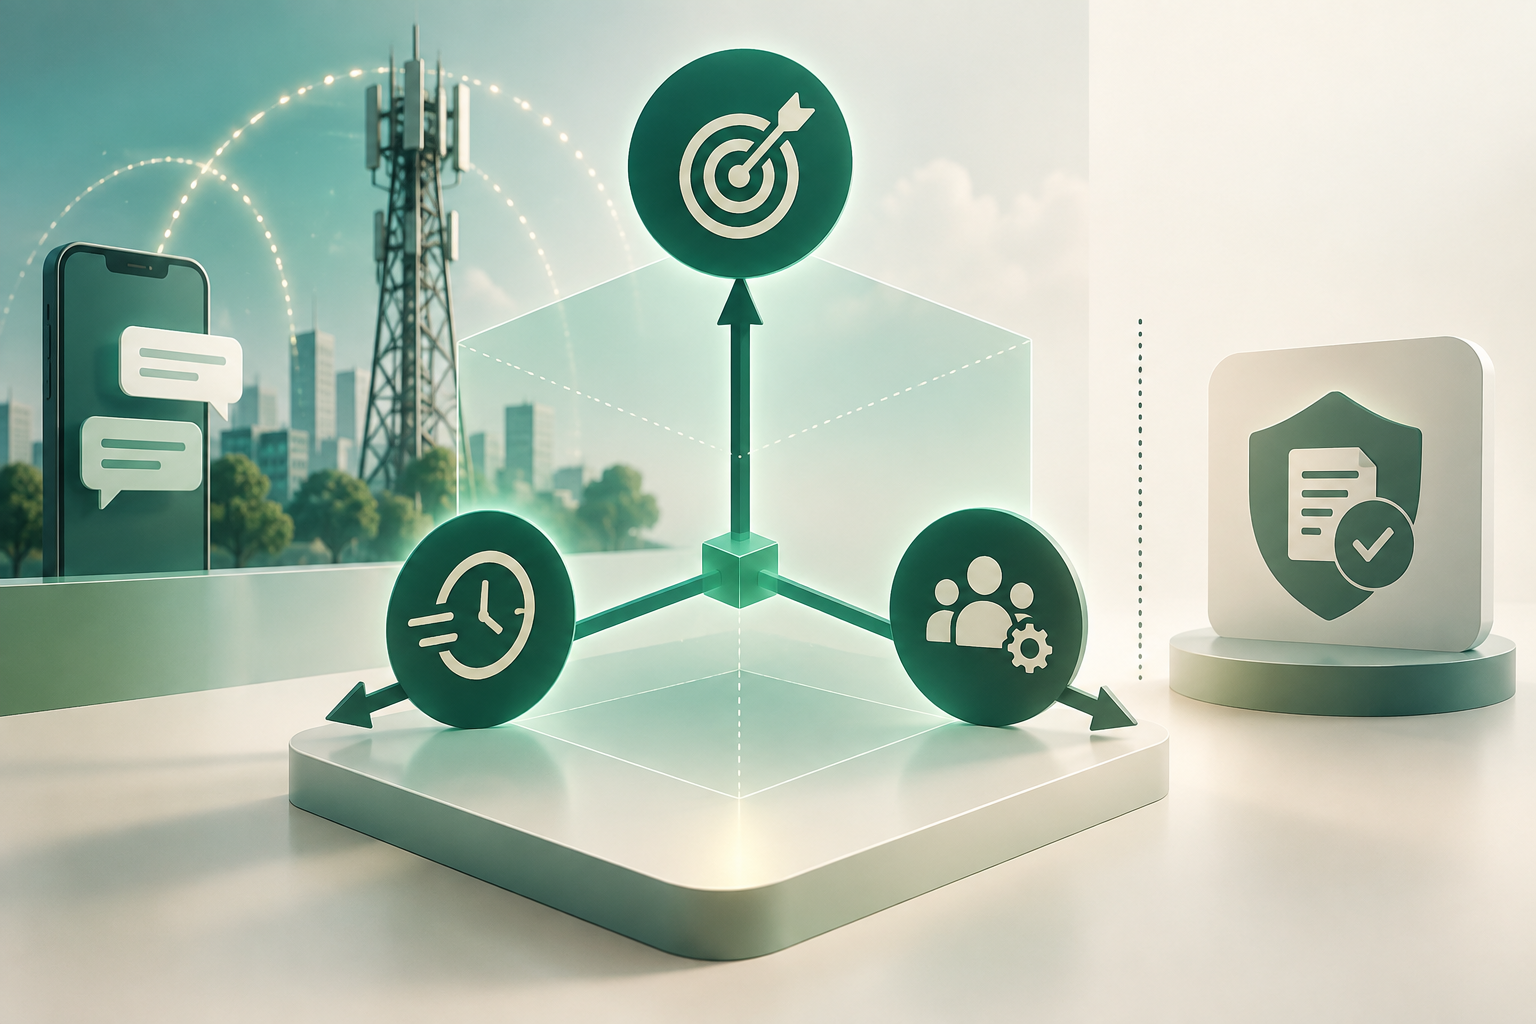
Definisci classi di servizio con criteri verificabili
Una classe di servizio è utile solo se le sue regole possono essere spiegate e misurate. Invece di assegnare priorità a intuito, concorda i criteri con i team operativi e di prodotto e con i responsabili del servizio: impatto per l’utente, scadenza funzionale, volume previsto e possibilità di recupero.
Per esempio, un OTP può perdere utilità una volta scaduta la richiesta di autenticazione. Un avviso può richiedere attenzione rapida, anche se l’urgenza dipende dall’evento. Una notifica informativa può forse essere posticipata. Sono esempi utili a progettare una politica interna, non una classificazione universale né una raccomandazione normativa.
- Documenta l’obiettivo di ogni classe e i servizi che possono rientrarvi.
- Definisci cosa significa, dal punto di vista dell’applicazione, che un messaggio è scaduto; non presumere che il termine si applichi automaticamente a tutti i componenti del percorso.
- Stabilisci se un messaggio in ritardo ha ancora valore o se debba essere annullato, sostituito oppure gestito tramite una procedura alternativa.
- Stabilisci chi può autorizzare le eccezioni e come vengono riesaminate.
Isola le code e controlla il consumo di capacità
L’isolamento può ridurre la competizione diretta tra flussi nei componenti gestiti dal team. L’implementazione concreta dipende dall’architettura disponibile: non presumere che una connessione, un’interfaccia o un fornitore offrano code indipendenti o priorità effettive senza averlo verificato.
Definisci limiti per flusso e una capacità riservata o condivisa in base agli accordi e ai controlli tecnici realmente disponibili. Un limite progettato male può anche lasciare capacità inutilizzata o bloccare traffico importante; per questo va convalidato con dati propri e riesaminato sia in condizioni normali sia degradate.
- Separa le code per scopo o classe solo quando il sistema consente di controllarne l’accettazione e l’elaborazione.
- Limita il volume dei flussi posticipabili affinché un picco non penalizzi senza controllo gli altri.
- Assicurati che i limiti tengano conto della capacità effettiva nota in ogni segmento, senza presumere che la capacità configurata localmente coincida con quella accettata dalla rete.
- Documenta cosa accade ai messaggi in attesa quando la capacità viene ripristinata.
Definisci accettazione, posticipo e scarto prima della congestione
Quando il carico supera la capacità disponibile, il sistema ha bisogno di regole esplicite per decidere cosa accettare, cosa trattenere e cosa non ritrasmettere. Senza una politica concordata, componenti diversi possono accumulare messaggi, ripetere i tentativi o conservare traffico che ha già perso utilità.
Le regole devono essere coerenti con la scadenza funzionale, i limiti effettivi della piattaforma e gli obblighi applicabili. Lo scarto deve essere intenzionale e tracciabile; non va presentato come una soluzione automatica valida per tutti i casi.
- Stabilisci quali classi possono essere posticipate e a quali condizioni si interrompe l’accettazione di nuovi messaggi.
- Definisci quando annullare i messaggi scaduti o duplicati e come comunicare l’esito all’applicazione che li ha originati.
- Evita di creare arretrati la cui anzianità superi il periodo di utilità del contenuto.
- Registra le decisioni di rifiuto, posticipo e scarto con una causa identificabile, così da poterle analizzare.
Coordina priorità, TPS, backpressure e nuovi tentativi
La priorità interna deve convivere con i limiti di velocità, i segnali di controllo del carico e le politiche di nuovo tentativo esistenti. Non aumentare indiscriminatamente la velocità di invio né ripetere le richieste per recuperare un ritardo: a seconda del comportamento dell’applicazione e dei componenti coinvolti, potresti amplificare il carico o generare duplicati.
Verifica nella documentazione di ogni interfaccia quali risposte, limiti e meccanismi di controllo sono disponibili. Le informazioni tecniche disponibili qui non consentono di affermare un comportamento universale per i campi SMPP, il TPS, la scadenza o gli stati di consegna; configura ogni integrazione seguendo la documentazione tecnica e contrattuale vigente.
- Assegna limiti di invio per connessione o destinazione solo se sono confermati per l’integrazione specifica.
- Allinea i nuovi tentativi alle risposte osservate, alla scadenza del messaggio e alle misure di protezione dai duplicati.
- Rispetta i segnali di backpressure esposti da ciascun componente; non sostituirli con un aumento automatico della velocità.
- Prova le modifiche in un ambiente controllato prima di applicarle al traffico di produzione.
Misura ogni classe senza confondere accettazione, DLR e ricezione
L’accettazione di una richiesta da parte di un’interfaccia indica un esito in quel punto della catena; da sola non equivale alla ricezione sul terminale. Un DLR è un rapporto di stato il cui significato e la cui coerenza dipendono dal percorso e dall’integrazione. Non presentarlo come prova indipendente del fatto che una persona abbia visto il messaggio.
Analizza gli indicatori per classe e destinazione quando i dati sono disponibili e confrontabili. Interpreta latenza, disponibilità e stati di consegna insieme alle relative definizioni, finestre di misurazione e limitazioni di osservabilità.
- Tieni distinti le richieste accettate, i rifiuti, gli stati di consegna riportati e le eventuali verifiche indipendenti disponibili.
- Osserva il tempo tra la richiesta e gli eventi successivi, specificando quali punti della catena include la misurazione.
- Esamina per classe i messaggi in sospeso, scaduti, duplicati e sottoposti a nuovi tentativi.
- Non confrontare metriche tra percorsi o periodi senza verificare che definizioni e fonti siano equivalenti.
Prova la gestione del degrado e documenta il ripristino
Una politica di priorità richiede test che riproducano i rischi rilevanti per la propria architettura. Simula carichi elevati, ritardi, rifiuti e un ripristino graduale solo in ambienti autorizzati e in modo da non coinvolgere gli utenti né le reti esterne.
Prima di attivare una politica, concorda i responsabili, i criteri di ingresso e uscita dalla modalità degradata, le eccezioni e la procedura di rollback. Conserva un registro delle modifiche per poter spiegare quali flussi sono stati limitati e perché.
- Verifica che, all’aumentare del carico, il traffico posticipabile non assorba tutta la capacità controllabile.
- Assicurati che i messaggi trattenuti non vengano inviati quando hanno ormai perso utilità.
- Verifica il comportamento dei nuovi tentativi, dei duplicati e delle notifiche ai sistemi di origine.
- Definisci chi può modificare limiti e priorità, chi approva le eccezioni e come ripristinare la configurazione precedente.
- Esamina i risultati insieme ai team operativi e di architettura, al team di prodotto e ai responsabili della conformità.
Domande frequenti
Dare priorità a un OTP garantisce che arrivi prima?
No. Una priorità configurata internamente può influire solo sui componenti in cui viene applicata e controllata. Non dimostra che il messaggio abbia precedenza lungo l’intero percorso, che venga ricevuto sul terminale o che arrivi entro un determinato intervallo.
OTP, avvisi e notifiche sono classi normative?
Non va dato per scontato. In questa guida sono esempi di scopi di messaggistica che possono essere utili per progettare classi operative. Gli obblighi normativi e relativi al consenso devono essere valutati separatamente, in base al contenuto e al contesto applicabile.
Quali metriche confermano che un SMS è stato ricevuto sul telefono?
L’accettazione di una richiesta e un DLR non vanno automaticamente confusi con una verifica indipendente della ricezione sul terminale. Verifica cosa rappresenta ogni stato nell’integrazione e comunica chiaramente l’incertezza.
Come si sceglie un limite di invio per ciascuna classe?
Qui non è possibile indicare un valore universale. Basa il limite sulla capacità effettivamente confermata per la tua piattaforma e per ogni integrazione, definisci come si comporta in condizioni di backpressure e convalida la politica con test controllati e dati propri.
È opportuno ritentare tutto il traffico posticipato quando la capacità viene ripristinata?
Non necessariamente. Prima di ritentare, verifica se il messaggio è ancora utile, se è scaduto o è già stato elaborato e quale politica di gestione dei duplicati si applica. I nuovi tentativi devono rispettare la documentazione dell’interfaccia e i limiti esistenti.
Fonti consultate
- SMPP v3.4 Issue 1.2SMPP Developers Forum
- RFC 9110: HTTP SemanticsIETF
- 3GPP specifications by series3GPP
- ITU-T Recommendation E.164International Telecommunication Union
- GSMA networks resourcesGSMA