Betriebskontinuität bei A2P-SMS: RTO, RPO und Verkehrsprioritäten
Praxisleitfaden für die Gestaltung eines A2P-SMS-Betriebskontinuitätsplans: RTO und RPO definieren, Traffic klassifizieren, Wiederholungsversuche steuern und technische Redundanz von bestätigter Zustellung unterscheiden.
Welches Problem ein Betriebskontinuitätsplan für A2P-SMS löst
Ein A2P-SMS-Betriebskontinuitätsplan legt fest, wie Messaging-Prozesse nach einer Unterbrechung aufrechterhalten oder wiederhergestellt werden. Er enthält vorab genehmigte Entscheidungen darüber, welcher Traffic weiterlaufen darf, welcher warten muss und für welche Kommunikationen ein alternatives Verfahren erforderlich ist. Er ist nicht nur ein Dokument zur technischen Umschaltung: Er koordiniert Prozesse, Personen, Daten, Kontrollen und Kommunikation.
Bei A2P-SMS beschränkt sich das Problem nicht darauf, ob eine SMPP- oder HTTP-Verbindung verfügbar ist. Ein Dienst kann Sendeanfragen annehmen und dennoch keinen endgültigen Zustellnachweis haben. Außerdem können Callbacks verloren gehen, DLRs verspätet eintreffen oder Unsicherheit über Nachrichten bestehen, die vor einem Ausfall übermittelt wurden. Der Plan muss diese Situationen trennen, damit aus einer teilweisen Wiederherstellung kein Zustellversprechen wird.
Ausgangspunkt ist der Geschäftsprozess. Ein OTP mit kurzer Gültigkeitsdauer, eine transaktionale Warnmeldung, eine betriebliche Benachrichtigung und eine einwilligungsbasierte Marketingkampagne können bei demselben Vorfall völlig unterschiedliche Entscheidungen erfordern.
- Festlegen, welche Geschäftsprozesse von SMS abhängen und wer sie verantwortet.
- Auswirkungen bewerten, wenn jeder Nachrichtentyp verspätet, doppelt, gar nicht oder erneut gesendet wird.
- Technische Verantwortliche und Verantwortliche für Geschäftsentscheidungen festlegen.
- Dokumentieren, wie der Nachweis für jede Nachricht während und nach dem Notfall erhalten bleibt.
RTO und RPO im Messaging: Was sie bedeuten und was sie nicht versprechen können
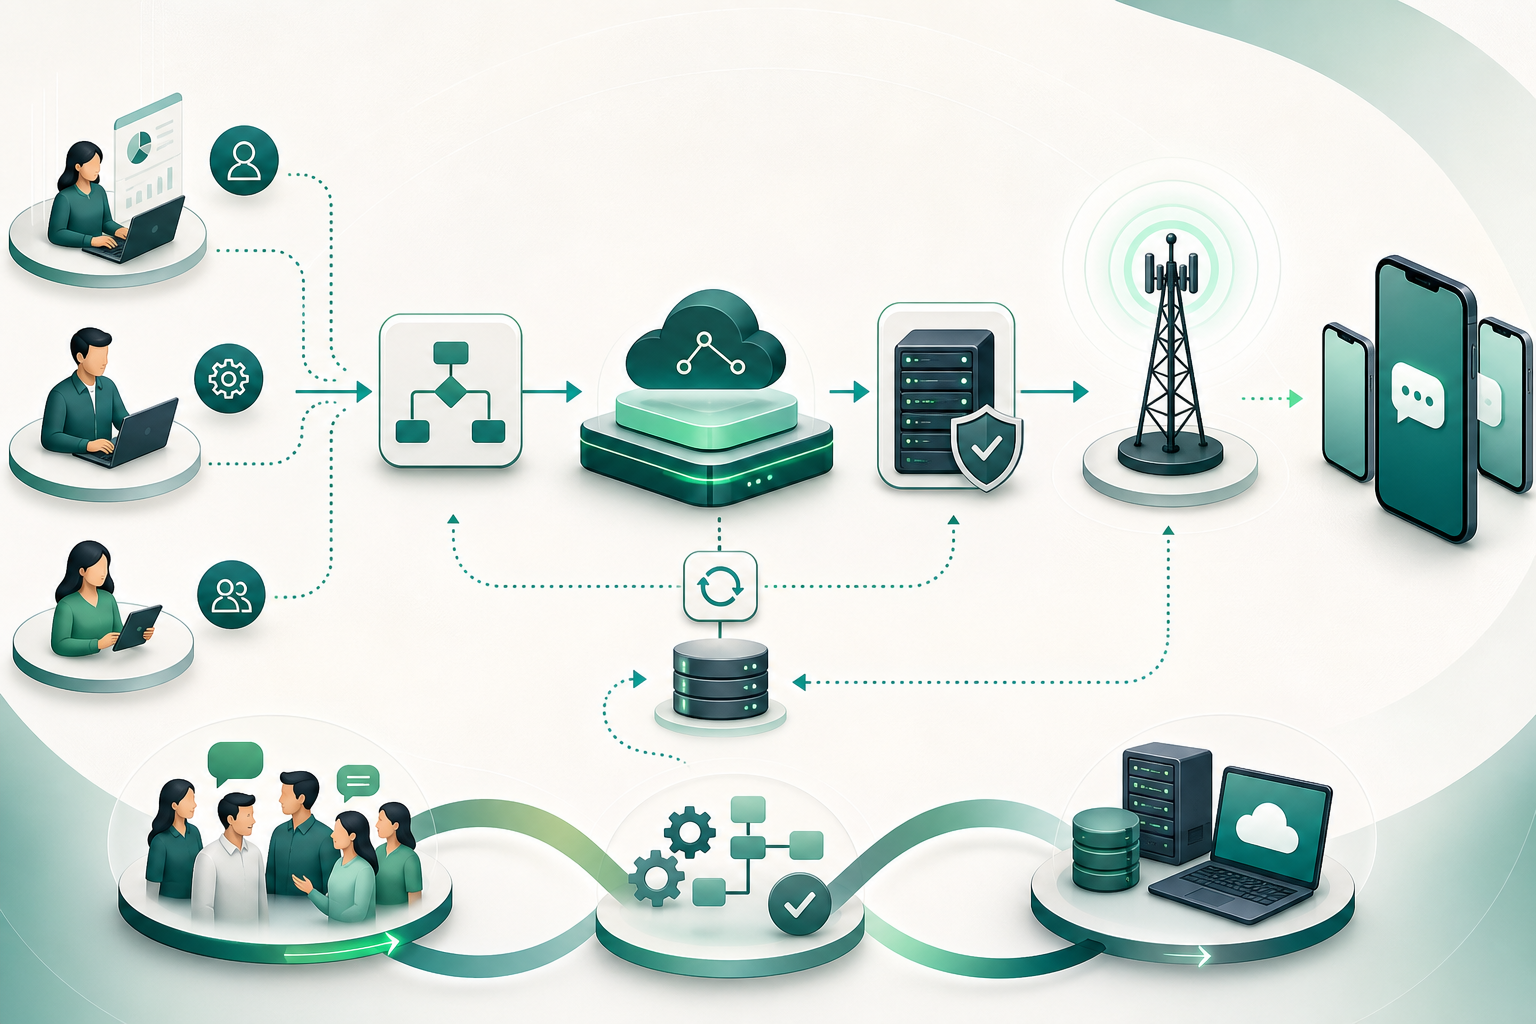
Der RTO, also das Wiederherstellungszeitziel, ist die maximale Zeit, während der eine Ressource nicht verfügbar sein darf, bevor die Auswirkungen auf die unterstützten Prozesse nicht mehr akzeptabel sind. Bei einem A2P-SMS-Dienst sollte er pro Fähigkeit oder Prozess definiert werden: etwa für die Annahme von Anfragen, die Generierung einer internen ID, die Übergabe an einen Anbieter, den Empfang von Callbacks oder die Abstimmung von Statusinformationen.
Der RPO, also das Wiederherstellungspunktziel, legt fest, bis zu welchem Zeitpunkt vor der Unterbrechung Daten wiederherstellbar sein müssen. Im Messaging besteht der relevante Datensatz nicht nur aus dem SMS-Inhalt. Er umfasst die Sendeabsicht, die Traffic-Klasse, die interne ID, den verwendeten Absender, die Zeit, die DLR-Anforderung, die Annahmeantwort, die vom SMSC vergebene ID, sofern vorhanden, sowie nachfolgende Ereignisse.
Weder RTO noch RPO garantieren, dass eine SMS das Endgerät erreicht. Der RTO betrifft die Wiederherstellung einer Betriebsfähigkeit; der RPO begrenzt den Verlust von Daten oder Statusinformationen. Die endgültige Zustellbarkeit hängt von nachfolgenden Statusinformationen und Bestätigungen ab, die getrennt bewertet werden müssen.
Der RTO muss innerhalb der maximal tolerierbaren Unterbrechungszeit Spielraum lassen. Wenn Nachrichten erneut verarbeitet, Status abgefragt oder Duplikate geprüft werden müssen, bevor der Betrieb wieder aufgenommen wird, verbraucht auch dies die verfügbare Zeit.
- RTO für Annahme: Zeitraum bis zur kontrollierten erneuten Annahme von Traffic.
- RTO für Versand: Zeitraum bis zur erneuten Übergabe autorisierten Traffics an verfügbare Konnektivität.
- RTO für Beobachtbarkeit: Zeitraum bis zur Wiederherstellung von Protokollen, Callbacks, Abfragen und Warnmeldungen.
- RPO für Sendeabsicht: maximal tolerierbarer Verlust erfasster Anfragen.
- RPO für Status: maximal tolerierbarer Verlust von Statusänderungen, IDs und Notfallentscheidungen.
Abhängigkeitsinventar: Planen Sie nicht nur die Route
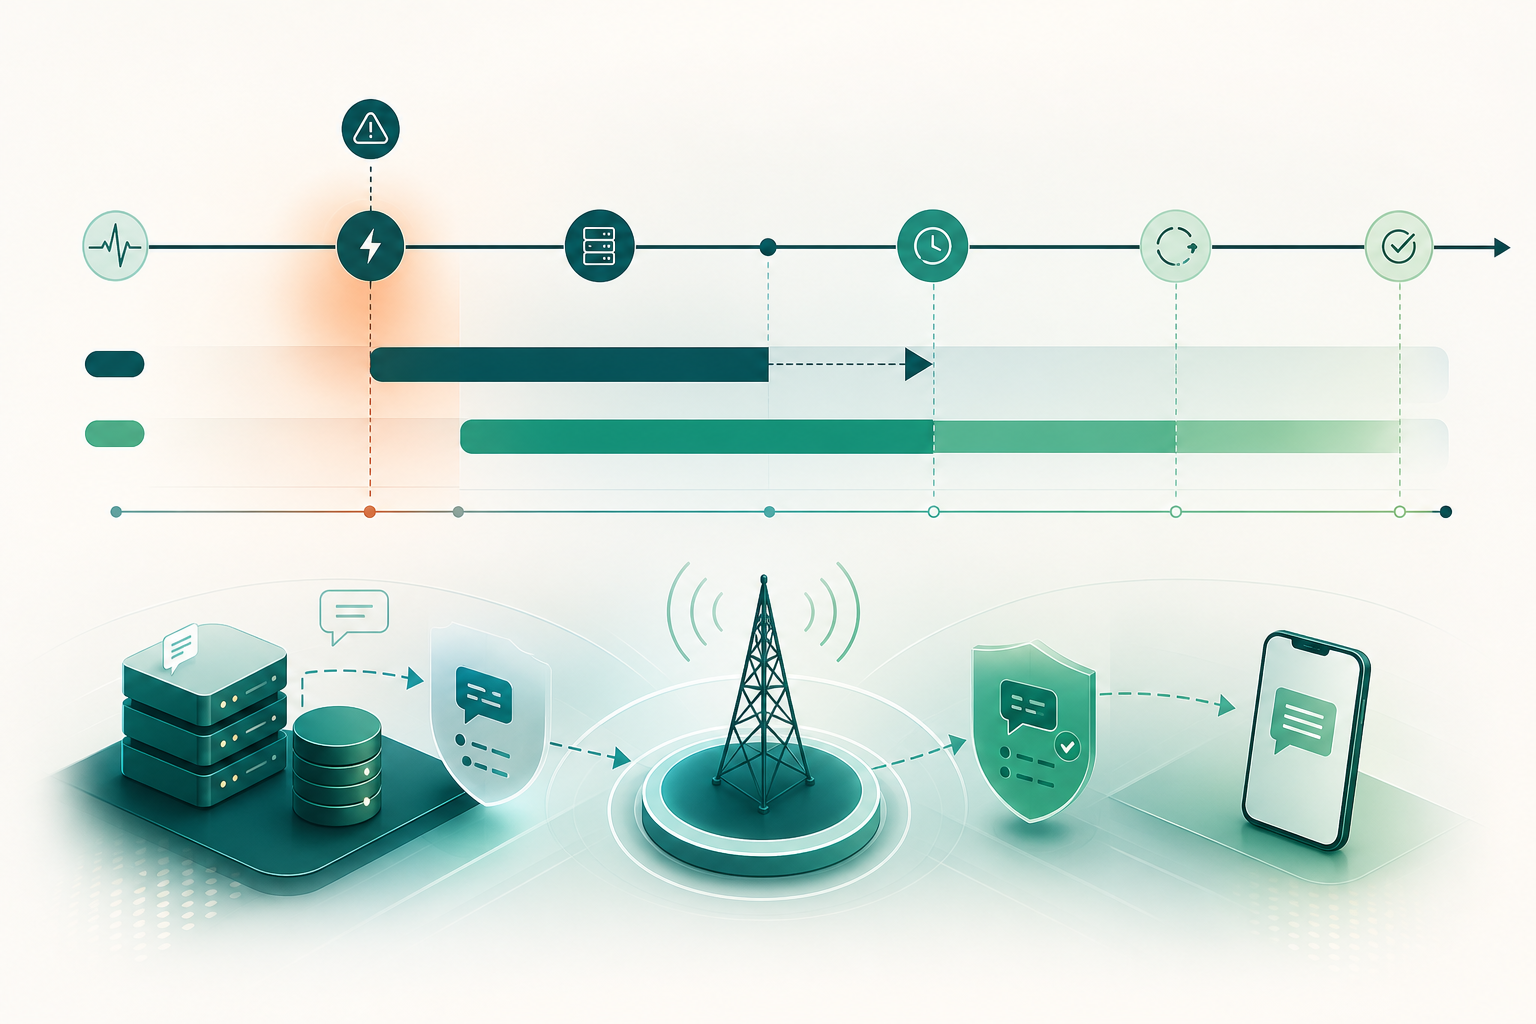
Eine alternative Route oder Verbindung kann eine wichtige Abhängigkeit sein, stellt aber nicht den gesamten Dienst dar. Das Inventar muss den Ablauf von der Anwendung, die den Versand anfordert, bis zur späteren Erfassung von Statusinformationen abdecken. Fällt ein nicht identifiziertes Element aus, kann die Umschaltung des Anbieters den Geschäftsprozess möglicherweise nicht wiederherstellen.
Dokumentieren Sie technische, operative und Kontrollabhängigkeiten. Geben Sie für jede Abhängigkeit Eigentümer, Wiederherstellungsmechanismus, erforderliche Zugangsdaten, verfügbare Beobachtbarkeit und die Auswirkungen einer Nichtverfügbarkeit an. Identifizieren Sie zudem Single Points of Failure und gemeinsame Abhängigkeiten zwischen scheinbar redundanten Optionen.
Bei SMPP kann das SMSC beim Akzeptieren einer Nachricht eine ID vergeben, auf die sich der spätere DLR beziehen kann. Daher ist die Fähigkeit, IDs zu speichern und zu korrelieren, Teil der Wiederherstellung. Ohne diese Korrelation kann ein Betrieb nicht wissen, ob eine Nachricht erneut gesendet, über mehr als einen Weg akzeptiert oder verspätet gemeldet wurde.
- Sendende Anwendung, interne Warteschlange und Speicherung von Anfragen.
- Zugangsdaten, Berechtigungen und sichere Zugriffsverwaltung.
- HTTP- oder SMPP-Konnektivität, Sitzungen, Limits und technische Überwachung.
- Anbieter, SMSC oder verfügbare Interkonnektivität für autorisierten Traffic.
- Absender, anwendbare Regeln und Konfiguration je Ziel.
- Interne und externe IDs zur Korrelation.
- Callbacks, DLRs, Statusabfragen und Verarbeitung asynchroner Ereignisse.
- Persistente Protokolle, Warnmeldungen, Dashboards und Kommunikationsverfahren.
Traffic nach Auswirkungen klassifizieren, bevor ein Vorfall eintritt
Priorität sollte nicht allein auf Volumen, Kunde oder verfügbarer Route beruhen. Sie muss sich an den Auswirkungen orientieren, wenn eine Nachricht verspätet, gar nicht oder doppelt eintrifft. Die Klassifizierung sollte mit den Eigentümern des Geschäftsprozesses abgestimmt und in umsetzbare Betriebsregeln überführt werden.
OTPs sind in der Regel zeitkritisch, doch das rechtfertigt kein wahlloses erneutes Senden. Besteht Unsicherheit über einen vorherigen Versuch, kann ein neues OTP dem erneuten Versand desselben Codes vorzuziehen sein, sofern der Authentifizierungsprozess und die Sicherheitsrichtlinie dies erlauben. Diese Entscheidung gehört zum Prozessdesign und ist keine allgemeingültige Transportregel.
Transaktionale und betriebliche Warnmeldungen erfordern eine Bewertung der Folgen von Duplikaten, Reihenfolge und Gültigkeit. Einwilligungsbasiertes Marketing lässt in der Regel eine sicherere Pause zu als eine beschleunigte Umschaltung, insbesondere wenn die Nachvollziehbarkeit nicht gewahrt oder die relevanten Frequenz- und Einwilligungsregeln nicht angewendet werden können.
- OTP und Authentifizierung: hohe Priorität, kurze Nutzungsdauer und strenge Kontrolle von Wiederholungsversuchen.
- Transaktionale Warnmeldungen: Priorität nach Auswirkung, unter Berücksichtigung von Reihenfolge, Duplikaten und Gültigkeit.
- Betriebliche Kommunikation: bewerten, ob der SMS-Kanal unverzichtbar ist oder ein autorisiertes Alternativverfahren eingesetzt werden sollte.
- Einwilligungsbasiertes Marketing: normalerweise für Drosselung oder Pause geeignet, wenn der betriebliche Nachweis unvollständig ist.
Sichere Degradationsmodi definieren
Der Plan muss festlegen, was zu tun ist, wenn der Dienst nicht unter normalen Bedingungen arbeitet. Drosseln, in eine Warteschlange stellen, pausieren, umleiten oder ein manuelles Verfahren anwenden sind unterschiedliche Degradationsmodi. Jeder Modus benötigt Eintrittsbedingungen, einen Verantwortlichen für die Freigabe, Geltungsbereich, maximale Dauer bis zur Überprüfung und Austrittskriterien.
Drosselung reduziert das Volumen oder reserviert Kapazität für eine priorisierte Klasse. Warteschlangen bewahren Anfragen für eine spätere Verarbeitung auf, sind aber nur geeignet, wenn die Nachricht nach der Verzögerung noch relevant ist und die Warteschlange den erforderlichen Kontext erhält. Eine Pause verhindert das Senden von Traffic, wenn dies nicht nachvollziehbar oder regelkonform möglich ist. Die Umleitung auf einen alternativen Kanal ist nur dann angebracht, wenn dieser Kanal für den Anwendungsfall autorisiert ist und der Prozess ihn unterstützen kann.
Verwenden Sie eine alternative Route nicht als automatische Richtlinie für den gesamten Traffic. Prüfen Sie vor der Umleitung, ob Absender, Konnektivität, anwendbare Anforderungen, Nachrichtengültigkeit, Korrelationsfähigkeit und Duplikatrisiko weiterhin akzeptabel sind.
- Drosseln: Kapazität reservieren und nicht kritische Sendungen reduzieren.
- In Warteschlange stellen: Nachrichten nur bewahren, wenn Ablaufzeit und Kontext eine spätere Verarbeitung erlauben.
- Pausieren: Sendungen stoppen, wenn Unsicherheit oder mögliches Fehlverhalten den Nutzen übersteigt.
- Umleiten: einen anderen autorisierten und dokumentierten Kanal für den betroffenen Prozess verwenden.
- Temporäres manuelles Verfahren: nur anwenden, wenn es konzipiert, autorisiert und nachvollziehbar ist.
Warum eine alternative Route keine garantierte Wiederherstellung bedeutet
Eine Alternative kann die Fähigkeit wiederherstellen, Traffic an einen anderen Anbieter, ein anderes SMSC oder über eine andere Verbindung zu übergeben. Das ist wertvoll, beweist jedoch nicht, dass die vorherige Nachricht nicht akzeptiert wurde, dass der neue Versuch denselben Absender verwenden kann oder dass der Empfänger die Nachricht erhalten wird.
Bei SMPP sind die Annahme eines Submits und der DLR unterschiedliche Ereignisse. Das SMSC kann beim Akzeptieren der Nachricht eine ID zurückgeben, während der DLR später eintrifft, normalerweise über deliver_sm oder data_sm. Zudem hängt die DLR-Anforderung von der Konfiguration von registered_delivery ab und bedeutet nicht, dass für jede Nachricht ein Zustellbericht existiert.
Entsprechend kann ein Sendestatus die Annahme durch einen vorgelagerten Carrier widerspiegeln, während ein Zustellstatus eine spätere Bestätigung erfordert. Selbst wenn ein Status delivered erfasst wird, muss die Interpretation die von dem jeweiligen Anbieter oder der konkreten Interkonnektivität dokumentierte Semantik berücksichtigen. Dies darf nicht mit einer absoluten und unabhängigen Garantie des Empfangs durch eine Person verwechselt werden.
Technische Redundanz mindert bestimmte Verfügbarkeitsrisiken. Sie beseitigt weder Zielbeschränkungen noch Absenderverhalten, verlorene Callbacks, Unsicherheit vor der Umschaltung oder das Risiko doppelten Traffics.
- Alternative Sendefähigkeit ist nicht gleichbedeutend mit bestätigter Zustellung.
- Eine Annahmebestätigung ersetzt keinen späteren DLR.
- Ein angeforderter DLR garantiert nicht, dass er für alle Nachrichten empfangen wird.
- Die Entscheidung für einen Wiederholungsversuch muss Unsicherheit, Gültigkeit und die Kosten von Duplikaten berücksichtigen.
Aktivierungskriterien: Signale, Schwellenwerte und menschliche Validierung
Ein Notfallmodus sollte weder allein aufgrund eines isolierten Eindrucks aktiviert werden noch von einem Alarm ohne Kontext abhängen. Definieren Sie beobachtbare Signale für jede Abhängigkeit: Verbindungsfehler, Authentifizierungsfehler, Ausfall von Callbacks, anwachsende Warteschlangen, auffälliges Ausbleiben nachfolgender Statusinformationen oder abgelehnte Anfragen. Die Schwellenwerte müssen zur Traffic-Klasse und zu den tolerierbaren Auswirkungen des Prozesses passen.
Um übermäßige Änderungen zu vermeiden, weisen Sie eine menschliche Validierung zu, bevor Maßnahmen angewendet werden, die die Behandlung von Traffic großflächig verändern. Automatisierung kann innerhalb vorab genehmigter Regeln eine Warteschlange drosseln oder schützen. Eine allgemeine Umleitung, ein Absenderwechsel oder das erneute Senden unsicherer Nachrichten erfordern jedoch eine ausdrückliche und protokollierte Entscheidung.
Das Aktivierungskriterium muss den Geltungsbereich einschließen: welche Ziele, Absender, Traffic-Klassen, Verbindungen oder Komponenten betroffen sind. Ein lokaler Vorfall sollte keine unnötige Änderung des gesamten Dienstes auslösen.
- Beobachtetes technisches Signal und Quelle des Nachweises.
- Zeitfenster der Bewertung und betroffener Geltungsbereich.
- Für jede Maßnahme autorisierte Traffic-Klasse.
- Verantwortliche Person für Aktivierung, Validierung und Kommunikation des Notfallmodus.
- Protokollierung der Entscheidung, der Uhrzeit und der geänderten Variablen.
- Kriterium zur Überprüfung, Beibehaltung oder Aufhebung der Maßnahme.
Nachvollziehbarkeit während eines Notfalls erhalten
Betriebskontinuität hängt davon ab, erklären zu können, was mit jeder Nachricht geschehen ist. Bewahren Sie ab der Erstellung der Anfrage eine persistente interne ID auf und verknüpfen Sie sie, sofern verfügbar, mit den IDs, die von der Konnektivität, dem Anbieter oder dem SMSC zurückgegeben werden. Verlassen Sie sich nicht ausschließlich auf den Callback, um die Erstellung zu erfassen: Der Anfangsstatus kann aus der synchronen Annahmeantwort stammen.
Behandeln Sie Callbacks und DLRs als asynchrone Ereignisse. Sie können nach einem Routenwechsel, einer Pause oder einem Wiederholungsversuch eintreffen. Das Protokoll muss den Anfangsstatus, Statusänderungen, Zeitstempel, Ereignisquelle, angewendete Entscheidung und die Verbindung zu jedem späteren Versuch enthalten.
Bewahren Sie Nachweise für den durch Ihre Verpflichtungen und internen Richtlinien festgelegten Zeitraum auf und wenden Sie dabei Datenminimierung sowie angemessene Zugriffskontrollen an. Ziel ist es, den Notfall abzugleichen und zu prüfen, nicht Informationen unbegrenzt zu speichern oder die Datennutzung über ihren Zweck hinaus auszuweiten.
- Interne Anfrage-ID oder Idempotenzschlüssel.
- Annahme-ID oder externe Nachrichten-ID, sofern vorhanden.
- Traffic-Klasse, Absender, Ziel und Zeitstempel des Versuchs.
- Anfangsstatus aus der Erstellungs- oder Sendeantwort.
- Nachfolgende Ereignisse: Callback, DLR, Statusabfrage und Fehler.
- Notfallentscheidung, verantwortliche Person und Begründung.
- Verknüpfung zwischen ursprünglichem Versuch, Wiederholungsversuch und Ersatznachricht.
Häufige Fragen
Was ist ein A2P-SMS-Betriebskontinuitätsplan?
Er ist eine abgestimmte Sammlung von Verfahren, Verantwortlichkeiten und technischen Maßnahmen, um A2P-Messaging-Prozesse nach einer Unterbrechung wiederherzustellen oder aufrechtzuerhalten. Er sollte den Geschäftsprozess, technische Abhängigkeiten, Statusdaten, Degradationsentscheidungen und den nachfolgenden Abgleich abdecken.
Was ist der Unterschied zwischen RTO und RPO bei A2P-SMS?
Der RTO definiert, wie lange eine Fähigkeit nicht verfügbar sein darf, bevor die Auswirkungen nicht mehr akzeptabel sind. Der RPO definiert, bis zu welchem Zeitpunkt vor der Unterbrechung Daten und Statusinformationen wiederherstellbar sein müssen. Keiner von beiden garantiert die Zustellung einer SMS an den Empfänger.
Garantiert eine alternative Route die Wiederherstellung des Dienstes?
Nein. Sie kann die Fähigkeit wiederherstellen, Nachrichten über eine andere Verbindung oder einen anderen Anbieter zu übergeben, garantiert aber keine endgültige Zustellung. Sie beseitigt weder die Unsicherheit über vorherige Versuche noch verhindert sie allein Duplikate, verspätete DLRs oder Einschränkungen durch Absender und Ziel.
Sollte eine SMS automatisch erneut gesendet werden, wenn kein DLR eintrifft?
Nicht als allgemeine Regel. Das Ausbleiben eines DLR beweist allein nicht, dass die Nachricht nicht zugestellt wurde. Vor einem erneuten Versand müssen Nachrichtengültigkeit, Duplikatrisiko, verfügbare Korrelation, Prozessrichtlinie und die Möglichkeit zur Statusabfrage oder -abstimmung bewertet werden.
Was sollte während eines Messaging-Notfalls protokolliert werden?
Mindestens eine persistente interne ID, der Anfangsstatus, verfügbare externe IDs, Zeitstempel, empfangene Callbacks oder DLRs, die Quelle jedes Ereignisses, Wiederholungsversuche und die angewendete operative Entscheidung. Damit lassen sich ausstehende Nachrichten, verspätete Ereignisse und mögliche Duplikate abgleichen.
Wie häufig sollte der Plan getestet werden?
Regelmäßig durch Tests, Schulungen und kontrollierte Übungen. Jeder Test sollte Verantwortliche, Geltungsbereich, Erfolgskriterien, Austrittskriterien und eine anschließende Überprüfung der erforderlichen Änderungen umfassen.
Verwendete Quellen
- NIST SP 800-34 Rev. 1 — Contingency Planning Guide for Federal Information SystemsNational Institute of Standards and Technology (NIST)
- NIST CSRC — Contingency PlanningNational Institute of Standards and Technology (NIST)
- SMPP Protocol Specification v3.4, Issue 1.2SMS Forum / SMPP Developers Forum
- SMPP Delivery ReceiptsSMPP Developers Forum
- 3GPP TS 23.040 change-request portal3rd Generation Partnership Project (3GPP)
- Best Practices for Messaging Delivery Status LoggingTwilio
- Outbound Message Status in Status CallbacksTwilio
- Messages resourceTwilio
- Messaging ServicesTwilio
- Message Status StreamTwilio