Latencia OTP por SMS: cómo definir umbrales de alerta útiles
Guía práctica para desglosar la latencia OTP por etapas, elegir métricas y ventanas de observación, y crear alertas que detecten anomalías sin confundir un DLR con una confirmación de recepción.
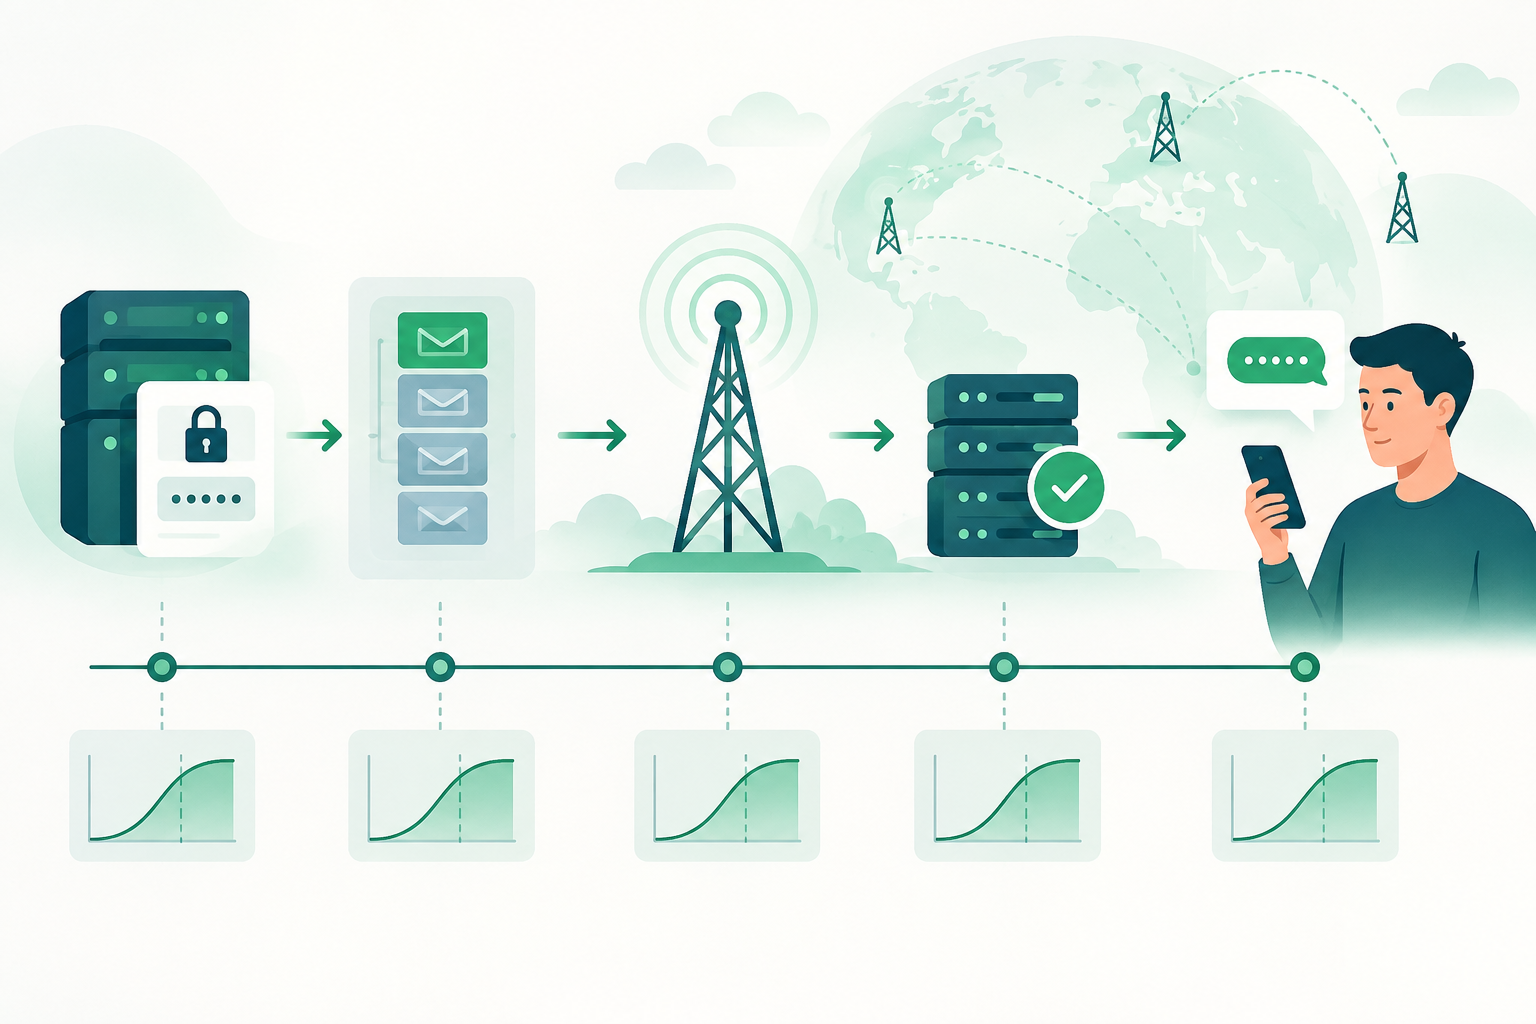
Por qué una latencia media no basta para vigilar OTP
La media resume el conjunto, pero puede ocultar una cola de mensajes mucho más lentos que afecta a una parte de las sesiones. Por eso, al vigilar OTP, conviene observar la distribución de tiempos y no depender de un único promedio.
Los percentiles ayudan a formular preguntas distintas: la mediana describe el centro de la distribución; un percentil alto permite observar la experiencia de los casos más lentos sin dejar que unos pocos valores extremos dominen la métrica. No existe en la evidencia disponible un percentil universal que sirva para todas las aplicaciones, destinos o rutas.
Antes de fijar una alerta, define qué evento marca el inicio y cuál marca el final. Si cada componente usa marcas de tiempo o criterios diferentes, la comparación puede reflejar diferencias de medición y no un cambio real del servicio.
- Mantén la media como indicador complementario, no como única señal.
- Compara percentiles con el mismo método de cálculo y la misma definición de inicio y fin.
- Interpreta cualquier percentil junto con el volumen de observaciones: una muestra pequeña puede producir resultados inestables.
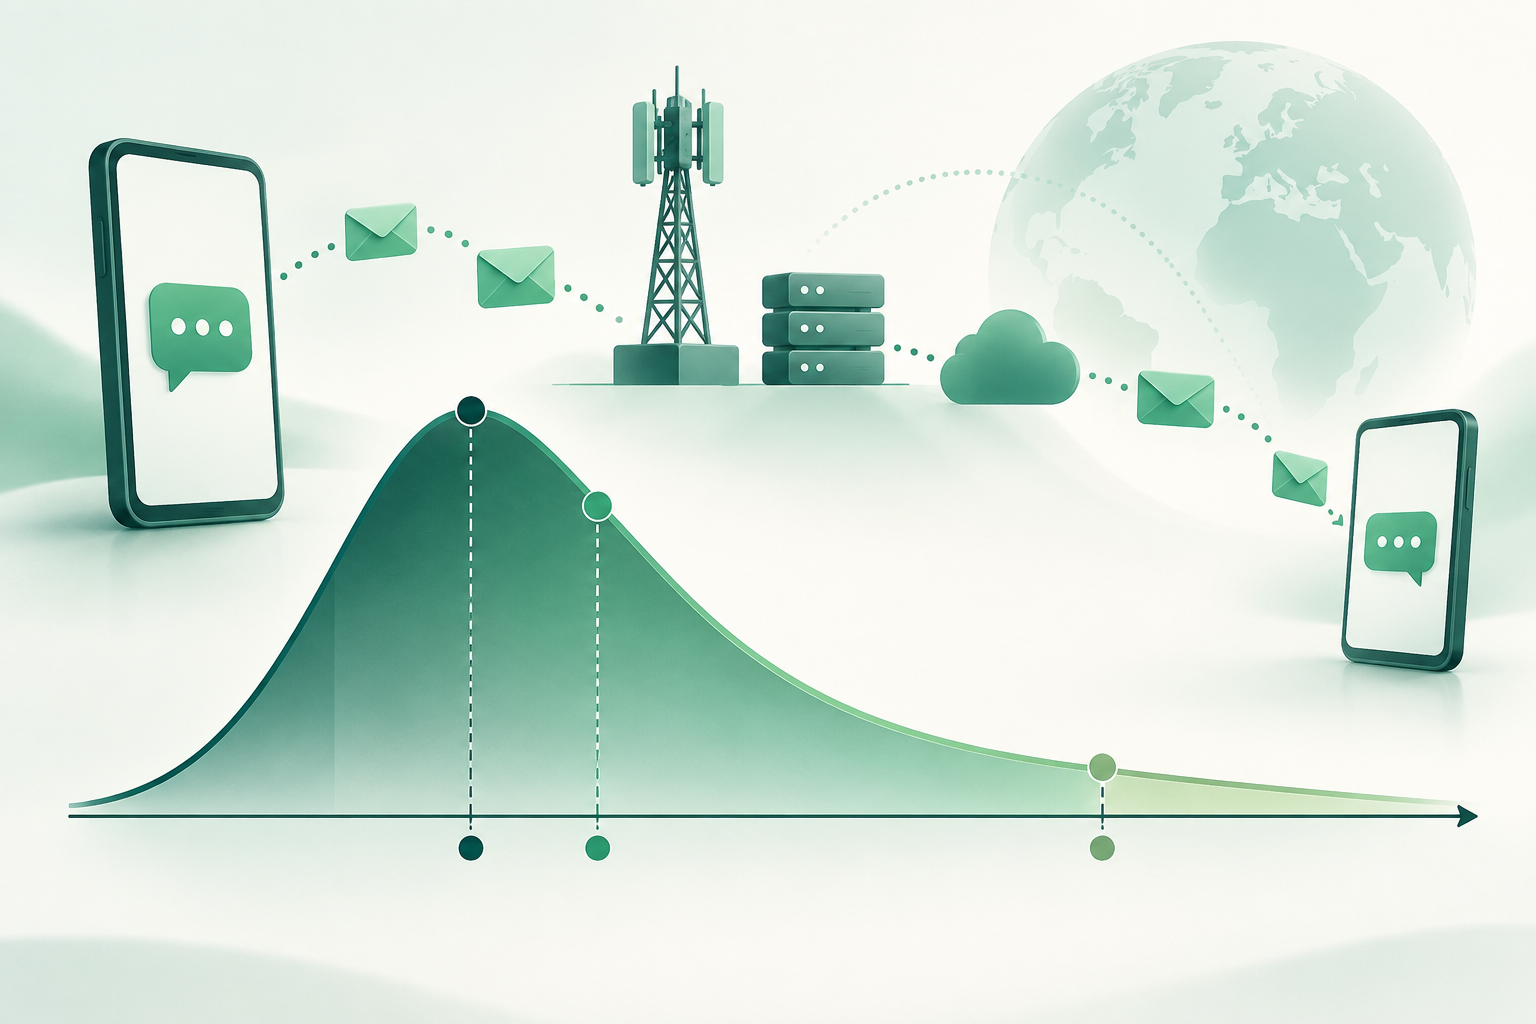
Mapear el recorrido del OTP y asignar un presupuesto por etapa
Un tiempo total solo indica cuánto transcurrió entre dos eventos elegidos. Para localizar retrasos, desglosa el recorrido con marcas de tiempo propias: generación del código, entrada y espera en la cola, envío al proveedor y llegada de un estado reportado. Registra también el momento en que la aplicación recibe una respuesta del proveedor, si ese evento forma parte de tu integración.
No todas las plataformas exponen los mismos eventos, y el tiempo entre una etapa y otra puede incluir trabajo interno, espera o latencia de comunicación. Documenta qué mide cada intervalo y qué componentes quedan fuera. Evita sumar duraciones que se solapan o comparar relojes que no estén sincronizados de forma adecuada.
Un presupuesto por etapa es un objetivo operativo que tú defines, no un límite técnico universal ni una garantía de entrega. Empieza con requisitos del producto y datos observados en condiciones normales; reparte el tiempo disponible entre etapas que puedas medir y controlar. Revisa la asignación cuando cambien la arquitectura, la integración o el comportamiento observado.
- Define eventos de inicio y fin para cada intervalo.
- Identifica qué equipo o componente puede actuar sobre cada etapa.
- Registra los casos sin marcas de tiempo completas como datos incompletos, en lugar de asignarles una duración inventada.
- No uses un objetivo interno como promesa al usuario o garantía de entrega.
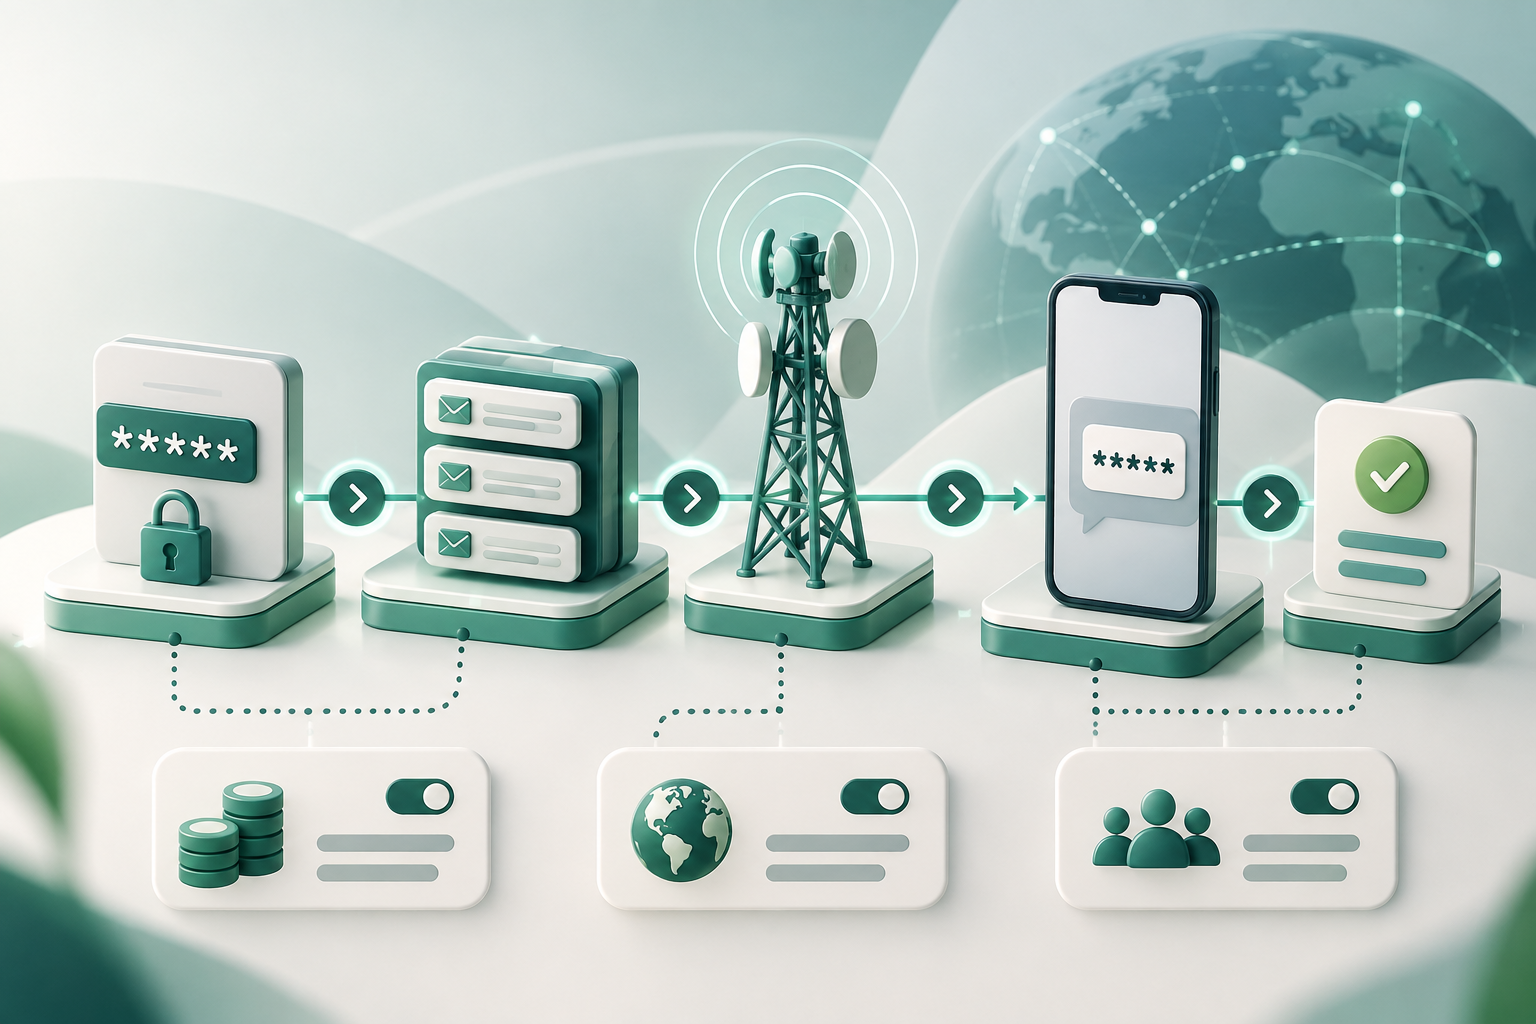
Elegir percentiles, volumen y ventanas de observación
Elige las métricas según la decisión que deben apoyar. La mediana puede mostrar el comportamiento típico; un percentil alto puede señalar degradación en la cola lenta. Observa ambos cuando sea útil, junto con el volumen y la proporción de eventos sin resultado. No presentes una cifra como representativa si hay pocas observaciones.
La ventana de observación debe equilibrar rapidez y estabilidad. Una ventana breve puede reaccionar pronto, pero también amplificar variaciones aleatorias; una ventana extensa suaviza fluctuaciones, aunque puede tardar más en revelar un cambio. La selección depende del volumen, del ritmo del tráfico y del tiempo en que el equipo necesita actuar; la evidencia disponible no establece una duración recomendada.
Si utilizas umbrales dinámicos, valida cómo aprende y se ajusta la herramienta antes de confiar en sus alertas. La documentación de Microsoft sobre Azure Monitor indica que sus umbrales dinámicos emplean diez días de datos históricos al crear una regla. Ese comportamiento corresponde a esa función concreta y no debe tratarse como una regla general para otros sistemas.
- Anota el percentil, la ventana, el volumen mínimo aplicado y el tratamiento de datos incompletos.
- Comprueba que una ventana contenga suficientes eventos para que la métrica sea interpretable en tu contexto.
- Evalúa si el cambio es sostenido y relevante antes de elevar una variación breve a incidente.
Separar latencia de envío, recepción de DLR y confirmación del usuario
Separa los hitos en tus métricas. La respuesta a una solicitud de envío, un estado posterior reportado por la cadena y una confirmación en la aplicación son eventos distintos. Mide cada uno con su propia marca de tiempo y nómbralo de forma explícita.
Un DLR es un estado reportado por algún componente de la cadena de mensajería. Su significado concreto depende de la implementación y del estado comunicado. No lo presentes, por sí solo, como prueba independiente de que el SMS apareció en el terminal o de que la persona lo leyó.
Si el usuario introduce el código, ese evento puede confirmar que el flujo de autenticación avanzó, pero tampoco equivale automáticamente a una medición pura de entrega: pueden influir la acción del usuario y otros pasos de la aplicación. Mantén separado el indicador técnico de estado reportado del resultado observado en el producto.
- Etiqueta por separado envío aceptado, estado reportado y finalización del flujo de autenticación.
- Documenta el significado de los estados según la integración concreta; no generalices códigos entre implementaciones.
- Cuando falte confirmación independiente del terminal, declara esa incertidumbre en los informes.
Definir umbrales por destino y contexto sin convertirlos en garantías
Un umbral agregado puede ocultar que una parte del tráfico se comporta de forma distinta. Cuando el volumen y los datos lo permitan, compara grupos relevantes, como destino o ruta, y conserva una vista global para detectar impactos amplios. Usa identificadores de destino consistentes y documentados; el plan de segmentación debe ajustarse a lo que tu sistema realmente observa.
Segmentar demasiado produce grupos con pocas muestras y lecturas inestables. Mantén una categoría agregada cuando no haya datos suficientes para una conclusión prudente y evita atribuir una causa a un operador o ruta solo porque una métrica cambió al mismo tiempo.
Los umbrales describen cuándo investigar una desviación frente a un objetivo o una línea base interna. No prueban que un mensaje vaya a entregarse antes de un plazo, ni que una ruta ofrezca el mismo resultado para cada usuario o sesión.
- Empieza con dimensiones que permitan una acción operativa concreta.
- Conserva volumen y cobertura de datos junto a cada comparación.
- No publiques resultados como benchmarks de mercado si proceden de mediciones internas o de muestras no comparables.
Diseñar alertas con persistencia, volumen mínimo y severidad
Una alerta accionable combina una métrica, una condición, una ventana y un volumen suficiente para interpretarla. Elige esos elementos con datos de tu propio servicio y con el tiempo de respuesta operativo disponible; no hay valores universales verificados para fijarlos.
Para evitar notificaciones por variaciones aisladas, puedes exigir que la condición persista o se repita en varias evaluaciones. Ajusta la persistencia según el impacto y el riesgo de retrasar una respuesta. Separa las señales de degradación de latencia de las de falta de estados reportados o de fallos en la integración: requieren diagnósticos distintos.
Asigna severidad según el impacto observado y la capacidad de actuar, no solo por lo lejos que esté una métrica de su referencia. Una alerta de investigación puede pedir revisar una anomalía; una escalación debe reservarse para condiciones que el equipo haya definido como relevantes para el servicio.
- Incluye en la alerta la etapa, el percentil, la ventana, el volumen y los grupos afectados.
- Define quién investiga y qué evidencia debe revisar antes de escalar.
- Prueba el comportamiento de la regla con datos históricos o simulados cuando sea posible, sin asumir que la prueba garantiza el desempeño futuro.
Investigar una alerta: comparar etapas, destinos y estados
Empieza comprobando que el cambio no provenga de una alteración en la instrumentación, los relojes, el volumen o el criterio de inclusión. Después compara las duraciones por etapa con el total: si el retraso se concentra en una etapa, orienta la investigación hacia los componentes que la controlan, sin dar por demostrada una causa.
Contrasta la vista global con los grupos por destino o ruta que tengan muestras interpretables. Revisa por separado los estados reportados y los casos sin estado, porque una demora en recibir un DLR no demuestra por sí sola que el envío también se haya retrasado.
Registra el intervalo afectado, los grupos observados, los cambios recientes y las limitaciones de los datos. Si la evidencia no distingue entre causas posibles, formula la conclusión como hipótesis pendiente de verificación.
- Valida primero integridad, volumen y consistencia de las marcas de tiempo.
- Localiza en qué intervalo aparece la desviación antes de asignar una causa.
- Compara grupos solo cuando sus datos sean suficientes y comparables.
- Distingue ausencia de estado, latencia de estado y latencia medida en otras etapas.
Revisar umbrales y documentar incertidumbres
Los umbrales necesitan revisión cuando cambian el producto, la instrumentación, el patrón de tráfico o las condiciones operativas. Conserva el historial de cambios y explica qué evidencia motivó cada ajuste. Evita modificar una regla solo para silenciar una alerta sin averiguar primero si la señal revela un cambio real.
Registra las exclusiones, los eventos incompletos, las dimensiones con poco volumen y los límites de lo que puede afirmar cada estado. Esta información permite interpretar las tendencias con cautela y evita que una medida interna se confunda con una garantía externa.
BulkSMSMarket describe una plataforma en desarrollo para descubrir, comparar, comprar, vender y gestionar capacidad A2P SMS, además de una plataforma interna de pruebas que observa, entre otros aspectos, latencia y consistencia de DLR. Las tarjetas numéricas públicas son demostrativas hasta que se conecten datos contractuales; no deben usarse como métricas comerciales en vivo ni como umbrales de referencia.
- Guarda la definición de la métrica, la regla vigente, sus exclusiones y la fecha de revisión.
- Reevalúa el umbral después de cambios relevantes y verifica que la comparación siga siendo válida.
- Expón claramente qué es dato observado, qué es objetivo interno y qué incertidumbre permanece.
Preguntas frecuentes
¿Qué percentil debo usar para alertar sobre latencia OTP por SMS?
No hay un percentil universal respaldado para todos los servicios. Elige la métrica según la experiencia que quieras vigilar y valida su estabilidad con el volumen disponible. La mediana y un percentil alto pueden aportar perspectivas complementarias.
¿Cuánto debe durar la ventana de observación?
Depende del volumen, el patrón de tráfico y el tiempo de respuesta que necesite tu operación. Una ventana breve reacciona antes, pero puede ser más sensible a variaciones; una larga suaviza fluctuaciones, pero puede retrasar la detección. No hay una duración universal verificada.
¿Un DLR confirma que el OTP llegó al teléfono?
No por sí solo. Un DLR es un estado reportado por la cadena y su significado depende de la implementación. No equivale necesariamente a una verificación independiente de recepción en el terminal ni confirma que el usuario haya leído el mensaje.
¿Conviene crear umbrales distintos por destino o ruta?
Puede ayudar si la segmentación permite investigar una diferencia y hay suficientes datos comparables. Si los grupos son pequeños, sus métricas pueden ser inestables; conserva una vista agregada y expresa la incertidumbre.
¿Los umbrales de alerta garantizan la entrega del OTP?
No. Son controles operativos para señalar desviaciones en métricas definidas. No garantizan entrega, recepción en un plazo concreto ni un resultado idéntico para cada mensaje.
Fuentes consultadas
- Azure Monitor: umbrales dinámicosMicrosoft Learn
- Especificaciones 3GPP3GPP
- ITU-T E.164International Telecommunication Union
- NIST SP 800-63-4NIST
- OWASP Authentication Cheat SheetOWASP
- GSMA: redes y tecnologíasGSMA