Latência de OTP por SMS: como definir limites de alerta úteis
Guia prático para decompor a latência de OTP por etapas, escolher métricas e janelas de observação e criar alertas que detetem anomalias sem confundir um DLR com uma confirmação de receção.
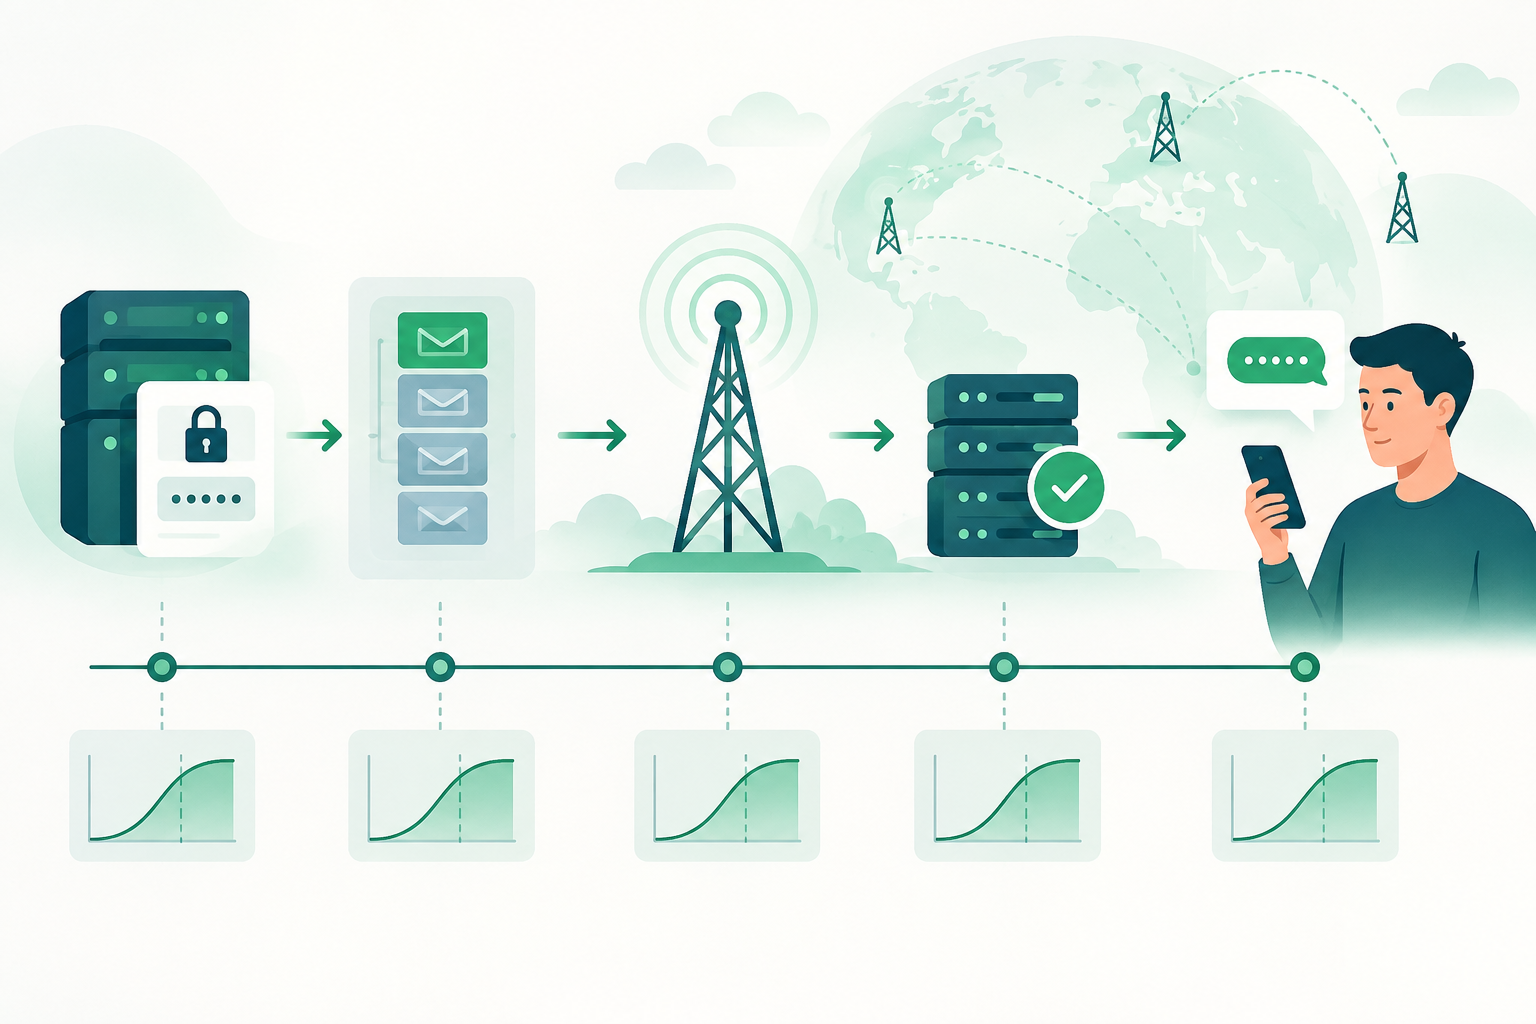
Porque é que a latência média não basta para monitorizar OTP
A média resume o conjunto, mas pode ocultar uma cauda de mensagens muito mais lentas que afeta parte das sessões. Por isso, ao monitorizar OTP, é conveniente observar a distribuição dos tempos e não depender de uma única média.
Os percentis ajudam a colocar perguntas diferentes: a mediana descreve o centro da distribuição; um percentil elevado permite observar a experiência dos casos mais lentos sem deixar que alguns valores extremos dominem a métrica. As evidências disponíveis não apontam para um percentil universal adequado a todas as aplicações, destinos ou rotas.
Antes de definir um alerta, determine qual evento marca o início e qual marca o fim. Se cada componente usar marcas temporais ou critérios diferentes, a comparação pode refletir diferenças de medição, e não uma alteração real do serviço.
- Mantenha a média como indicador complementar, não como único sinal.
- Compare percentis usando o mesmo método de cálculo e a mesma definição de início e fim.
- Interprete qualquer percentil em conjunto com o volume de observações: uma amostra pequena pode produzir resultados instáveis.
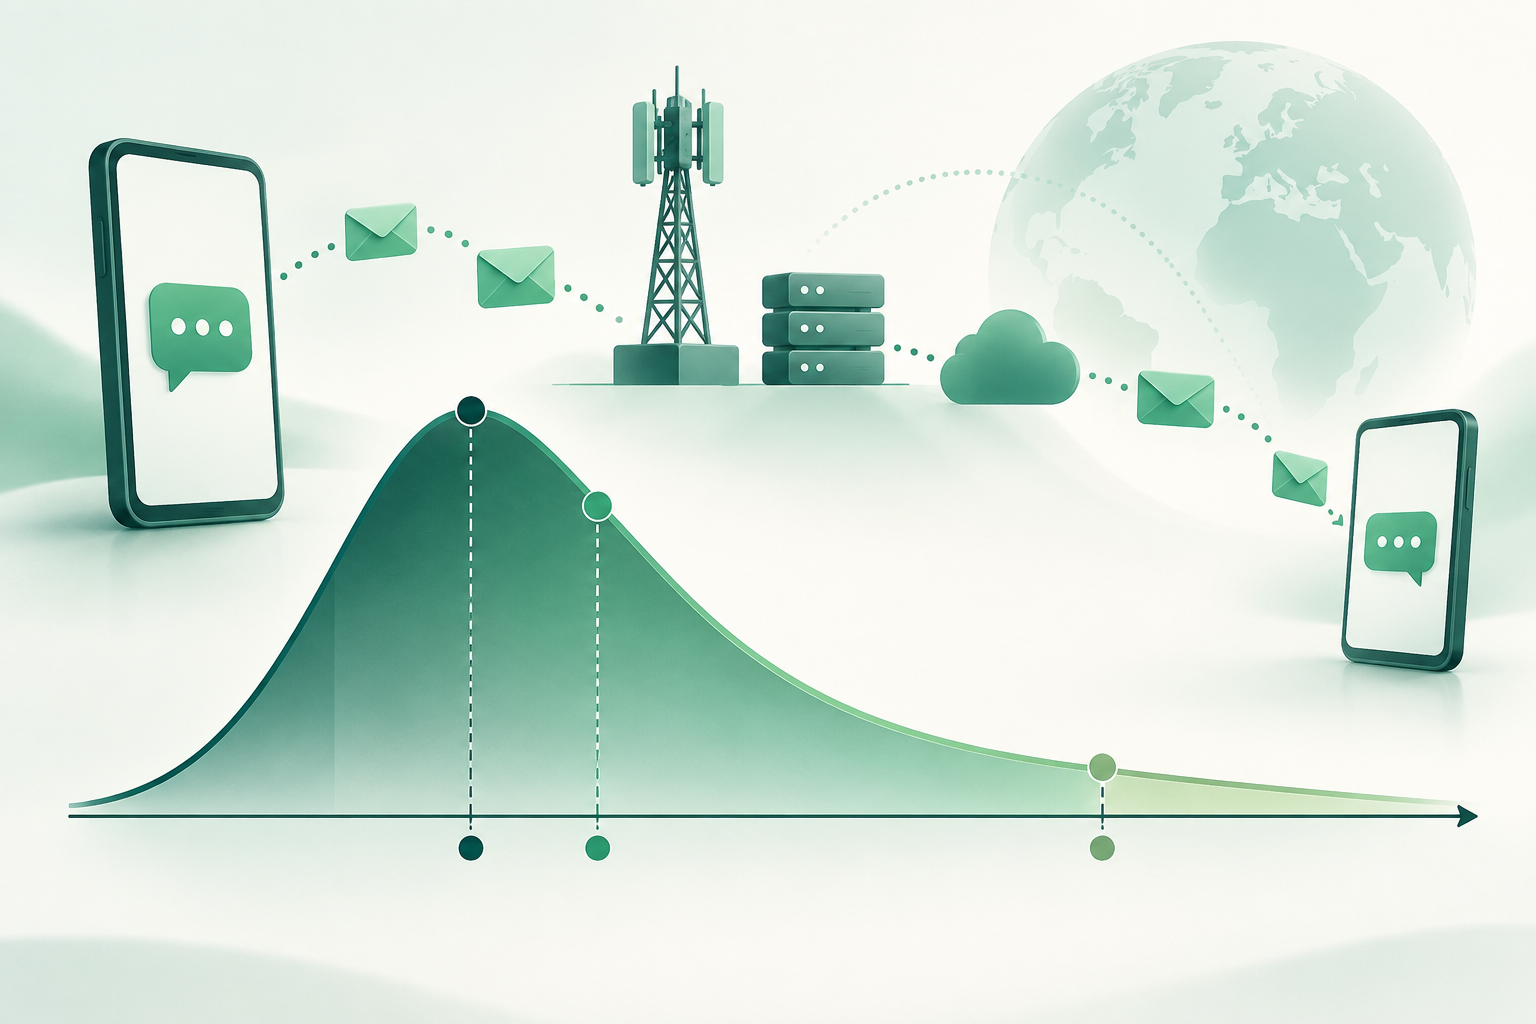
Mapear o percurso do OTP e atribuir um orçamento por etapa
O tempo total indica apenas quanto decorreu entre dois eventos escolhidos. Para localizar atrasos, decomponha o percurso com marcas temporais próprias: geração do código, entrada e espera na fila, envio ao fornecedor e receção de um estado reportado. Registe também o momento em que a aplicação recebe uma resposta do fornecedor, se esse evento fizer parte da sua integração.
Nem todas as plataformas expõem os mesmos eventos, e o tempo entre uma etapa e outra pode incluir processamento interno, espera ou latência de comunicação. Documente o que cada intervalo mede e quais componentes ficam de fora. Evite somar durações sobrepostas ou comparar relógios que não estejam devidamente sincronizados.
Um orçamento por etapa é um objetivo operacional definido por si, não um limite técnico universal nem uma garantia de entrega. Comece pelos requisitos do produto e pelos dados observados em condições normais; distribua o tempo disponível pelas etapas que consegue medir e controlar. Reveja essa distribuição quando a arquitetura, a integração ou o comportamento observado mudarem.
- Defina eventos de início e fim para cada intervalo.
- Identifique a equipa ou o componente que pode agir em cada etapa.
- Registe os casos sem marcas temporais completas como dados incompletos, em vez de lhes atribuir uma duração inventada.
- Não apresente um objetivo interno como promessa ao utilizador ou garantia de entrega.
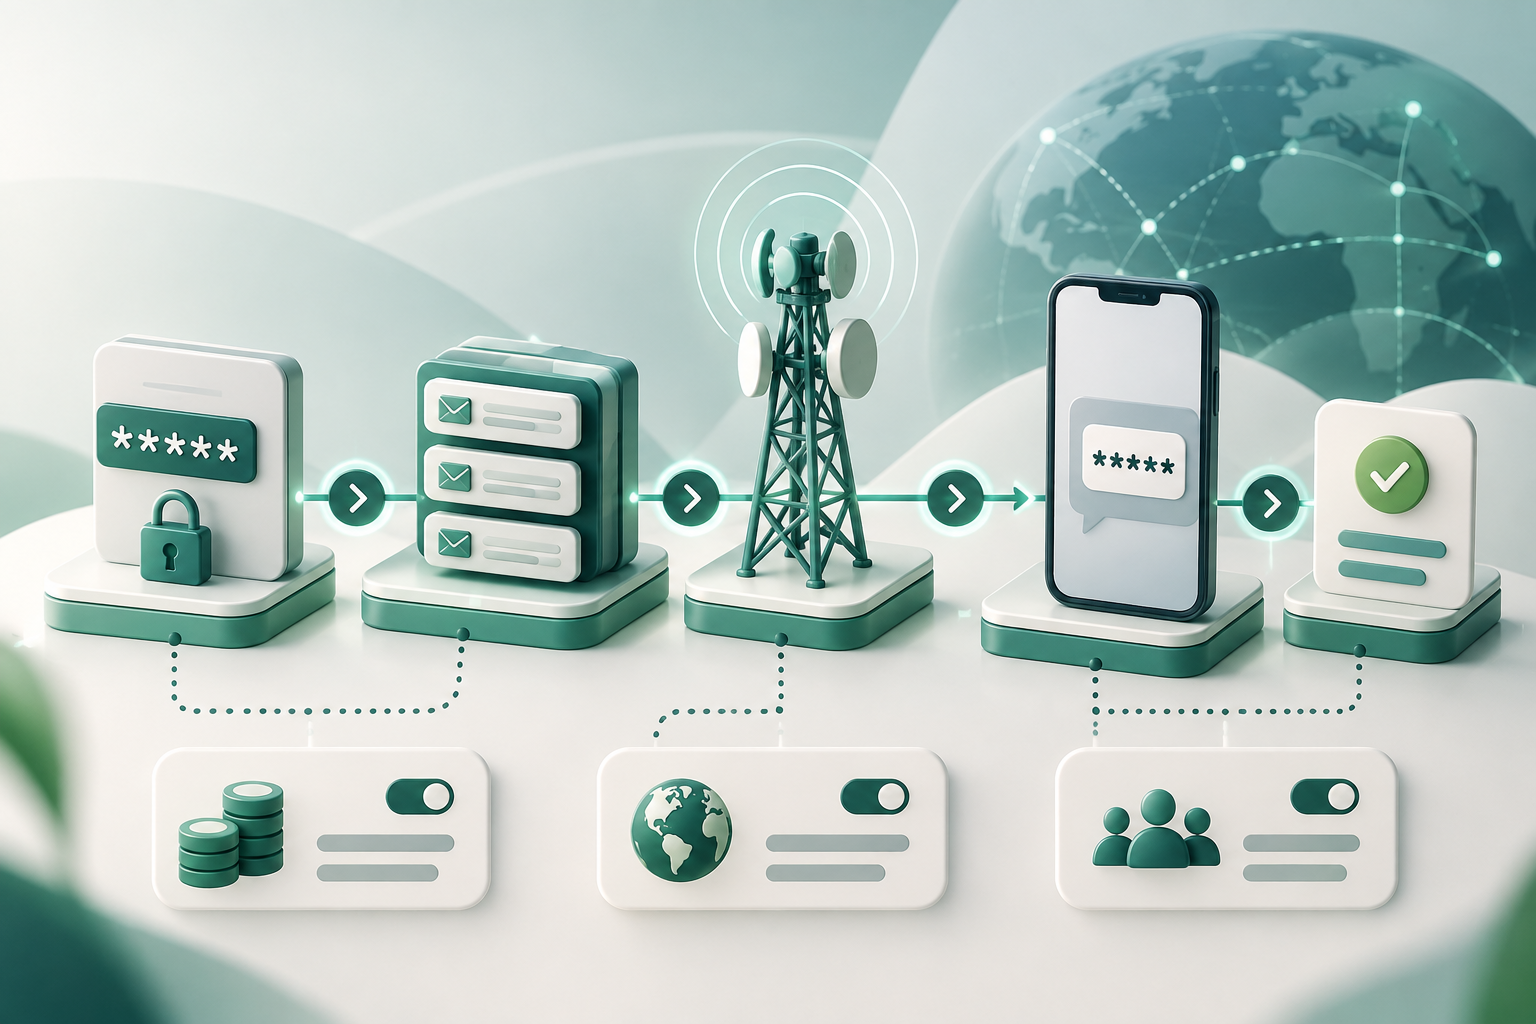
Escolher percentis, volume e janelas de observação
Escolha as métricas de acordo com a decisão que devem apoiar. A mediana pode mostrar o comportamento típico; um percentil elevado pode assinalar degradação na cauda lenta. Quando for útil, observe ambos, juntamente com o volume e a proporção de eventos sem resultado. Não apresente um valor como representativo se houver poucas observações.
A janela de observação deve equilibrar rapidez e estabilidade. Uma janela curta pode reagir depressa, mas também amplificar variações aleatórias; uma janela longa suaviza flutuações, embora possa demorar mais a revelar uma alteração. A escolha depende do volume, do ritmo do tráfego e do tempo de que a equipa dispõe para agir; as evidências disponíveis não estabelecem uma duração recomendada.
Se utilizar limites dinâmicos, valide como a ferramenta aprende e se ajusta antes de confiar nos seus alertas. A documentação da Microsoft sobre o Azure Monitor indica que os respetivos limites dinâmicos usam dez dias de dados históricos ao criar uma regra. Esse comportamento aplica-se a essa funcionalidade específica e não deve ser tratado como regra geral para outros sistemas.
- Registe o percentil, a janela, o volume mínimo aplicado e o tratamento dos dados incompletos.
- Verifique se uma janela contém eventos suficientes para que a métrica seja interpretável no seu contexto.
- Avalie se a alteração é persistente e relevante antes de classificar uma variação breve como incidente.
Distinguir latência de envio, receção de DLR e confirmação do utilizador
Separe os marcos nas suas métricas. A resposta a um pedido de envio, um estado posterior reportado pela cadeia e uma confirmação na aplicação são eventos diferentes. Meça cada um com a sua própria marca temporal e atribua-lhe um nome explícito.
Um DLR é um estado reportado por algum componente da cadeia de mensagens. O seu significado concreto depende da implementação e do estado comunicado. Não o apresente, por si só, como prova independente de que o SMS apareceu no terminal ou de que a pessoa o leu.
Se o utilizador introduzir o código, esse evento pode confirmar que o fluxo de autenticação avançou, mas também não equivale automaticamente a uma medição pura de entrega: a ação do utilizador e outras etapas da aplicação podem influenciar o resultado. Mantenha separado o indicador técnico do estado reportado e o resultado observado no produto.
- Identifique separadamente o envio aceite, o estado reportado e a conclusão do fluxo de autenticação.
- Documente o significado dos estados de acordo com a integração concreta; não generalize códigos entre implementações.
- Quando não houver confirmação independente do terminal, explicite essa incerteza nos relatórios.
Definir limites por destino e contexto sem os transformar em garantias
Um limite agregado pode ocultar diferenças no comportamento de parte do tráfego. Quando o volume e os dados o permitirem, compare grupos relevantes, como destino ou rota, e mantenha uma perspetiva global para detetar impactos generalizados. Use identificadores de destino consistentes e documentados; o plano de segmentação deve corresponder ao que o seu sistema realmente observa.
Segmentar em excesso cria grupos com poucas amostras e resultados instáveis. Mantenha uma categoria agregada quando não houver dados suficientes para uma conclusão prudente e evite atribuir uma causa a um operador ou rota apenas porque uma métrica mudou ao mesmo tempo.
Os limites indicam quando investigar um desvio face a um objetivo ou a uma linha de base interna. Não provam que uma mensagem será entregue antes de determinado prazo, nem que uma rota terá o mesmo resultado para cada utilizador ou sessão.
- Comece por dimensões que permitam uma ação operacional concreta.
- Mantenha o volume e a cobertura dos dados junto de cada comparação.
- Não publique resultados como referências do mercado se forem provenientes de medições internas ou de amostras não comparáveis.
Conceber alertas com persistência, volume mínimo e gravidade
Um alerta acionável combina uma métrica, uma condição, uma janela e um volume suficiente para permitir a interpretação. Escolha esses elementos com base nos dados do seu próprio serviço e no tempo de resposta operacional disponível; não há valores universais verificados para os definir.
Para evitar notificações causadas por variações isoladas, pode exigir que a condição persista ou se repita em várias avaliações. Ajuste a persistência de acordo com o impacto e o risco de atrasar uma resposta. Separe os sinais de degradação da latência dos sinais de ausência de estados reportados ou de falhas na integração: exigem diagnósticos diferentes.
Atribua a gravidade de acordo com o impacto observado e a capacidade de agir, e não apenas com a distância entre uma métrica e a respetiva referência. Um alerta de investigação pode pedir a análise de uma anomalia; uma escalada deve ficar reservada às condições que a equipa definiu como relevantes para o serviço.
- Inclua no alerta a etapa, o percentil, a janela, o volume e os grupos afetados.
- Defina quem investiga e que evidências deve analisar antes de escalar.
- Sempre que possível, teste o comportamento da regra com dados históricos ou simulados, sem presumir que o teste garante o desempenho futuro.
Investigar um alerta: comparar etapas, destinos e estados
Comece por confirmar que a alteração não resulta de uma mudança na instrumentação, nos relógios, no volume ou nos critérios de inclusão. Depois, compare as durações por etapa com o tempo total: se o atraso se concentrar numa etapa, oriente a investigação para os componentes que a controlam, sem considerar a causa comprovada.
Compare a perspetiva global com os grupos por destino ou rota que tenham amostras interpretáveis. Analise separadamente os estados reportados e os casos sem estado, porque um atraso na receção de um DLR não prova, por si só, que o envio também tenha atrasado.
Registe o intervalo afetado, os grupos observados, as alterações recentes e as limitações dos dados. Se as evidências não permitirem distinguir entre causas possíveis, formule a conclusão como uma hipótese por verificar.
- Valide primeiro a integridade, o volume e a consistência das marcas temporais.
- Identifique em que intervalo surge o desvio antes de lhe atribuir uma causa.
- Compare grupos apenas quando os respetivos dados forem suficientes e comparáveis.
- Distinga ausência de estado, latência do estado e latência medida noutras etapas.
Rever limites e documentar incertezas
Os limites precisam de ser revistos quando mudam o produto, a instrumentação, o padrão de tráfego ou as condições operacionais. Mantenha o histórico de alterações e explique que evidências motivaram cada ajuste. Evite alterar uma regra apenas para silenciar um alerta sem primeiro averiguar se o sinal revela uma mudança real.
Registe as exclusões, os eventos incompletos, as dimensões com pouco volume e os limites do que cada estado permite afirmar. Estas informações ajudam a interpretar as tendências com cautela e evitam que uma medida interna seja confundida com uma garantia externa.
A BulkSMSMarket descreve uma plataforma em desenvolvimento para descobrir, comparar, comprar, vender e gerir capacidade de SMS A2P, além de uma plataforma interna de testes que observa, entre outros aspetos, a latência e a consistência dos DLR. Os indicadores numéricos públicos são demonstrativos até serem ligados a dados contratuais; não devem ser usados como métricas comerciais em tempo real nem como limites de referência.
- Guarde a definição da métrica, a regra em vigor, as respetivas exclusões e a data da revisão.
- Reavalie o limite após alterações relevantes e confirme que a comparação continua válida.
- Indique claramente o que é dado observado, o que é um objetivo interno e que incertezas permanecem.
Perguntas frequentes
Que percentil devo usar para alertar sobre a latência de OTP por SMS?
Não há um percentil universal validado para todos os serviços. Escolha a métrica de acordo com a experiência que pretende monitorizar e valide a sua estabilidade com o volume disponível. A mediana e um percentil elevado podem oferecer perspetivas complementares.
Quanto deve durar a janela de observação?
Depende do volume, do padrão de tráfego e do tempo de resposta de que a sua operação precisa. Uma janela curta reage mais depressa, mas pode ser mais sensível a variações; uma janela longa suaviza as flutuações, mas pode atrasar a deteção. Não há uma duração universal validada.
Um DLR confirma que o OTP chegou ao telefone?
Não, por si só. Um DLR é um estado reportado pela cadeia e o seu significado depende da implementação. Não equivale necessariamente a uma verificação independente da receção no terminal, nem confirma que o utilizador tenha lido a mensagem.
É conveniente criar limites diferentes por destino ou rota?
Pode ser útil se a segmentação permitir investigar uma diferença e houver dados comparáveis suficientes. Se os grupos forem pequenos, as métricas podem ser instáveis; mantenha uma perspetiva agregada e explicite a incerteza.
Os limites de alerta garantem a entrega do OTP?
Não. São controlos operacionais que assinalam desvios em métricas definidas. Não garantem a entrega, a receção dentro de um prazo específico nem um resultado idêntico para cada mensagem.
Fontes consultadas
- Azure Monitor: umbrales dinámicosMicrosoft Learn
- Especificaciones 3GPP3GPP
- ITU-T E.164International Telecommunication Union
- NIST SP 800-63-4NIST
- OWASP Authentication Cheat SheetOWASP
- GSMA: redes y tecnologíasGSMA