Latence des OTP par SMS : comment définir des seuils d’alerte utiles
Guide pratique pour décomposer la latence des OTP par étape, choisir les métriques et les fenêtres d’observation, et créer des alertes qui détectent les anomalies sans confondre un DLR avec une confirmation de réception.
Pourquoi une latence moyenne ne suffit pas pour surveiller les OTP
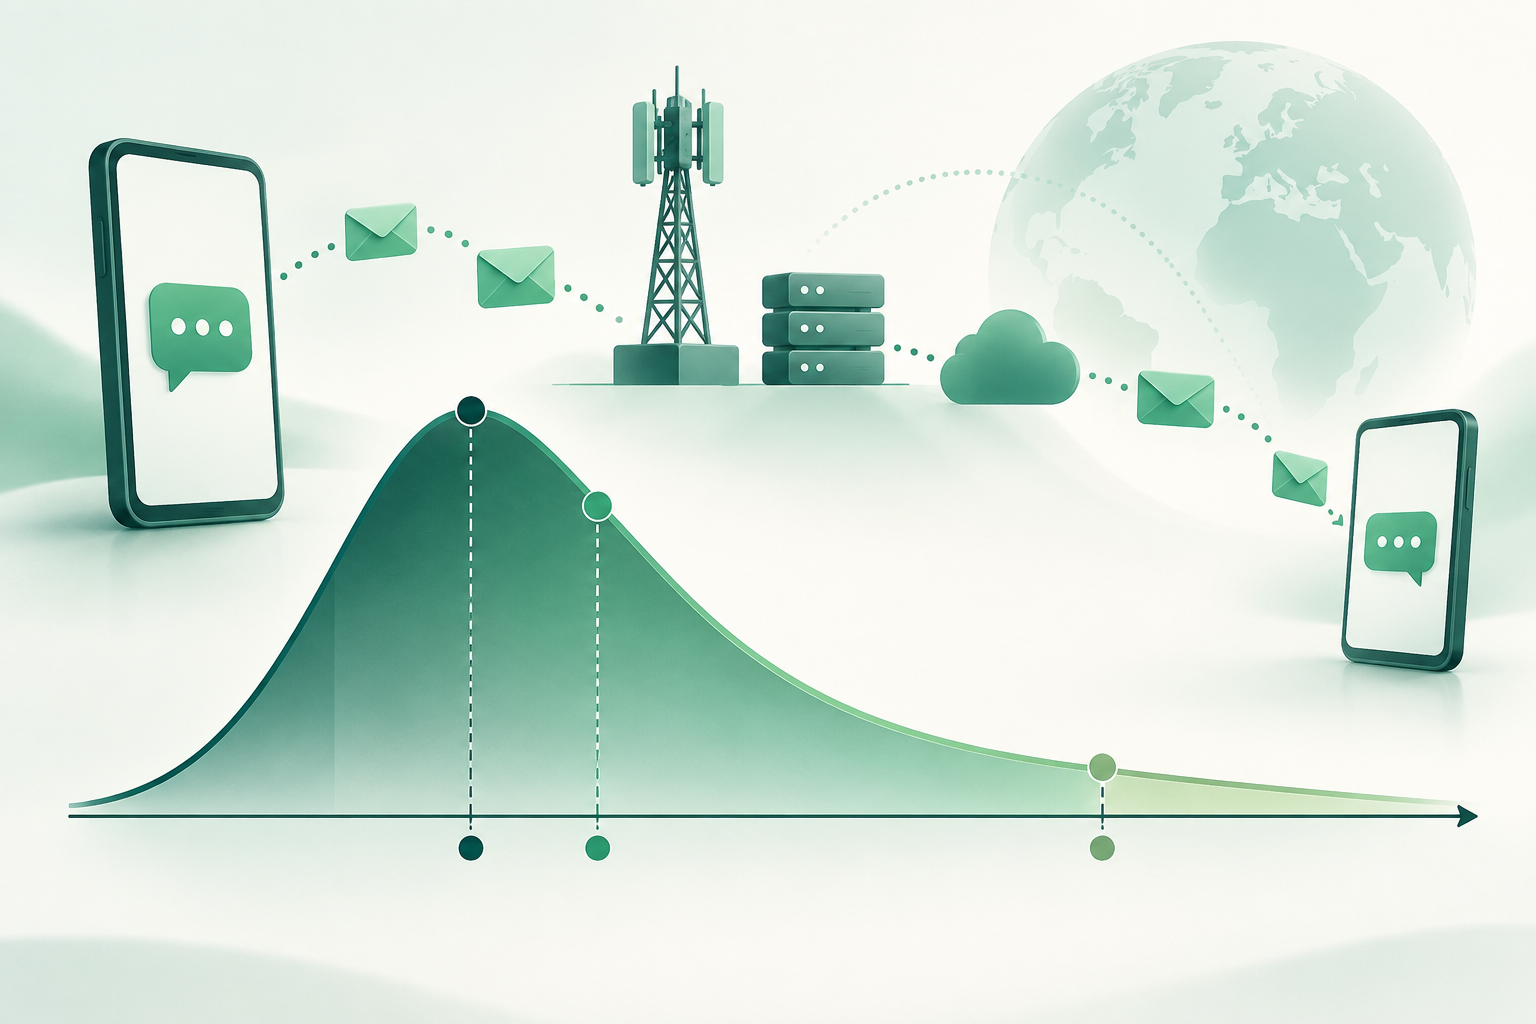
La moyenne résume l’ensemble, mais elle peut masquer une longue traîne de messages nettement plus lents qui affecte une partie des sessions. Pour surveiller les OTP, il est donc préférable d’observer la distribution des temps plutôt que de s’appuyer sur une seule moyenne.
Les percentiles permettent de répondre à différentes questions : la médiane décrit le centre de la distribution ; un percentile élevé aide à observer l’expérience des cas les plus lents sans laisser quelques valeurs extrêmes dominer la métrique. Les éléments disponibles ne permettent pas d’établir un percentile universel valable pour toutes les applications, destinations ou routes.
Avant de définir une alerte, précisez quel événement marque le début et lequel marque la fin. Si chaque composant utilise des horodatages ou des critères différents, la comparaison peut refléter des écarts de mesure plutôt qu’un changement réel du service.
- Conservez la moyenne comme indicateur complémentaire, et non comme unique signal.
- Comparez les percentiles en utilisant la même méthode de calcul et les mêmes définitions du début et de la fin.
- Interprétez chaque percentile en tenant compte du volume d’observations : un échantillon réduit peut produire des résultats instables.
Cartographier le parcours de l’OTP et répartir un budget par étape
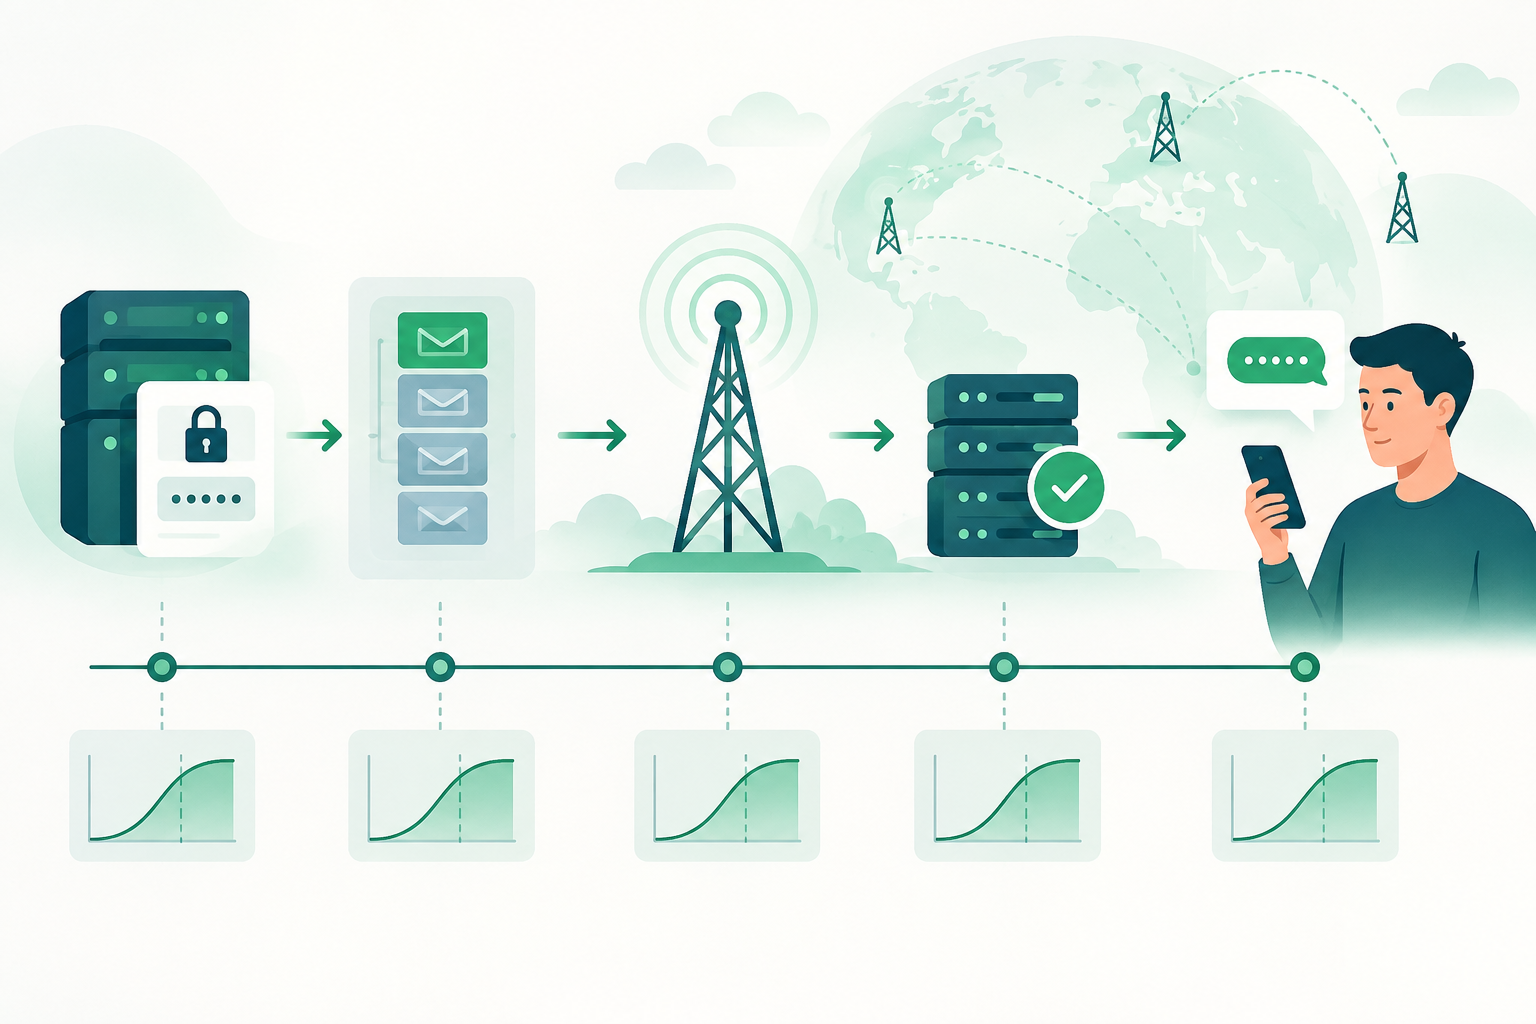
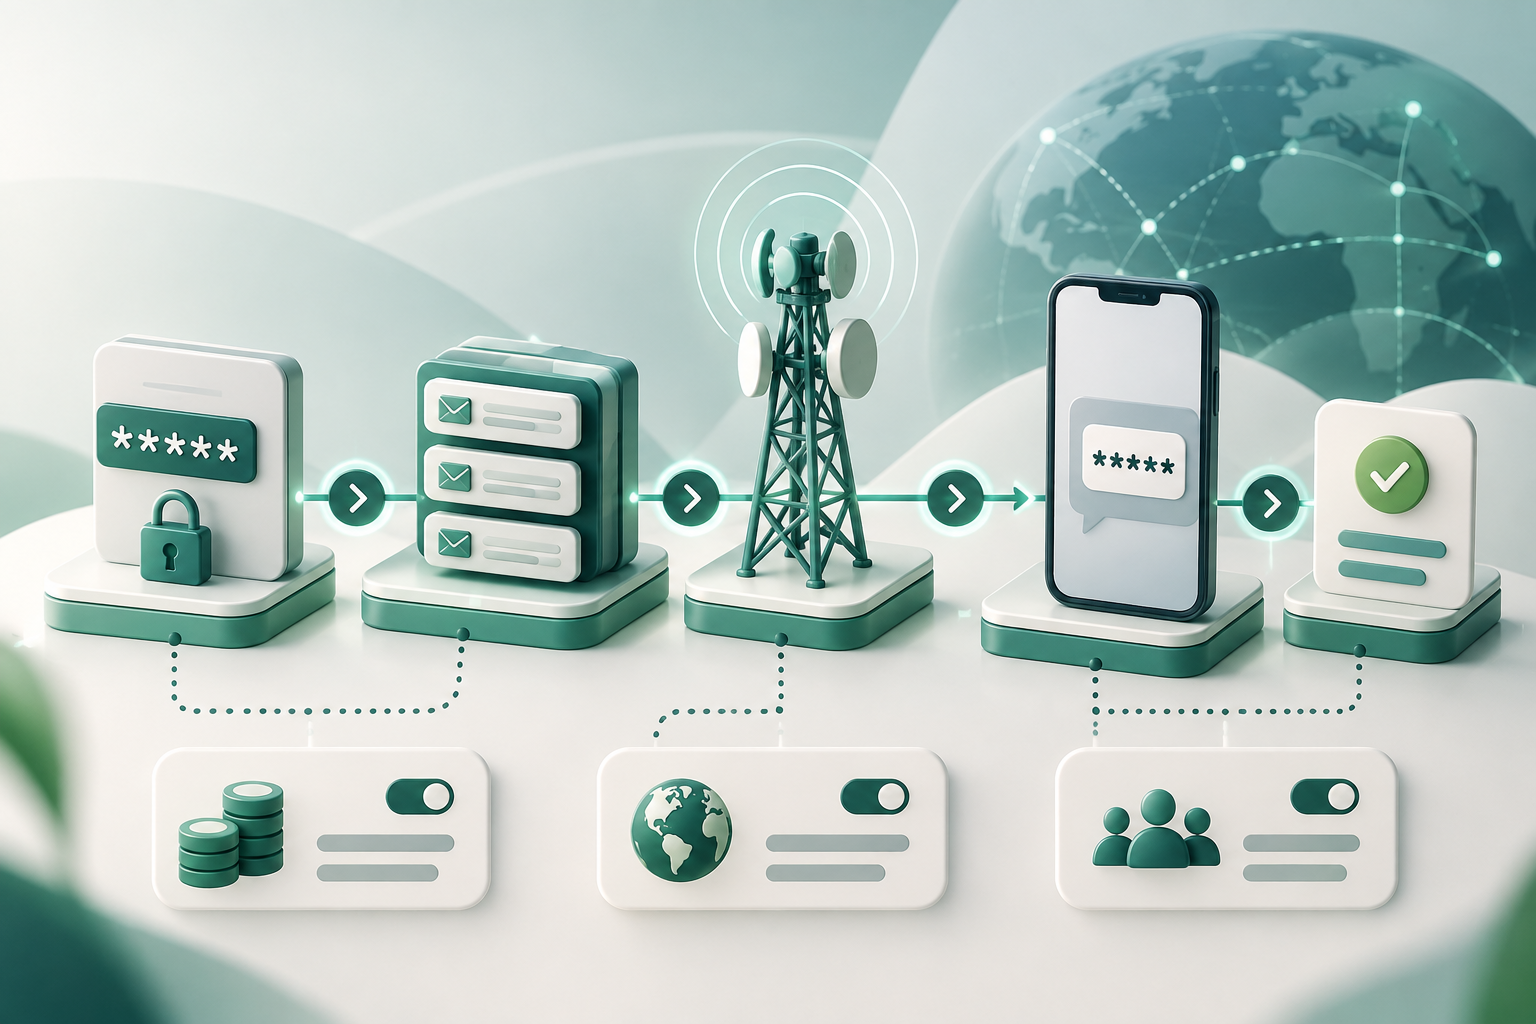
Un temps total indique seulement la durée écoulée entre deux événements choisis. Pour localiser les retards, décomposez le parcours à l’aide de vos propres horodatages : génération du code, mise en file d’attente et attente, envoi au fournisseur, puis réception d’un état signalé. Enregistrez également le moment où l’application reçoit une réponse du fournisseur, si cet événement fait partie de votre intégration.
Les événements exposés ne sont pas les mêmes sur toutes les plateformes, et l’intervalle entre deux étapes peut inclure des traitements internes, de l’attente ou de la latence de communication. Documentez ce que mesure chaque intervalle et les composants qui en sont exclus. Évitez d’additionner des durées qui se chevauchent ou de comparer des horloges qui ne sont pas suffisamment synchronisées.
Un budget par étape est un objectif opérationnel que vous définissez, et non une limite technique universelle ni une garantie de livraison. Commencez par les exigences du produit et les données observées dans des conditions normales ; répartissez le temps disponible entre les étapes que vous pouvez mesurer et contrôler. Réexaminez cette répartition si l’architecture, l’intégration ou les comportements observés changent.
- Définissez les événements de début et de fin de chaque intervalle.
- Identifiez l’équipe ou le composant en mesure d’agir sur chaque étape.
- Consignez les cas sans horodatages complets comme des données incomplètes, au lieu de leur attribuer une durée inventée.
- Ne présentez pas un objectif interne comme une promesse faite à l’utilisateur ou une garantie de livraison.
Choisir les percentiles, le volume et les fenêtres d’observation
Choisissez les métriques en fonction de la décision qu’elles doivent éclairer. La médiane peut montrer le comportement typique ; un percentile élevé peut signaler une dégradation de la longue traîne. Lorsque c’est pertinent, observez les deux, ainsi que le volume et la proportion d’événements sans résultat. Ne présentez pas une valeur comme représentative si les observations sont trop peu nombreuses.
La fenêtre d’observation doit trouver un équilibre entre réactivité et stabilité. Une fenêtre courte peut réagir rapidement, mais aussi amplifier les variations aléatoires ; une fenêtre longue lisse les fluctuations, mais peut mettre plus de temps à révéler un changement. Le choix dépend du volume, du rythme du trafic et du délai d’intervention nécessaire à l’équipe ; les éléments disponibles ne permettent pas de recommander une durée.
Si vous utilisez des seuils dynamiques, vérifiez comment l’outil apprend et s’ajuste avant de vous fier à ses alertes. La documentation de Microsoft sur Azure Monitor indique que ses seuils dynamiques utilisent dix jours de données historiques lors de la création d’une règle. Ce comportement concerne cette fonctionnalité précise et ne doit pas être considéré comme une règle générale pour d’autres systèmes.
- Consignez le percentile, la fenêtre, le volume minimal appliqué et le traitement des données incomplètes.
- Vérifiez que la fenêtre contient suffisamment d’événements pour que la métrique soit interprétable dans votre contexte.
- Avant de considérer une variation brève comme un incident, évaluez si le changement est durable et pertinent.
Distinguer la latence d’envoi, la réception d’un DLR et la confirmation de l’utilisateur
Distinguez les jalons dans vos métriques. La réponse à une demande d’envoi, un état ultérieur signalé par la chaîne et une confirmation dans l’application sont des événements différents. Mesurez chacun avec son propre horodatage et nommez-le explicitement.
Un DLR est un état signalé par un composant de la chaîne de messagerie. Sa signification précise dépend de l’implémentation et de l’état communiqué. À lui seul, il ne constitue pas une preuve indépendante que le SMS est apparu sur le terminal ou que la personne l’a lu.
Si l’utilisateur saisit le code, cet événement peut confirmer que le parcours d’authentification a progressé, mais il ne correspond pas automatiquement à une mesure pure de la livraison : l’action de l’utilisateur et d’autres étapes de l’application peuvent intervenir. Distinguez l’indicateur technique d’état signalé du résultat observé dans le produit.
- Étiquetez séparément l’envoi accepté, l’état signalé et la fin du parcours d’authentification.
- Documentez la signification des états selon l’intégration concernée ; ne généralisez pas les codes d’une implémentation à l’autre.
- En l’absence de confirmation indépendante du terminal, indiquez cette incertitude dans les rapports.
Définir des seuils par destination et par contexte sans en faire des garanties
Un seuil agrégé peut masquer un comportement différent pour une partie du trafic. Lorsque le volume et les données le permettent, comparez des groupes pertinents, tels que la destination ou la route, tout en conservant une vue globale pour détecter les impacts étendus. Utilisez des identifiants de destination cohérents et documentés ; adaptez la segmentation à ce que votre système observe réellement.
Une segmentation trop poussée crée des groupes avec trop peu d’échantillons et des résultats instables. Conservez une catégorie agrégée lorsque les données ne suffisent pas à tirer une conclusion prudente, et n’attribuez pas une cause à un opérateur ou à une route simplement parce qu’une métrique a changé au même moment.
Les seuils indiquent quand examiner un écart par rapport à un objectif ou à une référence interne. Ils ne prouvent pas qu’un message sera livré avant une échéance, ni qu’une route donnera le même résultat pour chaque utilisateur ou session.
- Commencez par des dimensions qui permettent de prendre une mesure opérationnelle concrète.
- Associez à chaque comparaison le volume et la couverture des données.
- Ne publiez pas de résultats comme des références du marché s’ils proviennent de mesures internes ou d’échantillons non comparables.
Concevoir des alertes avec persistance, volume minimal et niveau de gravité
Une alerte exploitable combine une métrique, une condition, une fenêtre et un volume suffisant pour interpréter les résultats. Choisissez ces éléments à partir des données de votre propre service et du délai de réponse opérationnel disponible ; aucune valeur universelle vérifiée ne permet de les fixer.
Pour éviter les notifications déclenchées par des variations isolées, vous pouvez exiger que la condition persiste ou se répète lors de plusieurs évaluations. Ajustez la persistance en fonction de l’impact et du risque de retarder une intervention. Distinguez les signaux de dégradation de la latence de ceux liés à l’absence d’états signalés ou à des défaillances d’intégration : ils nécessitent des diagnostics différents.
Attribuez le niveau de gravité en fonction de l’impact observé et de la capacité à agir, pas uniquement de l’écart entre une métrique et sa référence. Une alerte d’investigation peut demander l’examen d’une anomalie ; réservez l’escalade aux conditions que l’équipe a définies comme importantes pour le service.
- Incluez dans l’alerte l’étape, le percentile, la fenêtre, le volume et les groupes concernés.
- Définissez qui mène l’investigation et quels éléments doivent être examinés avant l’escalade.
- Lorsque c’est possible, testez le comportement de la règle à l’aide de données historiques ou simulées, sans supposer que le test garantit les performances futures.
Enquêter sur une alerte : comparer les étapes, les destinations et les états
Commencez par vérifier que le changement ne résulte pas d’une modification de l’instrumentation, des horloges, du volume ou des critères d’inclusion. Comparez ensuite les durées par étape avec le temps total : si le retard se concentre sur une étape, orientez l’investigation vers les composants qui la contrôlent, sans considérer une cause comme démontrée.
Comparez la vue globale aux groupes par destination ou par route dont les échantillons sont interprétables. Examinez séparément les états signalés et les cas sans état, car un retard dans la réception d’un DLR ne prouve pas à lui seul que l’envoi a également été retardé.
Consignez l’intervalle concerné, les groupes observés, les changements récents et les limites des données. Si les éléments disponibles ne permettent pas de départager les causes possibles, formulez la conclusion comme une hypothèse à vérifier.
- Vérifiez d’abord l’intégrité et le volume des données, ainsi que la cohérence des horodatages.
- Repérez l’intervalle où l’écart apparaît avant d’en attribuer la cause.
- Ne comparez des groupes que si leurs données sont suffisantes et comparables.
- Distinguez l’absence d’état, la latence de l’état et la latence mesurée à d’autres étapes.
Réexaminer les seuils et documenter les incertitudes
Les seuils doivent être réexaminés lorsque le produit, l’instrumentation, les habitudes de trafic ou les conditions opérationnelles changent. Conservez l’historique des modifications et expliquez les éléments qui ont motivé chaque ajustement. Évitez de modifier une règle uniquement pour faire taire une alerte sans avoir d’abord déterminé si le signal révèle un changement réel.
Consignez les exclusions, les événements incomplets, les dimensions avec un faible volume et les limites de ce que chaque état permet d’affirmer. Ces informations aident à interpréter les tendances avec prudence et évitent de confondre une mesure interne avec une garantie externe.
Les cartes numériques publiques restent démonstratives jusqu’à ce que des données contractuelles y soient connectées. Elles ne doivent pas être utilisées comme métriques commerciales en temps réel ni comme seuils de référence.
- Conservez la définition de la métrique, la règle en vigueur, ses exclusions et la date de révision.
- Réévaluez le seuil après tout changement important et vérifiez que la comparaison reste valide.
- Précisez clairement ce qui relève de données observées, d’un objectif interne et de l’incertitude restante.
Questions fréquentes
Quel percentile utiliser pour déclencher une alerte sur la latence des OTP par SMS ?
Aucun percentile universel n’est établi pour tous les services. Choisissez la métrique en fonction de l’expérience que vous souhaitez surveiller et vérifiez sa stabilité au regard du volume disponible. La médiane et un percentile élevé peuvent offrir des perspectives complémentaires.
Quelle doit être la durée de la fenêtre d’observation ?
Elle dépend du volume, du profil de trafic et du délai de réponse nécessaire à vos opérations. Une fenêtre courte réagit plus vite, mais peut être plus sensible aux variations ; une fenêtre longue lisse les fluctuations, mais peut retarder la détection. Aucune durée universelle n’est établie.
Un DLR confirme-t-il que l’OTP est arrivé sur le téléphone ?
Pas à lui seul. Un DLR est un état signalé par la chaîne et sa signification dépend de l’implémentation. Il n’équivaut pas nécessairement à une vérification indépendante de la réception sur le terminal et ne confirme pas que l’utilisateur a lu le message.
Faut-il définir des seuils différents par destination ou par route ?
Cela peut être utile si la segmentation permet d’enquêter sur un écart et si les données sont suffisamment nombreuses et comparables. Si les groupes sont de petite taille, leurs métriques peuvent être instables ; conservez une vue agrégée et exprimez l’incertitude.
Les seuils d’alerte garantissent-ils la livraison de l’OTP ?
Non. Ce sont des contrôles opérationnels destinés à signaler des écarts dans des métriques définies. Ils ne garantissent ni la livraison, ni la réception dans un délai précis, ni un résultat identique pour chaque message.
Sources consultées
- Azure Monitor: umbrales dinámicosMicrosoft Learn
- Especificaciones 3GPP3GPP
- ITU-T E.164International Telecommunication Union
- NIST SP 800-63-4NIST
- OWASP Authentication Cheat SheetOWASP
- GSMA: redes y tecnologíasGSMA