Continuidade operacional em SMS A2P: RTO, RPO e prioridades de tráfego
Guia prático para criar um plano de continuidade operacional de SMS A2P: definir RTO e RPO, classificar o tráfego, controlar tentativas e distinguir redundância técnica de entrega confirmada.
Que problema um plano de continuidade operacional resolve no SMS A2P
Um plano de continuidade operacional de SMS A2P define como manter ou recuperar os processos de mensagens após uma interrupção, com decisões previamente aprovadas sobre que tráfego pode continuar, que tráfego deve aguardar e que comunicações exigem um procedimento alternativo. Não é apenas um documento de comutação técnica: coordena processos, pessoas, dados, controlos e comunicações.
No SMS A2P, o problema não se resume a uma ligação SMPP ou HTTP estar disponível. Um serviço pode aceitar pedidos de envio e, ainda assim, não ter evidência final de entrega. Também pode perder callbacks, receber DLRs tardios ou ficar com incerteza sobre mensagens submetidas antes de uma falha. O plano deve separar estas situações para não transformar uma recuperação parcial numa promessa de entregabilidade.
O ponto de partida é o processo de negócio. Um OTP com uma janela de validade curta, um alerta transacional, uma notificação operacional e uma campanha de marketing com consentimento podem exigir decisões completamente diferentes perante o mesmo incidente.
- Definir que processos de negócio dependem de SMS e quem os controla.
- Identificar o impacto de atrasar, duplicar, suprimir ou reenviar cada tipo de mensagem.
- Estabelecer responsáveis técnicos e responsáveis pelas decisões de negócio.
- Documentar como a evidência de cada mensagem é preservada durante e após a contingência.
RTO e RPO aplicados a mensagens: o que significam e o que não podem garantir
O RTO, ou objetivo de tempo de recuperação, é o tempo máximo durante o qual um recurso pode permanecer indisponível antes de o impacto se tornar inaceitável para os processos que suporta. Num serviço de SMS A2P, convém defini-lo por capacidade ou processo: por exemplo, a capacidade de aceitar pedidos, gerar um identificador interno, enviar para um fornecedor, receber callbacks ou reconciliar estados.
O RPO, ou objetivo de ponto de recuperação, define até que momento anterior à interrupção os dados devem poder ser recuperados. Nas mensagens, o dado relevante não é apenas o conteúdo do SMS. Inclui a intenção de envio, a classe de tráfego, o identificador interno, o remetente utilizado, a hora, o pedido de DLR, a resposta de aceitação, o identificador atribuído pelo SMSC quando existir e os eventos posteriores.
Nem o RTO nem o RPO garantem que um SMS chegue ao terminal. O RTO refere-se à recuperação de uma capacidade operacional; o RPO refere-se à limitação da perda de dados ou de estado. A entregabilidade final depende de estados e confirmações posteriores, que devem ser avaliados separadamente.
O RTO deve deixar margem dentro do tempo máximo de interrupção tolerável. Se for necessário reprocessar mensagens, consultar estados ou rever duplicados antes de retomar a operação, esse tempo também consome o prazo disponível.
- RTO de aceitação: prazo para voltar a aceitar tráfego de forma controlada.
- RTO de envio: prazo para voltar a submeter tráfego autorizado à conectividade disponível.
- RTO de observabilidade: prazo para recuperar registos, callbacks, consultas e alertas.
- RPO da intenção de envio: perda máxima tolerável de pedidos registados.
- RPO de estado: perda máxima tolerável de alterações de estado, identificadores e decisões de contingência.
Inventário de dependências: não planeie apenas a rota
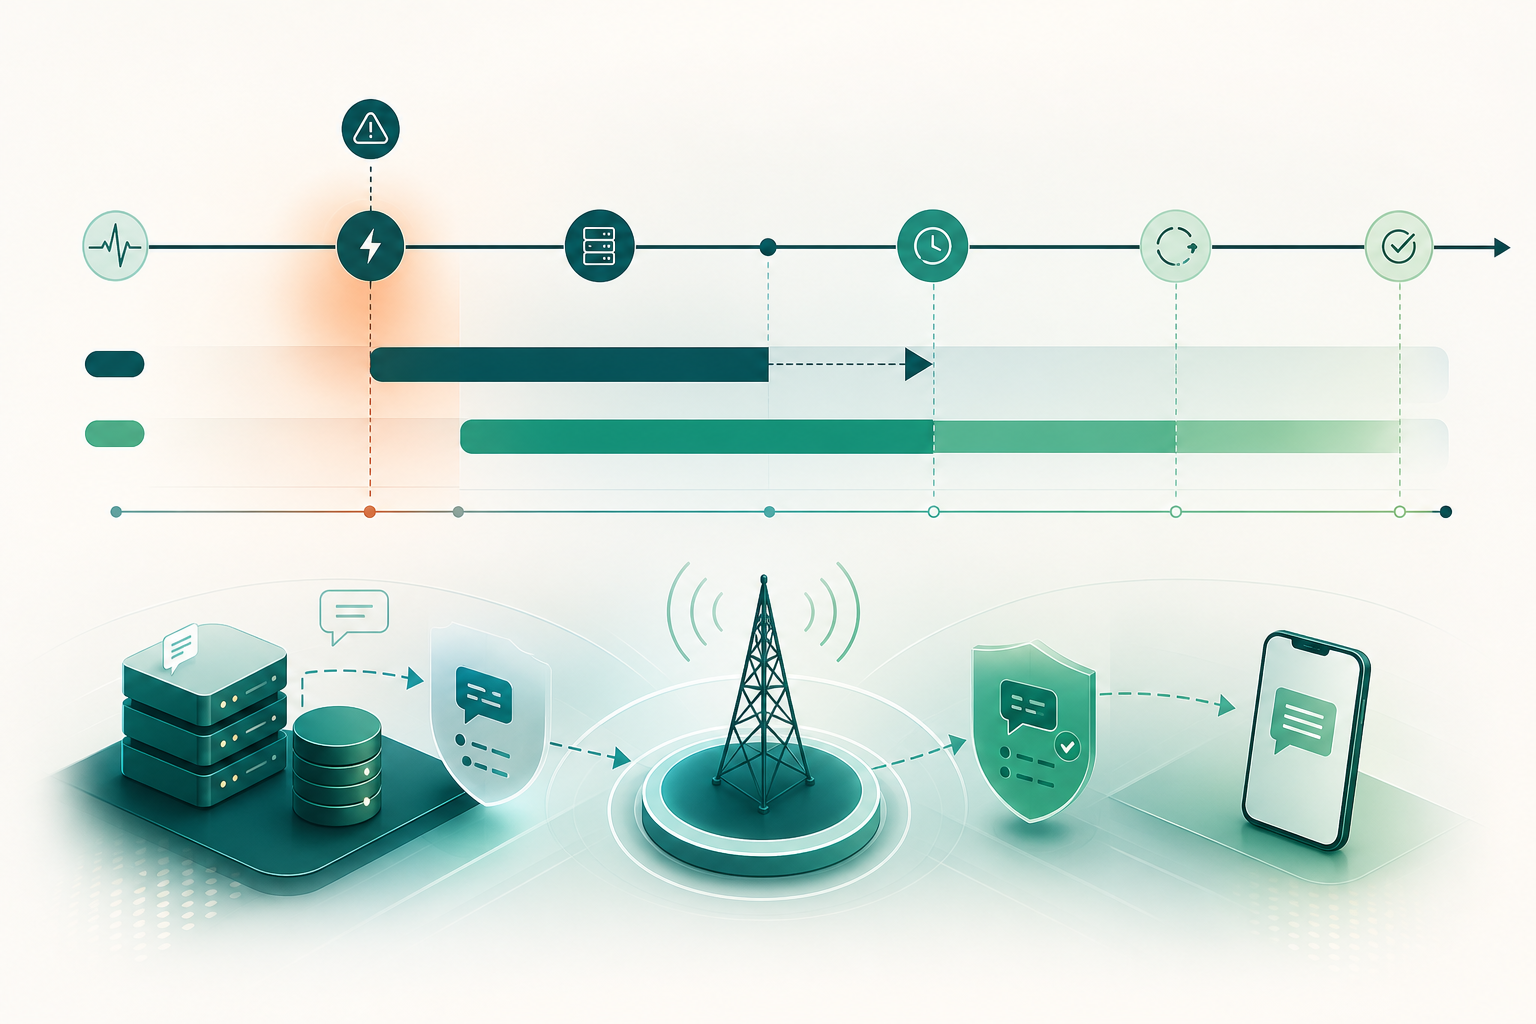
Uma rota ou ligação alternativa pode ser uma dependência importante, mas não é o serviço completo. O inventário deve percorrer o fluxo desde a aplicação que solicita o envio até ao registo posterior dos estados. Se um elemento não identificado falhar, a comutação de fornecedor pode não restaurar o processo de negócio.
Documente dependências técnicas, operacionais e de controlo. Para cada uma, indique o proprietário, o mecanismo de recuperação, as credenciais necessárias, a observabilidade disponível e o efeito da indisponibilidade. Identifique também pontos únicos de falha e dependências partilhadas entre opções aparentemente redundantes.
No SMPP, o SMSC pode atribuir um identificador quando aceita uma mensagem, e o DLR posterior pode referir-se a esse identificador. Por isso, a capacidade de conservar e correlacionar IDs faz parte da recuperação. Sem essa correlação, uma operação pode não saber se uma mensagem foi reenviada, aceite por mais de uma via ou reportada tardiamente.
- Aplicação emissora, fila interna e armazenamento de pedidos.
- Credenciais, autorizações e gestão segura de acessos.
- Conectividade HTTP ou SMPP, sessões, limites e supervisão técnica.
- Fornecedor, SMSC ou interligação disponível para o tráfego autorizado.
- Remetente, regras aplicáveis e configuração por destino.
- Identificadores internos e externos para correlação.
- Callbacks, DLRs, consultas de estado e tratamento de eventos assíncronos.
- Registos persistentes, alertas, painéis e procedimentos de comunicação.
Classificar o tráfego por impacto antes de ocorrer o incidente
A prioridade não deve basear-se apenas no volume, no cliente ou na rota disponível. Deve basear-se no impacto de a mensagem chegar tarde, não chegar ou chegar duas vezes. A classificação deve ser acordada com os proprietários do processo de negócio e transformada em regras operacionais acionáveis.
Os OTPs costumam ser sensíveis ao tempo, mas isso não autoriza o reenvio indiscriminado. Se existir incerteza sobre uma tentativa anterior, um novo OTP pode ser preferível a reenviar o mesmo código, desde que o processo de autenticação e a política de segurança o permitam. A decisão pertence ao desenho do processo, não a uma regra universal de transporte.
Os alertas transacionais e operacionais exigem a avaliação das consequências de duplicação, ordem e validade. O marketing com consentimento normalmente permite uma pausa mais segura do que uma comutação acelerada, sobretudo se não for possível preservar a rastreabilidade ou aplicar as regras adequadas de frequência e consentimento.
- OTP e autenticação: prioridade elevada, janela de utilidade curta e controlo rigoroso de tentativas.
- Alertas transacionais: prioridade conforme o impacto, com atenção à ordem, duplicação e validade.
- Comunicações operacionais: avaliar se o canal SMS é indispensável ou se é adequado um procedimento alternativo autorizado.
- Marketing com consentimento: normalmente adequado para limitação ou pausa quando a evidência operacional está incompleta.
Definir modos de degradação seguros
O plano deve indicar o que fazer quando o serviço não opera em condições normais. Limitar, colocar em fila, pausar, encaminhar ou aplicar um procedimento manual são modos de degradação distintos. Cada um deve ter condições de entrada, responsável pela autorização, âmbito, duração máxima de revisão e critérios de saída.
Limitar reduz o volume ou reserva capacidade para uma classe prioritária. Colocar em fila preserva pedidos para tratamento posterior, mas só é adequado se a mensagem mantiver valor após o atraso e se a fila preservar o contexto necessário. Pausar evita o envio de tráfego quando este não pode ser efetuado de forma rastreável ou em conformidade. Encaminhar para um canal alternativo só é adequado quando esse canal está autorizado para o caso de uso e o processo consegue suportá-lo.
Não utilize uma rota alternativa como política automática para todo o tráfego. Antes de encaminhar, avalie se o remetente, a conectividade, os requisitos aplicáveis, a validade da mensagem, a capacidade de correlação e o risco de duplicação continuam aceitáveis.
- Limitar: reservar capacidade e reduzir envios não críticos.
- Colocar em fila: preservar mensagens apenas se a respetiva validade e contexto permitirem o processamento posterior.
- Pausar: interromper envios quando a incerteza ou o potencial incumprimento superam o benefício.
- Encaminhar: utilizar outro canal autorizado e documentado para o processo afetado.
- Procedimento manual temporário: aplicar apenas se for concebido, autorizado e rastreável.
Porque uma rota alternativa não equivale a recuperação garantida
Uma alternativa pode restaurar a capacidade de submeter tráfego a outro fornecedor, SMSC ou ligação. Isto é valioso, mas não demonstra que a mensagem anterior não foi aceite, que a nova tentativa pode utilizar o mesmo remetente, nem que o destinatário receberá a mensagem.
No SMPP, a aceitação do submit e o DLR são eventos diferentes. O SMSC pode devolver um identificador ao aceitar a mensagem, enquanto o DLR é recebido posteriormente, normalmente através de deliver_sm ou data_sm. Além disso, o pedido de DLR depende da configuração de registered_delivery e não implica que exista um recibo para cada mensagem.
De forma equivalente, um estado de envio pode refletir a aceitação por um carrier upstream, enquanto um estado de entrega requer uma confirmação posterior. Mesmo quando é registado um estado delivered, a interpretação deve respeitar a semântica documentada pelo fornecedor ou pela interligação específica. Não deve ser confundido com uma garantia absoluta e independente de receção por uma pessoa destinatária.
A redundância técnica reduz determinados riscos de disponibilidade. Não elimina restrições de destino, comportamento do remetente, perda de callbacks, incerteza anterior à comutação nem o risco de duplicar tráfego.
- A capacidade de envio alternativa não equivale a entrega confirmada.
- Uma confirmação de aceitação não substitui um DLR posterior.
- Um DLR solicitado não garante que seja recebido para todas as mensagens.
- A decisão de tentar novamente deve considerar incerteza, validade e o custo da duplicação.
Critérios de ativação: sinais, limiares e validação humana
Uma contingência não deve ser ativada apenas por uma perceção isolada nem depender de um alerta sem contexto. Defina sinais observáveis para cada dependência: erros de ligação, falhas de autenticação, indisponibilidade de callbacks, acumulação de fila, ausência anómala de estados posteriores ou rejeição de pedidos. Os limiares devem ser coerentes com a classe de tráfego e com o impacto tolerável do processo.
Para evitar alterações excessivas, atribua uma validação humana antes de aplicar medidas que modifiquem massivamente o tratamento do tráfego. A automatização pode limitar ou proteger uma fila dentro de regras pré-aprovadas, mas o encaminhamento geral, a alteração de remetente ou o reenvio de mensagens incertas exigem uma decisão explícita e registada.
O critério de ativação deve incluir o âmbito: que destinos, remetentes, classes de tráfego, ligações ou componentes estão afetados. Um incidente localizado não deve provocar uma alteração desnecessária de todo o serviço.
- Sinal técnico observado e fonte da evidência.
- Janela temporal de avaliação e âmbito afetado.
- Classe de tráfego autorizada para cada ação.
- Responsável que ativa, valida e comunica a contingência.
- Registo da decisão, da hora e das variáveis alteradas.
- Critério para rever, manter ou retirar a medida.
Preservar a rastreabilidade durante uma contingência
A continuidade depende da capacidade de explicar o que aconteceu com cada mensagem. Conserve um identificador interno persistente desde a criação do pedido e relacione, quando disponíveis, os identificadores devolvidos pela conectividade, pelo fornecedor ou pelo SMSC. Não dependa apenas do callback para registar a criação: o estado inicial pode resultar da resposta síncrona de aceitação.
Trate os callbacks e DLRs como eventos assíncronos. Podem chegar após uma alteração de rota, uma pausa ou uma nova tentativa. O registo deve manter o estado inicial, as alterações de estado, as marcas temporais, a origem do evento, a decisão aplicada e a ligação a qualquer tentativa posterior.
Conserve evidências durante o período definido pelas suas obrigações e políticas internas, aplicando minimização de dados e controlos de acesso adequados. O objetivo é conseguir reconciliar e auditar a contingência, não armazenar informação sem limite nem ampliar a utilização de dados para além da sua finalidade.
- ID interno do pedido ou chave de idempotência.
- ID de aceitação ou ID externo da mensagem, quando existir.
- Classe de tráfego, remetente, destino e marca temporal da tentativa.
- Estado inicial capturado a partir da resposta de criação ou envio.
- Eventos posteriores: callback, DLR, consulta de estado e erros.
- Decisão de contingência, responsável e motivo.
- Relação entre a tentativa original, a nova tentativa e a mensagem substituta.
Perguntas frequentes
O que é um plano de continuidade operacional de SMS A2P?
É um conjunto coordenado de procedimentos, responsáveis e medidas técnicas para recuperar ou manter processos de mensagens A2P após uma interrupção. Deve abranger o processo de negócio, as dependências técnicas, os dados de estado, as decisões de degradação e a reconciliação posterior.
Qual é a diferença entre RTO e RPO no SMS A2P?
O RTO define durante quanto tempo uma capacidade pode permanecer indisponível antes de o impacto se tornar inaceitável. O RPO define até que momento anterior à interrupção os dados e estados devem poder ser recuperados. Nenhum dos dois garante a entrega de um SMS ao destinatário.
Uma rota alternativa garante a recuperação do serviço?
Não. Pode recuperar a capacidade de submeter mensagens através de outra ligação ou fornecedor, mas não garante a entrega final, não elimina a incerteza sobre tentativas anteriores e não evita, por si só, duplicados, DLRs tardios ou restrições associadas ao remetente e ao destino.
Deve um SMS ser reenviado automaticamente se não chegar um DLR?
Não como regra geral. A ausência de um DLR não demonstra, por si só, que a mensagem não foi entregue. Antes de reenviar, devem ser avaliados a validade da mensagem, o risco de duplicação, a correlação disponível, a política do processo e a possibilidade de consultar ou reconciliar estados.
O que deve ser registado durante uma contingência de mensagens?
No mínimo, um ID interno persistente, o estado inicial, os IDs externos disponíveis, as marcas temporais, os callbacks ou DLRs recebidos, a fonte de cada evento, as novas tentativas e a decisão operacional aplicada. Isto permite reconciliar mensagens pendentes, eventos tardios e possíveis duplicados.
Com que frequência deve o plano ser testado?
Periodicamente, através de testes, formação e exercícios controlados. Cada teste deve ter responsáveis, âmbito, critérios de sucesso, critérios de saída e uma revisão posterior das alterações necessárias.
Fontes consultadas
- NIST SP 800-34 Rev. 1 — Contingency Planning Guide for Federal Information SystemsNational Institute of Standards and Technology (NIST)
- NIST CSRC — Contingency PlanningNational Institute of Standards and Technology (NIST)
- SMPP Protocol Specification v3.4, Issue 1.2SMS Forum / SMPP Developers Forum
- SMPP Delivery ReceiptsSMPP Developers Forum
- 3GPP TS 23.040 change-request portal3rd Generation Partnership Project (3GPP)
- Best Practices for Messaging Delivery Status LoggingTwilio
- Outbound Message Status in Status CallbacksTwilio
- Messages resourceTwilio
- Messaging ServicesTwilio
- Message Status StreamTwilio