Continuidad operativa en A2P SMS: RTO, RPO y prioridades de tráfico
Guía práctica para diseñar un plan de continuidad operativa A2P SMS: definir RTO y RPO, clasificar tráfico, controlar reintentos y distinguir redundancia técnica de entrega confirmada.
Qué problema resuelve un plan de continuidad operativa en A2P SMS
Un plan de continuidad operativa A2P SMS define cómo mantener o recuperar los procesos de mensajería tras una interrupción, con decisiones previamente aprobadas sobre qué tráfico puede continuar, qué tráfico debe esperar y qué comunicaciones requieren un procedimiento alternativo. No es únicamente un documento de conmutación técnica: coordina procesos, personas, datos, controles y comunicaciones.
En SMS A2P, el problema no se reduce a que una conexión SMPP o HTTP esté disponible. Un servicio puede aceptar solicitudes de envío y, aun así, no disponer de evidencia final de entrega. También puede perder callbacks, recibir DLR tardíos o quedar con incertidumbre sobre mensajes presentados antes de una caída. El plan debe separar estas situaciones para no convertir una recuperación parcial en una promesa de entregabilidad.
El punto de partida es el proceso de negocio. Un OTP con ventana de validez corta, una alerta transaccional, una notificación operativa y una campaña de marketing consentida pueden requerir decisiones completamente distintas ante el mismo incidente.
- Definir qué procesos de negocio dependen del SMS y quién los controla.
- Identificar el impacto de retrasar, duplicar, suprimir o reenviar cada tipo de mensaje.
- Establecer responsables técnicos y responsables de decisión de negocio.
- Documentar cómo se preserva la evidencia de cada mensaje durante y después de la contingencia.
RTO y RPO aplicados a mensajería: qué significan y qué no pueden prometer
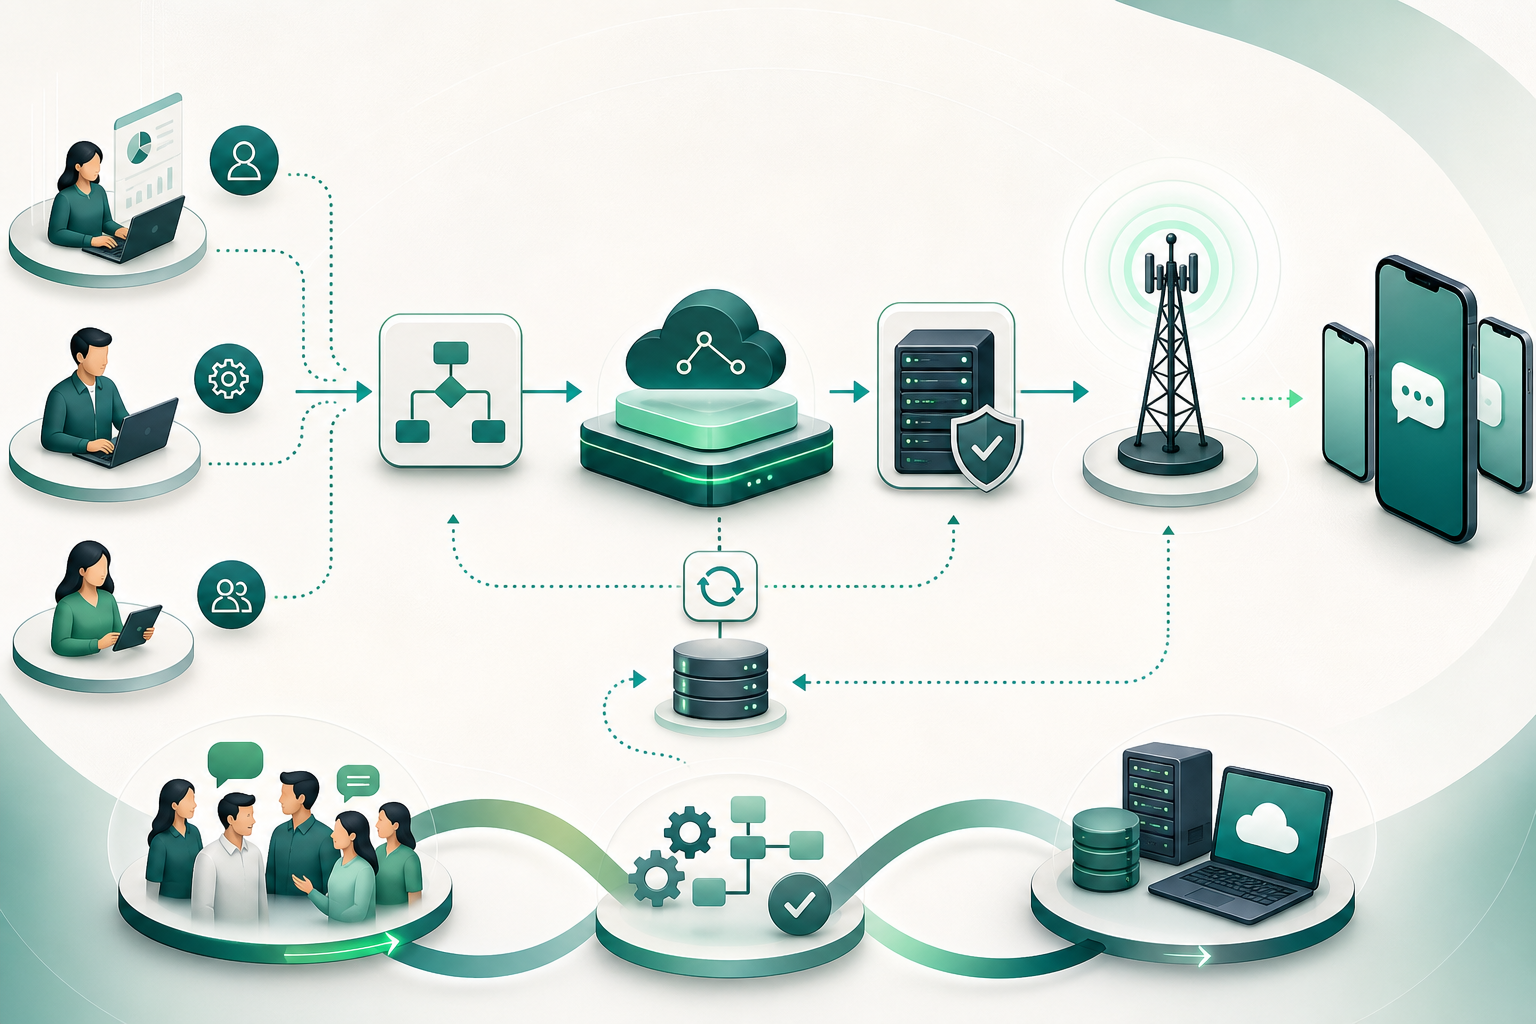
El RTO, u objetivo de tiempo de recuperación, es el tiempo máximo que un recurso puede permanecer indisponible antes de que el impacto sea inaceptable para los procesos que soporta. En un servicio A2P SMS, conviene definirlo por capacidad o proceso: por ejemplo, la capacidad de aceptar solicitudes, generar un identificador interno, enviar a un proveedor, recibir callbacks o reconciliar estados.
El RPO, u objetivo de punto de recuperación, define hasta qué momento anterior a la interrupción deben poder recuperarse los datos. En mensajería, el dato relevante no es solo el contenido del SMS. Incluye la intención de envío, la clase de tráfico, el identificador interno, el remitente usado, la hora, la solicitud de DLR, la respuesta de aceptación, el identificador asignado por el SMSC cuando exista y los eventos posteriores.
Ni RTO ni RPO garantizan que un SMS llegue al terminal. El RTO trata de recuperar una capacidad operativa; el RPO trata de limitar la pérdida de datos o de estado. La entregabilidad final depende de estados y confirmaciones posteriores, que deben evaluarse por separado.
El RTO debe dejar margen dentro del tiempo máximo de interrupción tolerable. Si se necesita reprocesar mensajes, consultar estados o revisar duplicados antes de reanudar la operación, ese tiempo también consume el plazo disponible.
- RTO de aceptación: plazo para volver a aceptar tráfico de forma controlada.
- RTO de envío: plazo para volver a presentar tráfico autorizado a la conectividad disponible.
- RTO de observabilidad: plazo para recuperar registros, callbacks, consultas y alertas.
- RPO de intención de envío: pérdida máxima tolerable de solicitudes registradas.
- RPO de estado: pérdida máxima tolerable de cambios de estado, identificadores y decisiones de contingencia.
Inventario de dependencias: no planifique solo la ruta
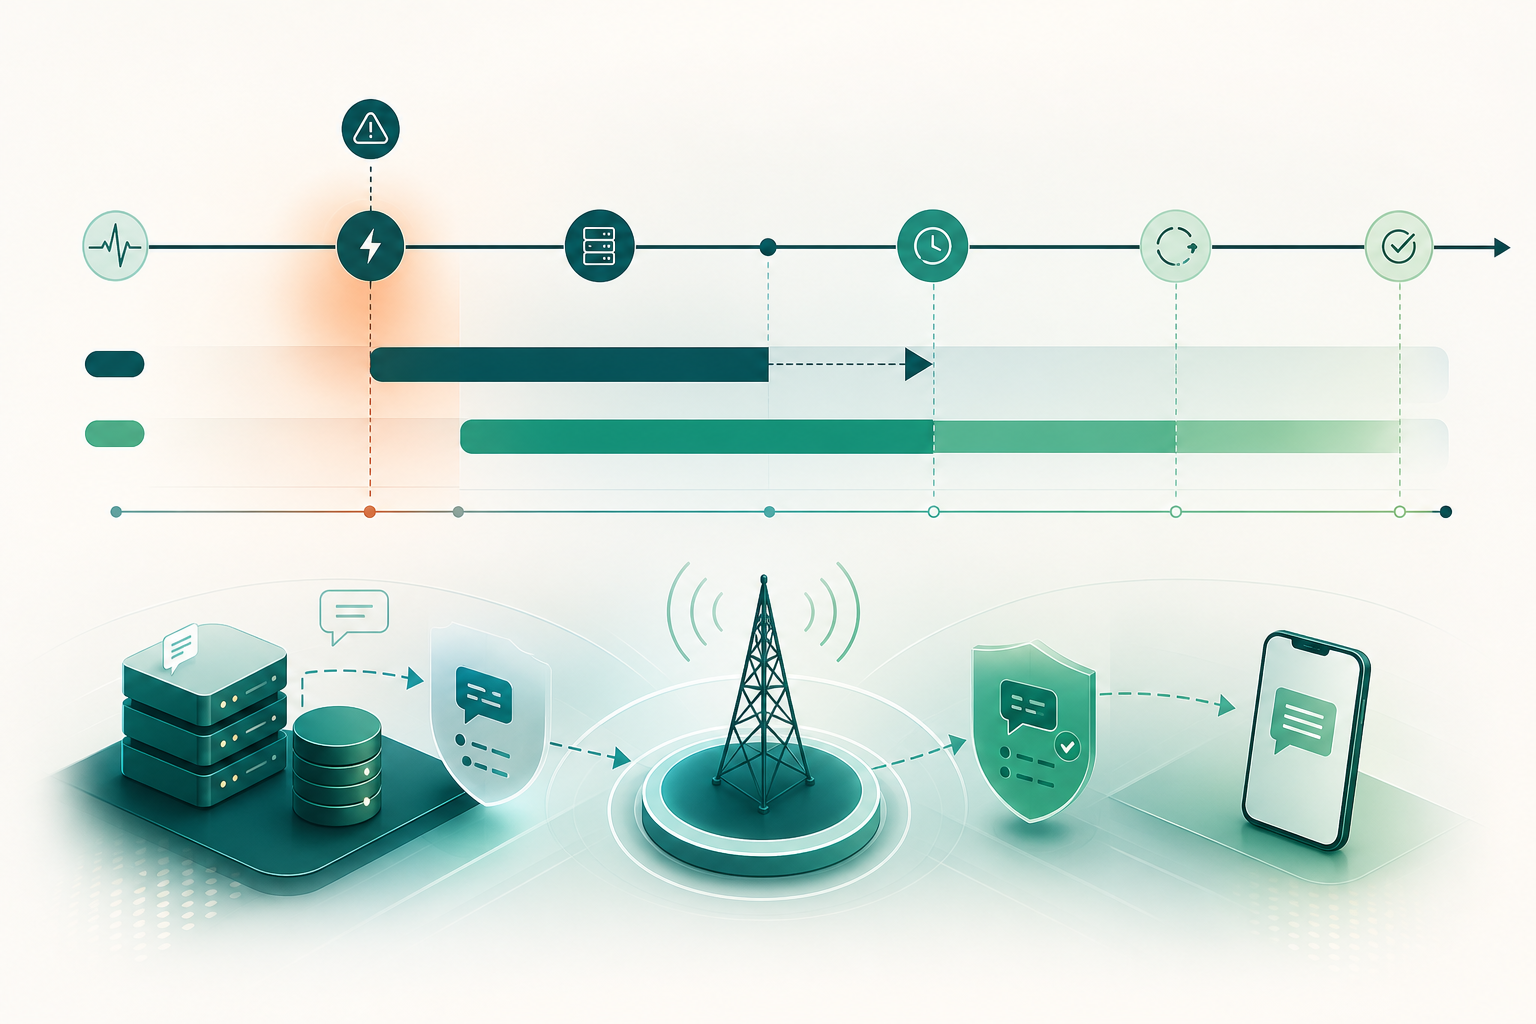
Una ruta o una conexión alternativa puede ser una dependencia importante, pero no es el servicio completo. El inventario debe recorrer el flujo desde la aplicación que solicita el envío hasta el registro posterior de estados. Si falla un elemento no identificado, la conmutación de proveedor puede no restaurar el proceso de negocio.
Documente dependencias técnicas, operativas y de control. Para cada una, indique propietario, mecanismo de recuperación, credenciales requeridas, observabilidad disponible y efecto de la indisponibilidad. Identifique también puntos únicos de fallo y dependencias compartidas entre opciones aparentemente redundantes.
En SMPP, el SMSC puede asignar un identificador cuando acepta un mensaje, y el DLR posterior puede referirse a ese identificador. Por ello, la capacidad de conservar y correlacionar IDs forma parte de la recuperación. Sin esa correlación, una operación puede no saber si un mensaje fue reenviado, aceptado por más de una vía o informado tardíamente.
- Aplicación emisora, cola interna y almacenamiento de solicitudes.
- Credenciales, autorizaciones y gestión segura de acceso.
- Conectividad HTTP o SMPP, sesiones, límites y supervisión técnica.
- Proveedor, SMSC o interconexión disponible para el tráfico autorizado.
- Remitente, reglas aplicables y configuración por destino.
- Identificadores internos y externos para correlación.
- Callbacks, DLR, consultas de estado y tratamiento de eventos asíncronos.
- Registros persistentes, alertas, paneles y procedimientos de comunicación.
Clasificar el tráfico por impacto antes de que ocurra el incidente
La prioridad no debe basarse únicamente en el volumen, el cliente o la ruta disponible. Debe basarse en el impacto de que el mensaje llegue tarde, no llegue o llegue dos veces. La clasificación debe ser acordada con los propietarios del proceso de negocio y transformarse en reglas operativas accionables.
Los OTP suelen ser sensibles al tiempo, pero eso no autoriza el reenvío indiscriminado. Si existe incertidumbre sobre un intento anterior, un nuevo OTP puede ser preferible a reenviar el mismo código, siempre que el proceso de autenticación y la política de seguridad lo permitan. La decisión corresponde al diseño del proceso, no a una regla universal de transporte.
Las alertas transaccionales y operativas requieren evaluar consecuencias de duplicación, orden y vigencia. El marketing consentido normalmente admite una pausa más segura que una conmutación acelerada, especialmente si no se puede preservar la trazabilidad o aplicar las reglas de frecuencia y consentimiento correspondientes.
- OTP y autenticación: prioridad alta, ventana de utilidad corta y control estricto de reintentos.
- Alertas transaccionales: prioridad según impacto, con atención a orden, duplicación y vigencia.
- Comunicaciones operativas: evaluar si el canal SMS es imprescindible o si procede un procedimiento alternativo autorizado.
- Marketing consentido: normalmente apto para limitación o pausa cuando la evidencia operativa es incompleta.
Definir modos de degradación seguros
El plan debe indicar qué hacer cuando el servicio no opera en condiciones normales. Limitar, encolar, pausar, derivar o aplicar un procedimiento manual son modos de degradación distintos. Cada uno debe tener condiciones de entrada, responsable de autorización, alcance, duración máxima de revisión y criterios de salida.
Limitar reduce el volumen o reserva capacidad para una clase prioritaria. Encolar conserva solicitudes para su tratamiento posterior, pero solo es apropiado si el mensaje mantiene valor tras el retraso y si la cola preserva el contexto necesario. Pausar evita enviar tráfico cuando no puede hacerse de forma trazable o conforme. Derivar a un canal alternativo solo procede cuando ese canal está autorizado para el caso de uso y el proceso puede soportarlo.
No use una ruta alternativa como política automática para todo el tráfico. Antes de derivar, evalúe si el remitente, la conectividad, los requisitos aplicables, la vigencia del mensaje, la capacidad de correlación y el riesgo de duplicado siguen siendo aceptables.
- Limitar: reservar capacidad y reducir envíos no críticos.
- Encolar: conservar mensajes solo si su vencimiento y contexto permiten procesarlos más tarde.
- Pausar: detener envíos cuando la incertidumbre o el incumplimiento potencial superan el beneficio.
- Derivar: usar otro canal autorizado y documentado para el proceso afectado.
- Procedimiento manual temporal: aplicar solo si está diseñado, autorizado y es trazable.
Por qué una ruta alternativa no equivale a recuperación garantizada
Una alternativa puede restaurar la capacidad de presentar tráfico a otro proveedor, SMSC o conexión. Eso es valioso, pero no demuestra que el mensaje anterior no haya sido aceptado, que el nuevo intento pueda usar el mismo remitente, ni que el destinatario vaya a recibir el mensaje.
En SMPP, la aceptación del submit y el DLR son eventos diferentes. El SMSC puede devolver un identificador al aceptar el mensaje, mientras que el DLR se recibe posteriormente, normalmente mediante deliver_sm o data_sm. Además, la solicitud de DLR depende de la configuración de registered_delivery y no implica que exista un recibo para cada mensaje.
De forma equivalente, un estado de envío puede reflejar aceptación por un carrier ascendente, mientras que un estado de entrega requiere una confirmación posterior. Incluso cuando se registra un estado delivered, la interpretación debe respetar la semántica documentada por el proveedor o la interconexión concreta. No debe confundirse con una garantía absoluta e independiente de recepción por una persona destinataria.
La redundancia técnica reduce determinados riesgos de disponibilidad. No elimina restricciones de destino, comportamiento del remitente, pérdida de callbacks, incertidumbre previa a la conmutación ni el riesgo de duplicar tráfico.
- Capacidad de envío alternativa no equivale a entrega confirmada.
- Un acuse de aceptación no sustituye un DLR posterior.
- Un DLR solicitado no garantiza que se reciba para todos los mensajes.
- La decisión de reintentar debe considerar incertidumbre, vigencia y coste de duplicación.
Criterios de activación: señales, umbrales y validación humana
Una contingencia no debe activarse solo por una impresión aislada ni depender de una alarma sin contexto. Defina señales observables para cada dependencia: errores de conexión, fallos de autenticación, indisponibilidad de callbacks, acumulación de cola, ausencia anómala de estados posteriores o rechazo de solicitudes. Los umbrales deben ser coherentes con la clase de tráfico y con el impacto tolerable del proceso.
Para evitar cambios excesivos, asigne una validación humana antes de aplicar medidas que modifiquen masivamente el tratamiento del tráfico. La automatización puede limitar o proteger una cola dentro de reglas preaprobadas, pero la derivación general, el cambio de remitente o el reenvío de mensajes inciertos requieren una decisión explícita y registrada.
El criterio de activación debe incluir el alcance: qué destinos, remitentes, clases de tráfico, conexiones o componentes están afectados. Un incidente localizado no debe provocar una modificación innecesaria de todo el servicio.
- Señal técnica observada y fuente de la evidencia.
- Ventana temporal de evaluación y alcance afectado.
- Clase de tráfico autorizada para cada acción.
- Responsable que activa, valida y comunica la contingencia.
- Registro de la decisión, la hora y las variables modificadas.
- Criterio para revisar, mantener o retirar la medida.
Preservar la trazabilidad durante una contingencia
La continuidad depende de poder explicar qué ocurrió con cada mensaje. Conserve un identificador interno persistente desde la creación de la solicitud y relacione, cuando estén disponibles, los identificadores devueltos por la conectividad, el proveedor o el SMSC. No dependa únicamente del callback para registrar la creación: el estado inicial puede provenir de la respuesta síncrona de aceptación.
Trate los callbacks y DLR como eventos asíncronos. Pueden llegar después de un cambio de ruta, de una pausa o de un reintento. El registro debe mantener el estado inicial, los cambios de estado, marcas temporales, origen del evento, decisión aplicada y vínculo con cualquier intento posterior.
Conserve evidencia durante el periodo definido por sus obligaciones y políticas internas, aplicando minimización de datos y controles de acceso adecuados. El objetivo es poder reconciliar y auditar la contingencia, no almacenar información sin límite ni ampliar el uso de datos fuera de su finalidad.
- ID interno de solicitud o clave de idempotencia.
- ID de aceptación o ID de mensaje externo cuando exista.
- Clase de tráfico, remitente, destino y marca temporal del intento.
- Estado inicial capturado de la respuesta de creación o envío.
- Eventos posteriores: callback, DLR, consulta de estado y errores.
- Decisión de contingencia, responsable y motivo.
- Relación entre intento original, reintento y mensaje sustitutivo.
Preguntas frecuentes
¿Qué es un plan de continuidad operativa A2P SMS?
Es un conjunto coordinado de procedimientos, responsables y medidas técnicas para recuperar o mantener procesos de mensajería A2P después de una interrupción. Debe cubrir el proceso de negocio, las dependencias técnicas, los datos de estado, las decisiones de degradación y la reconciliación posterior.
¿Cuál es la diferencia entre RTO y RPO en SMS A2P?
El RTO define cuánto tiempo puede permanecer indisponible una capacidad antes de que el impacto sea inaceptable. El RPO define hasta qué punto anterior a la interrupción deben poder recuperarse los datos y estados. Ninguno de los dos garantiza la entrega de un SMS al destinatario.
¿Una ruta alternativa garantiza la recuperación del servicio?
No. Puede recuperar la capacidad de presentar mensajes mediante otra conexión o proveedor, pero no garantiza la entrega final, no elimina la incertidumbre sobre intentos previos y no evita por sí sola duplicados, DLR tardíos o restricciones asociadas al remitente y al destino.
¿Se debe reenviar automáticamente un SMS si no llega un DLR?
No como regla general. La ausencia de un DLR no demuestra por sí sola que el mensaje no se haya entregado. Antes de reenviar, debe evaluarse la vigencia del mensaje, el riesgo de duplicación, la correlación disponible, la política del proceso y la posibilidad de consultar o reconciliar estados.
¿Qué debe registrarse durante una contingencia de mensajería?
Como mínimo, un ID interno persistente, el estado inicial, los IDs externos disponibles, las marcas temporales, los callbacks o DLR recibidos, la fuente de cada evento, los reintentos y la decisión operativa aplicada. Esto permite reconciliar mensajes pendientes, eventos tardíos y posibles duplicados.
¿Con qué frecuencia debe probarse el plan?
De forma periódica mediante pruebas, formación y ejercicios controlados. Cada prueba debe tener responsables, alcance, criterios de éxito, criterios de salida y una revisión posterior de los cambios necesarios.
Fuentes consultadas
- NIST SP 800-34 Rev. 1 — Contingency Planning Guide for Federal Information SystemsNational Institute of Standards and Technology (NIST)
- NIST CSRC — Contingency PlanningNational Institute of Standards and Technology (NIST)
- SMPP Protocol Specification v3.4, Issue 1.2SMS Forum / SMPP Developers Forum
- SMPP Delivery ReceiptsSMPP Developers Forum
- 3GPP TS 23.040 change-request portal3rd Generation Partnership Project (3GPP)
- Best Practices for Messaging Delivery Status LoggingTwilio
- Outbound Message Status in Status CallbacksTwilio
- Messages resourceTwilio
- Messaging ServicesTwilio
- Message Status StreamTwilio