Continuité opérationnelle en SMS A2P : RTO, RPO et priorités de trafic
Guide pratique pour concevoir un plan de continuité opérationnelle SMS A2P : définir les RTO et RPO, classer le trafic, maîtriser les tentatives et distinguer la redondance technique de la livraison confirmée.
Quel problème résout un plan de continuité opérationnelle en SMS A2P ?
Un plan de continuité opérationnelle SMS A2P définit comment maintenir ou rétablir les processus de messagerie après une interruption, grâce à des décisions approuvées à l’avance concernant le trafic qui peut continuer, celui qui doit attendre et les communications nécessitant une procédure alternative. Il ne s’agit pas seulement d’un document de basculement technique : il coordonne les processus, les personnes, les données, les contrôles et les communications.
Dans le SMS A2P, le problème ne se limite pas à la disponibilité d’une connexion SMPP ou HTTP. Un service peut accepter des demandes d’envoi tout en ne disposant pas de preuve finale de livraison. Il peut également perdre des callbacks, recevoir des DLR tardifs ou rester dans l’incertitude concernant des messages soumis avant une panne. Le plan doit distinguer ces situations afin de ne pas transformer une récupération partielle en promesse de délivrabilité.
Le point de départ est le processus métier. Un OTP à durée de validité courte, une alerte transactionnelle, une notification opérationnelle et une campagne marketing avec consentement peuvent nécessiter des décisions totalement différentes face au même incident.
- Définir quels processus métier dépendent du SMS et qui les contrôle.
- Identifier l’impact d’un retard, d’un doublon, d’une suppression ou d’un nouvel envoi pour chaque type de message.
- Désigner les responsables techniques et les responsables des décisions métier.
- Documenter comment préserver les preuves associées à chaque message pendant et après la continuité.
RTO et RPO appliqués à la messagerie : ce qu’ils signifient et ce qu’ils ne peuvent pas garantir
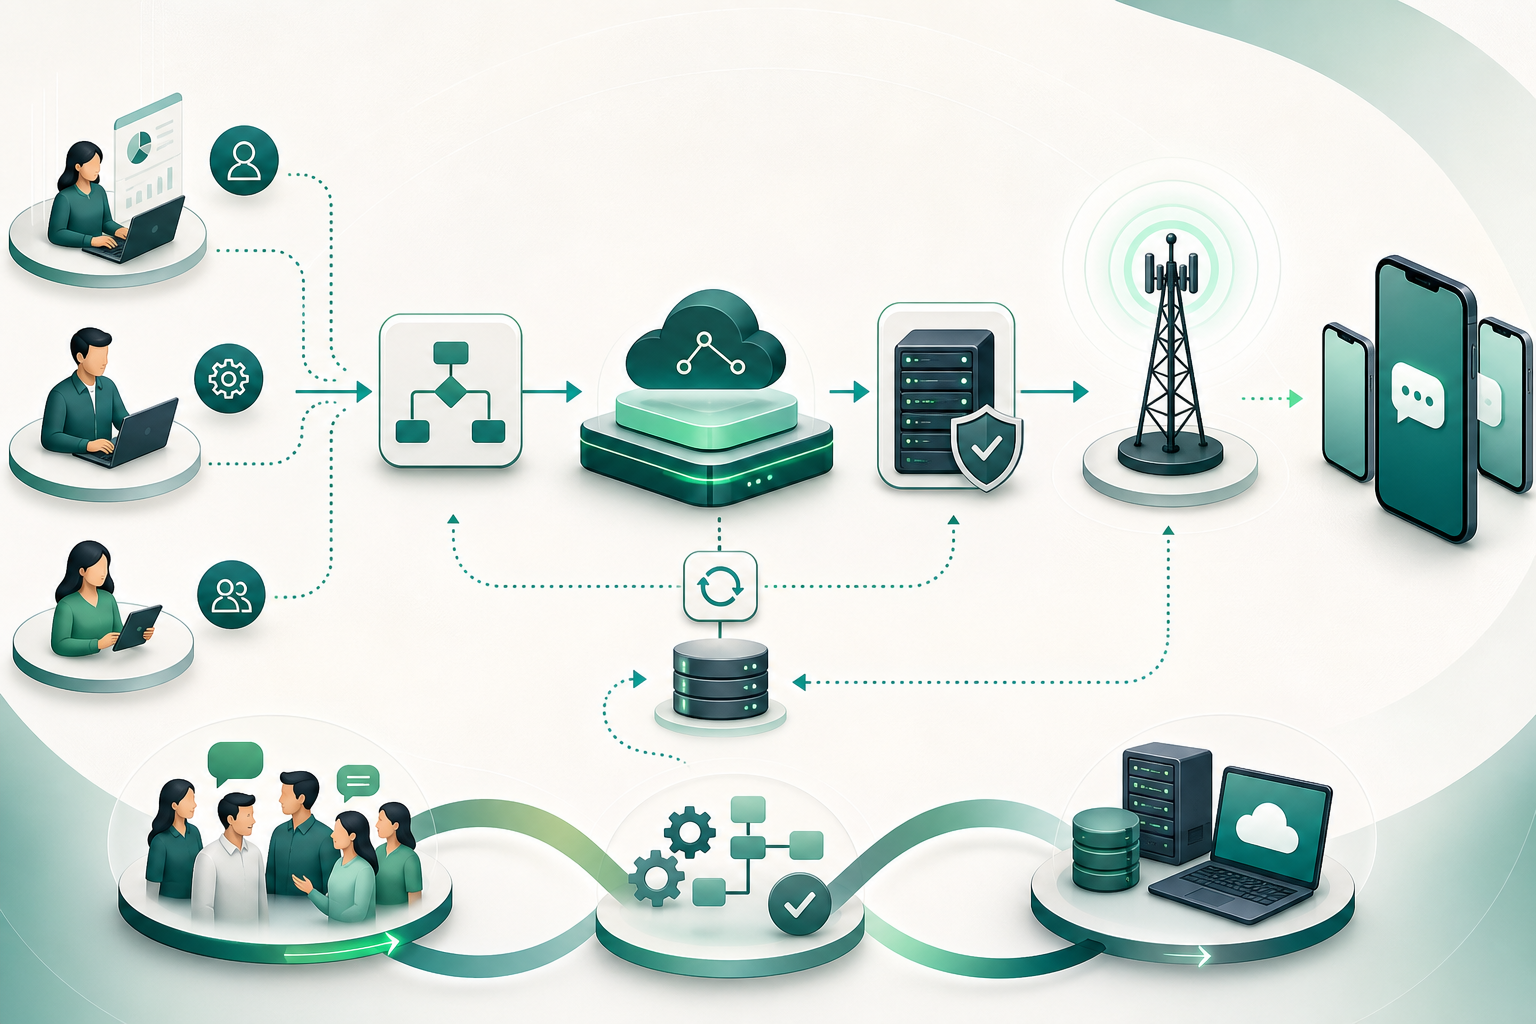
Le RTO, ou objectif de délai de reprise, correspond au temps maximal pendant lequel une ressource peut rester indisponible avant que l’impact ne devienne inacceptable pour les processus qu’elle prend en charge. Dans un service SMS A2P, il est utile de le définir par capacité ou par processus : par exemple, la capacité à accepter les demandes, générer un identifiant interne, envoyer à un fournisseur, recevoir des callbacks ou réconcilier les états.
Le RPO, ou objectif de point de reprise, définit jusqu’à quel point antérieur à l’interruption les données doivent pouvoir être récupérées. En messagerie, la donnée pertinente ne se limite pas au contenu du SMS. Elle inclut l’intention d’envoi, la classe de trafic, l’identifiant interne, l’expéditeur utilisé, l’heure, la demande de DLR, la réponse d’acceptation, l’identifiant attribué par le SMSC lorsqu’il existe et les événements ultérieurs.
Ni le RTO ni le RPO ne garantissent qu’un SMS arrive sur le terminal. Le RTO porte sur le rétablissement d’une capacité opérationnelle ; le RPO vise à limiter la perte de données ou d’état. La délivrabilité finale dépend d’états et de confirmations ultérieurs, qui doivent être évalués séparément.
Le RTO doit laisser une marge dans le délai maximal d’interruption tolérable. Si des messages doivent être retraités, des états consultés ou des doublons examinés avant la reprise des opérations, ce temps consomme également le délai disponible.
- RTO d’acceptation : délai pour recommencer à accepter le trafic de manière maîtrisée.
- RTO d’envoi : délai pour recommencer à soumettre le trafic autorisé à la connectivité disponible.
- RTO d’observabilité : délai pour rétablir les journaux, callbacks, requêtes et alertes.
- RPO de l’intention d’envoi : perte maximale tolérable de demandes enregistrées.
- RPO d’état : perte maximale tolérable de changements d’état, d’identifiants et de décisions de continuité.
Inventaire des dépendances : ne planifiez pas uniquement la route
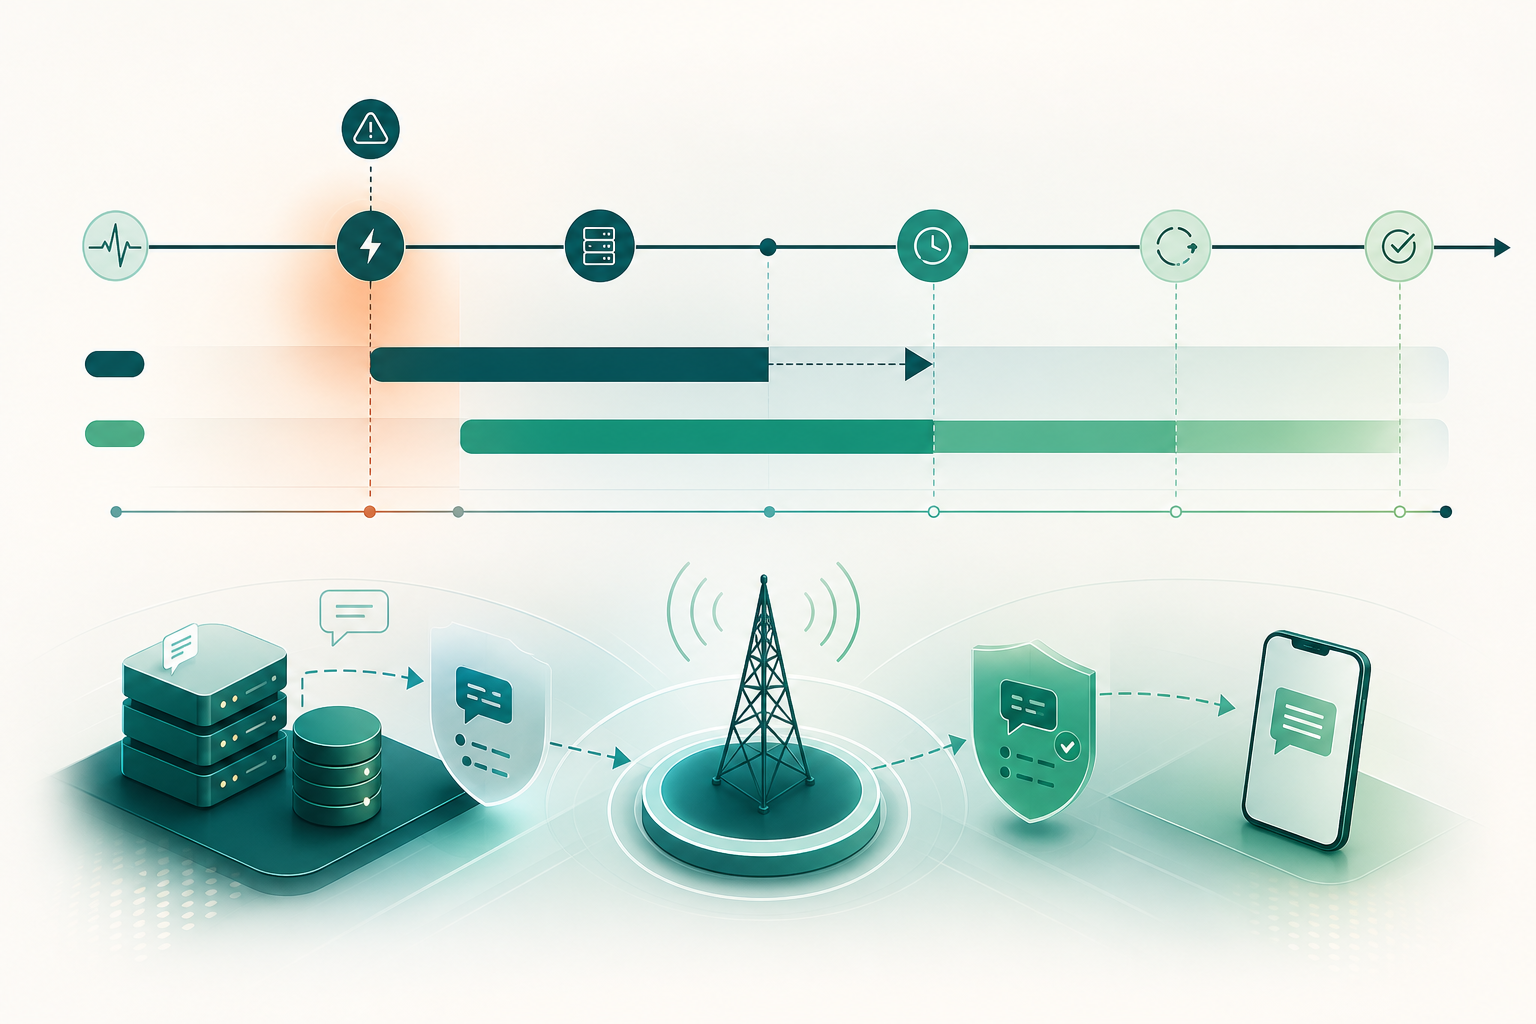
Une route ou une connexion alternative peut constituer une dépendance importante, mais elle ne représente pas le service dans son ensemble. L’inventaire doit couvrir le flux depuis l’application qui demande l’envoi jusqu’à l’enregistrement ultérieur des états. Si un élément non identifié tombe en panne, le basculement vers un autre fournisseur peut ne pas rétablir le processus métier.
Documentez les dépendances techniques, opérationnelles et de contrôle. Pour chacune, indiquez le propriétaire, le mécanisme de reprise, les identifiants requis, l’observabilité disponible et l’effet de l’indisponibilité. Identifiez également les points uniques de défaillance et les dépendances partagées entre des options apparemment redondantes.
En SMPP, le SMSC peut attribuer un identifiant lorsqu’il accepte un message, et le DLR ultérieur peut faire référence à cet identifiant. La capacité à conserver et à corréler les ID fait donc partie de la reprise. Sans cette corrélation, une opération peut ne pas savoir si un message a été renvoyé, accepté par plusieurs voies ou signalé tardivement.
- Application émettrice, file d’attente interne et stockage des demandes.
- Identifiants, autorisations et gestion sécurisée des accès.
- Connectivité HTTP ou SMPP, sessions, limites et supervision technique.
- Fournisseur, SMSC ou interconnexion disponible pour le trafic autorisé.
- Expéditeur, règles applicables et configuration par destination.
- Identifiants internes et externes de corrélation.
- Callbacks, DLR, requêtes d’état et traitement des événements asynchrones.
- Journaux persistants, alertes, tableaux de bord et procédures de communication.
Classer le trafic selon son impact avant que l’incident ne survienne
La priorité ne doit pas reposer uniquement sur le volume, le client ou la route disponible. Elle doit reposer sur l’impact d’un message reçu tardivement, non reçu ou reçu deux fois. La classification doit être convenue avec les propriétaires du processus métier et transformée en règles opérationnelles applicables.
Les OTP sont généralement sensibles au temps, mais cela n’autorise pas les renvois indiscriminés. En cas d’incertitude concernant une tentative précédente, un nouvel OTP peut être préférable au renvoi du même code, à condition que le processus d’authentification et la politique de sécurité l’autorisent. Cette décision relève de la conception du processus, et non d’une règle universelle de transport.
Les alertes transactionnelles et opérationnelles nécessitent une évaluation des conséquences liées aux doublons, à l’ordre et à la validité. Le marketing avec consentement se prête généralement davantage à une pause sûre qu’à un basculement accéléré, en particulier lorsqu’il n’est pas possible de préserver la traçabilité ou d’appliquer les règles de fréquence et de consentement appropriées.
- OTP et authentification : priorité élevée, fenêtre d’utilité courte et contrôle strict des tentatives.
- Alertes transactionnelles : priorité selon l’impact, avec attention portée à l’ordre, aux doublons et à la validité.
- Communications opérationnelles : évaluer si le canal SMS est indispensable ou si une procédure alternative autorisée est appropriée.
- Marketing avec consentement : généralement adapté à une limitation ou à une pause lorsque les preuves opérationnelles sont incomplètes.
Définir des modes dégradés sûrs
Le plan doit indiquer ce qu’il faut faire lorsque le service ne fonctionne pas dans des conditions normales. Limiter, mettre en file d’attente, suspendre, rediriger ou appliquer une procédure manuelle sont des modes dégradés distincts. Chacun doit comporter des conditions d’entrée, un responsable de l’autorisation, un périmètre, une durée maximale avant révision et des critères de sortie.
La limitation réduit le volume ou réserve la capacité à une classe prioritaire. La mise en file d’attente conserve les demandes pour un traitement ultérieur, mais n’est appropriée que si le message conserve sa valeur après le retard et si la file préserve le contexte nécessaire. La suspension évite l’envoi de trafic lorsqu’il ne peut pas être traité de manière traçable ou conforme. La redirection vers un canal alternatif ne s’applique que si ce canal est autorisé pour le cas d’usage et si le processus peut le prendre en charge.
N’utilisez pas une route alternative comme politique automatique pour l’ensemble du trafic. Avant de rediriger, évaluez si l’expéditeur, la connectivité, les exigences applicables, la validité du message, la capacité de corrélation et le risque de doublon restent acceptables.
- Limiter : réserver de la capacité et réduire les envois non critiques.
- Mettre en file d’attente : conserver les messages uniquement si leur expiration et leur contexte permettent un traitement ultérieur.
- Suspendre : arrêter les envois lorsque l’incertitude ou le risque de non-conformité dépasse le bénéfice.
- Rediriger : utiliser un autre canal autorisé et documenté pour le processus concerné.
- Procédure manuelle temporaire : l’appliquer uniquement si elle est conçue, autorisée et traçable.
Pourquoi une route alternative n’équivaut pas à une reprise garantie
Une alternative peut rétablir la capacité à soumettre du trafic à un autre fournisseur, SMSC ou via une autre connexion. C’est utile, mais cela ne prouve pas que le message précédent n’a pas été accepté, que la nouvelle tentative peut utiliser le même expéditeur ou que le destinataire recevra le message.
En SMPP, l’acceptation du submit et le DLR sont des événements distincts. Le SMSC peut renvoyer un identifiant lors de l’acceptation du message, tandis que le DLR est reçu ultérieurement, généralement via deliver_sm ou data_sm. De plus, la demande de DLR dépend de la configuration de registered_delivery et n’implique pas qu’un accusé soit disponible pour chaque message.
De manière équivalente, un statut d’envoi peut refléter une acceptation par un carrier en amont, tandis qu’un statut de livraison nécessite une confirmation ultérieure. Même lorsqu’un statut delivered est enregistré, son interprétation doit respecter la sémantique documentée par le fournisseur ou l’interconnexion concernée. Il ne doit pas être confondu avec une garantie absolue et indépendante de réception par une personne destinataire.
La redondance technique réduit certains risques de disponibilité. Elle ne supprime pas les restrictions de destination, le comportement de l’expéditeur, la perte de callbacks, l’incertitude antérieure au basculement ni le risque de duplication du trafic.
- Une capacité d’envoi alternative n’équivaut pas à une livraison confirmée.
- Un accusé d’acceptation ne remplace pas un DLR ultérieur.
- Un DLR demandé ne garantit pas sa réception pour tous les messages.
- La décision de réessayer doit prendre en compte l’incertitude, la validité et le coût du doublon.
Critères d’activation : signaux, seuils et validation humaine
Une continuité ne doit pas être activée sur la seule base d’une impression isolée ni dépendre d’une alarme dépourvue de contexte. Définissez des signaux observables pour chaque dépendance : erreurs de connexion, échecs d’authentification, indisponibilité des callbacks, accumulation dans la file d’attente, absence anormale d’états ultérieurs ou rejet des demandes. Les seuils doivent être cohérents avec la classe de trafic et l’impact tolérable pour le processus.
Afin d’éviter des changements excessifs, prévoyez une validation humaine avant d’appliquer des mesures qui modifient massivement le traitement du trafic. L’automatisation peut limiter ou protéger une file d’attente selon des règles préapprouvées, mais la redirection générale, le changement d’expéditeur ou le renvoi de messages incertains nécessitent une décision explicite et enregistrée.
Le critère d’activation doit inclure le périmètre : destinations, expéditeurs, classes de trafic, connexions ou composants concernés. Un incident localisé ne doit pas entraîner une modification inutile de l’ensemble du service.
- Signal technique observé et source de la preuve.
- Fenêtre temporelle d’évaluation et périmètre affecté.
- Classe de trafic autorisée pour chaque action.
- Responsable qui active, valide et communique la continuité.
- Enregistrement de la décision, de l’heure et des variables modifiées.
- Critère permettant de revoir, maintenir ou retirer la mesure.
Préserver la traçabilité pendant une continuité
La continuité dépend de la capacité à expliquer ce qui est arrivé à chaque message. Conservez un identifiant interne persistant dès la création de la demande et associez-y, lorsqu’ils sont disponibles, les identifiants renvoyés par la connectivité, le fournisseur ou le SMSC. Ne vous appuyez pas uniquement sur le callback pour enregistrer la création : l’état initial peut provenir de la réponse synchrone d’acceptation.
Traitez les callbacks et les DLR comme des événements asynchrones. Ils peuvent arriver après un changement de route, une suspension ou une nouvelle tentative. L’enregistrement doit conserver l’état initial, les changements d’état, les horodatages, l’origine de l’événement, la décision appliquée et le lien avec toute tentative ultérieure.
Conservez les preuves pendant la période définie par vos obligations et politiques internes, en appliquant une minimisation des données et des contrôles d’accès appropriés. L’objectif est de pouvoir réconcilier et auditer la continuité, et non de stocker des informations sans limite ni d’étendre l’utilisation des données au-delà de leur finalité.
- ID interne de demande ou clé d’idempotence.
- ID d’acceptation ou ID de message externe lorsqu’il existe.
- Classe de trafic, expéditeur, destination et horodatage de la tentative.
- État initial capturé dans la réponse de création ou d’envoi.
- Événements ultérieurs : callback, DLR, requête d’état et erreurs.
- Décision de continuité, responsable et motif.
- Relation entre la tentative d’origine, la nouvelle tentative et le message de remplacement.
Questions fréquentes
Qu’est-ce qu’un plan de continuité opérationnelle SMS A2P ?
Il s’agit d’un ensemble coordonné de procédures, de responsables et de mesures techniques visant à rétablir ou maintenir les processus de messagerie A2P après une interruption. Il doit couvrir le processus métier, les dépendances techniques, les données d’état, les décisions de mode dégradé et la réconciliation ultérieure.
Quelle est la différence entre RTO et RPO dans les SMS A2P ?
Le RTO définit combien de temps une capacité peut rester indisponible avant que l’impact ne devienne inacceptable. Le RPO définit jusqu’à quel point antérieur à l’interruption les données et les états doivent pouvoir être récupérés. Aucun des deux ne garantit la livraison d’un SMS au destinataire.
Une route alternative garantit-elle la reprise du service ?
Non. Elle peut rétablir la capacité à soumettre des messages via une autre connexion ou un autre fournisseur, mais elle ne garantit pas la livraison finale, n’élimine pas l’incertitude sur les tentatives précédentes et ne prévient pas à elle seule les doublons, les DLR tardifs ou les restrictions associées à l’expéditeur et à la destination.
Faut-il renvoyer automatiquement un SMS lorsqu’aucun DLR n’est reçu ?
Pas comme règle générale. L’absence de DLR ne démontre pas à elle seule que le message n’a pas été livré. Avant tout renvoi, il faut évaluer la validité du message, le risque de doublon, la corrélation disponible, la politique du processus et la possibilité de consulter ou de réconcilier les états.
Que faut-il enregistrer pendant une continuité de messagerie ?
Au minimum, un ID interne persistant, l’état initial, les ID externes disponibles, les horodatages, les callbacks ou DLR reçus, la source de chaque événement, les nouvelles tentatives et la décision opérationnelle appliquée. Cela permet de réconcilier les messages en attente, les événements tardifs et les doublons potentiels.
À quelle fréquence le plan doit-il être testé ?
Périodiquement, au moyen de tests, de formations et d’exercices contrôlés. Chaque test doit comporter des responsables, un périmètre, des critères de réussite, des critères de sortie et une revue ultérieure des changements nécessaires.
Sources consultées
- NIST SP 800-34 Rev. 1 — Contingency Planning Guide for Federal Information SystemsNational Institute of Standards and Technology (NIST)
- NIST CSRC — Contingency PlanningNational Institute of Standards and Technology (NIST)
- SMPP Protocol Specification v3.4, Issue 1.2SMS Forum / SMPP Developers Forum
- SMPP Delivery ReceiptsSMPP Developers Forum
- 3GPP TS 23.040 change-request portal3rd Generation Partnership Project (3GPP)
- Best Practices for Messaging Delivery Status LoggingTwilio
- Outbound Message Status in Status CallbacksTwilio
- Messages resourceTwilio
- Messaging ServicesTwilio
- Message Status StreamTwilio