HTTP- und SMPP-Verfügbarkeit bei A2P-SMS: Was messen und wie Fehler interpretieren?
Allgemeiner Leitfaden zur operativen Trennung von Konnektivität, Schnittstellenantworten und nachgelagerten Statusmeldungen bei A2P-SMS. Prüfen Sie die Kontrollen und ihre Interpretation anhand des Vertrags und der jeweiligen Schnittstellenimplementierung.
Verfügbarkeit ist nicht gleich Zustellung
Dies ist ein allgemeiner Leitfaden für den Betrieb und keine normative Spezifikation. Die beschriebenen Kontrollen und Interpretationen sollten mit dem Vertrag, der Dokumentation und der Implementierung der jeweiligen Schnittstelle abgeglichen werden.
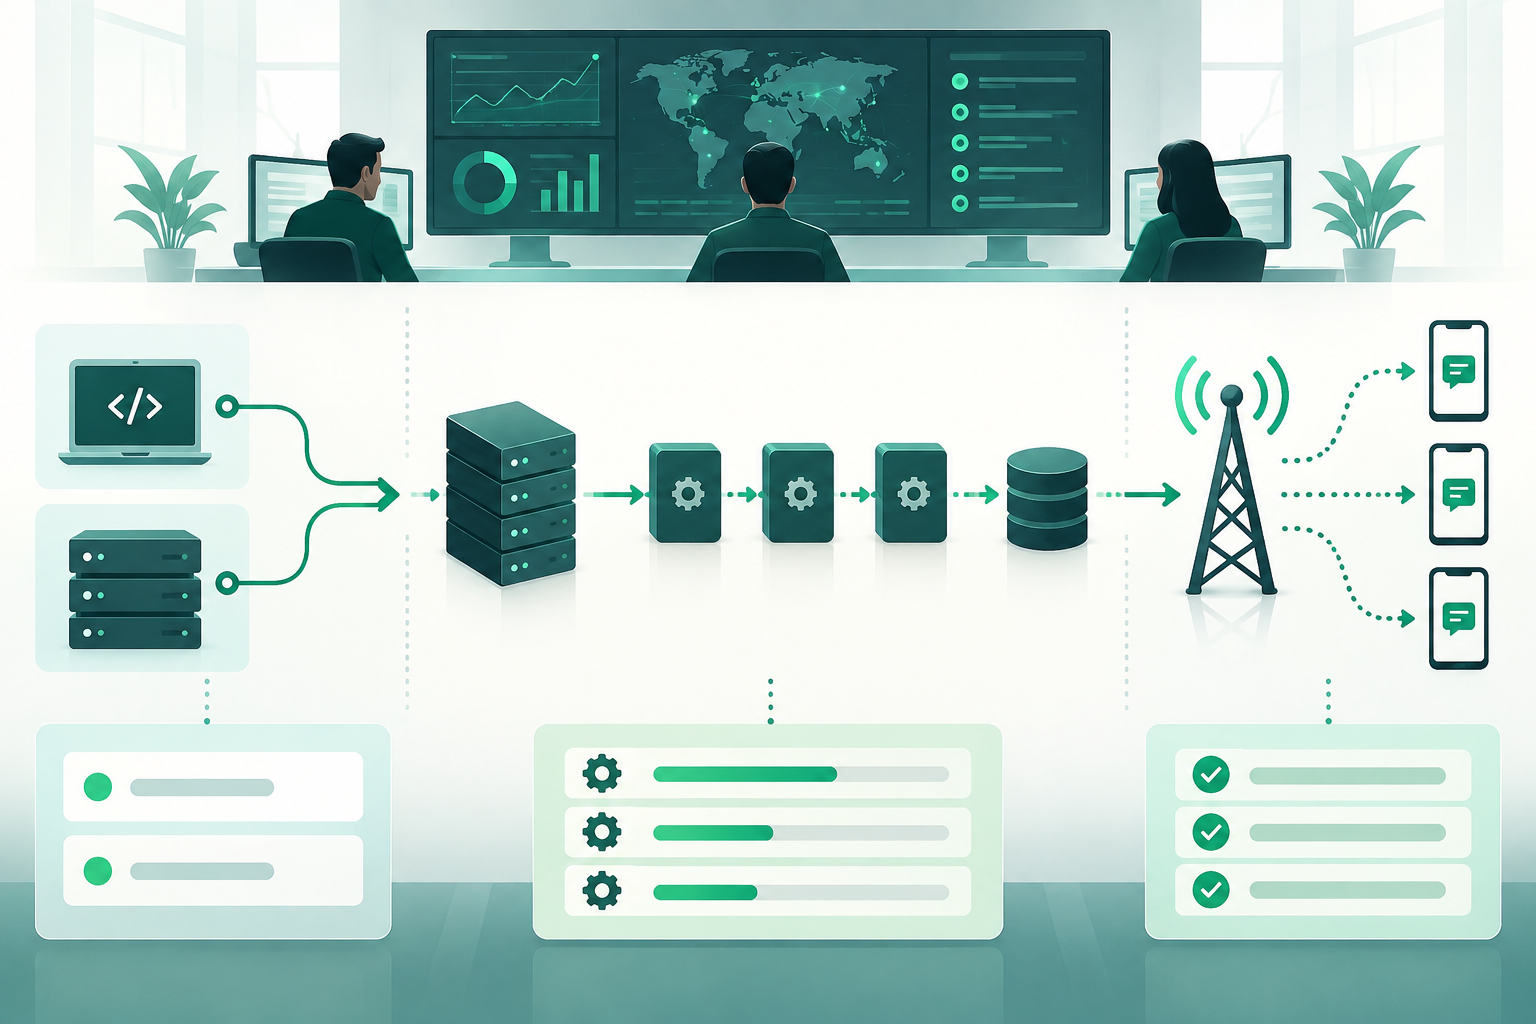
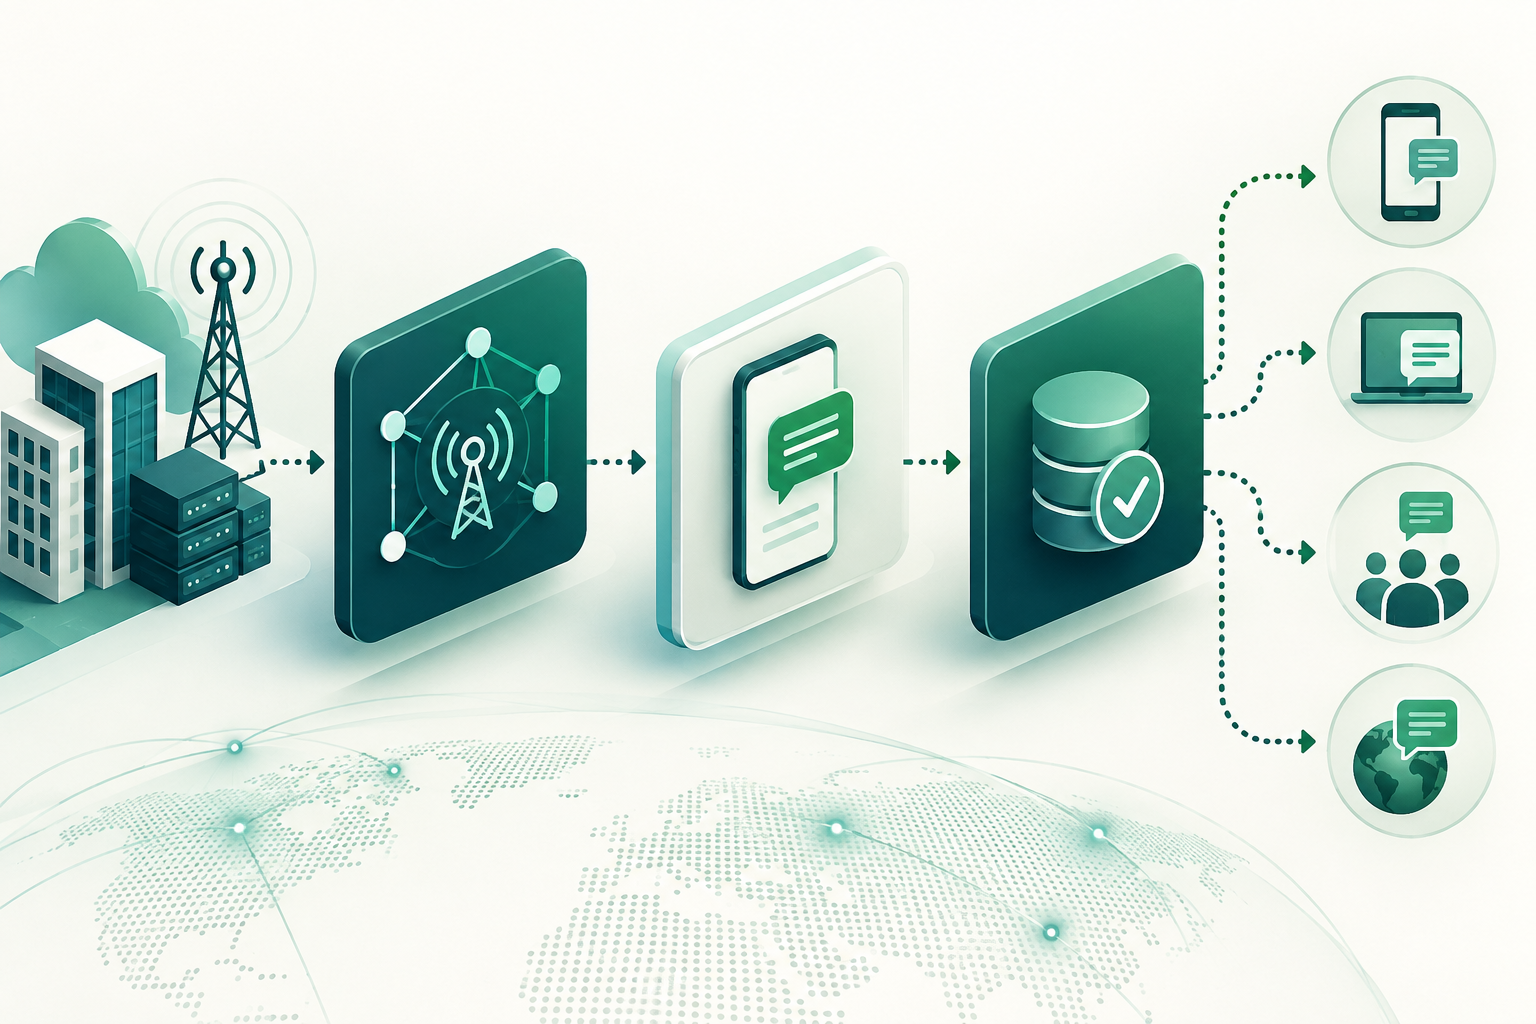
Als Arbeitsmodell empfiehlt es sich, drei Ergebnisse getrennt zu betrachten: Konnektivität, Schnittstellenantwort und nachgelagerter Nachrichtenstatus. Eine technische Antwort allein lässt nicht darauf schließen, dass die SMS verarbeitet, weitergeleitet oder auf dem Telefon empfangen wurde.
Erfassen Sie jede Phase getrennt. Werden sie zu einer einzigen Kennzahl für die „Verfügbarkeit“ zusammengefasst, lässt sich ein Verbindungsproblem möglicherweise nur schwer von einer funktionalen Antwort oder einem nachgelagerten Ergebnis unterscheiden.
- Konnektivität: Wurde die definierte Prüfung zum Erreichen des Dienstes abgeschlossen?
- Schnittstelle: Wurde eine Antwort auf die geprüfte Operation empfangen?
- Nachgelagerter Status: Welche Informationen zur Nachricht liegen vor, und woher stammen sie?
- Stellen Sie eine HTTP-Antwort, eine Antwort auf eine SMPP-Anfrage oder eine etablierte Sitzung nicht als ausreichenden Zustellnachweis dar.
Prüfung in Phasen aufteilen
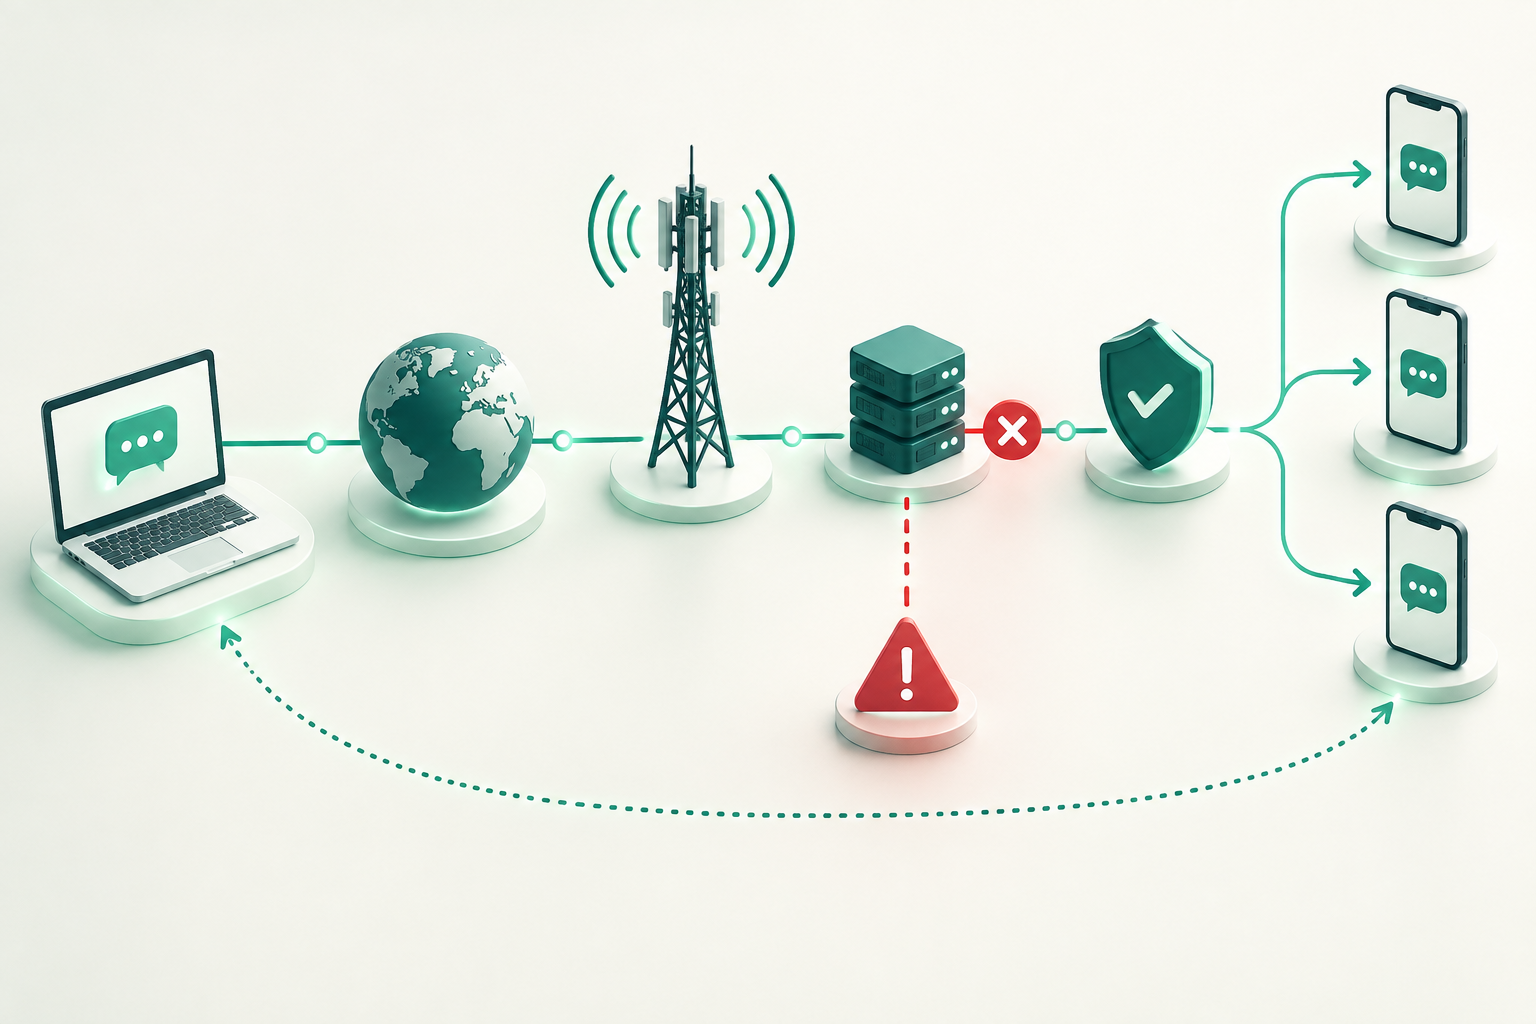
Als empfohlene Vorgehensweise sollten Sie zunächst die letzte abgeschlossene Phase ermitteln, bevor Sie einen Fehler dem Anbieter oder der Anwendung zuordnen. Je nach Implementierung kann eine Prüfung Namensauflösung, Netzwerkkonnektivität, Kommunikationsaufbau, Authentifizierung, Übermittlung einer Operation und Schnittstellenantwort voneinander unterscheiden.
Legen Sie im Voraus fest, welcher Endpunkt, welche Testdaten für die Authentifizierung, welche Operation und welches Ergebnis als gültig gelten. Vergleichen Sie die Prüfung mit einer bekannten Referenz und bewahren Sie Zeitstempel und Protokolle beider Seiten auf, sofern verfügbar. Ein Timeout bedeutet, dass die Prüfung nicht innerhalb des konfigurierten Limits abgeschlossen wurde; für sich allein identifiziert es nicht die Ursache.
Prüfen Sie bei einem Vorfall, ob das Muster alle Verbindungen betrifft oder nur einen Client, Endpunkt, eine Operation oder ein Testziel. Dieser Vergleich kann die Untersuchung lenken, bestätigt aber nicht von sich aus, wo das Problem entstanden ist.
- Halten Sie die genaue Fehlerphase entsprechend den für die Schnittstelle geltenden Schritten fest.
- Verwenden Sie festgelegte Zeitlimits und erfassen Sie die verstrichene Zeit; stellen Sie eine Zeitüberschreitung nicht als Ursachendiagnose dar.
- Bewahren Sie Uhrzeit, verfügbare Korrelationskennungen und das beobachtete Ergebnis auf; vermeiden Sie die unnötige Speicherung von Zugangsdaten oder personenbezogenen Daten.
Was bei HTTP zu beobachten ist
Als allgemeine betriebliche Vorgehensweise kann es hilfreich sein, die Verbindungszeit von der Gesamtzeit bis zum Eingang einer Antwort zu trennen. Erfassen Sie den HTTP-Status, die beobachteten Zeiten, Timeouts und von der Schnittstelle offengelegte Anwendungsfehler. Interpretieren Sie das Ergebnis anhand der Dokumentation und des API-Vertrags; dieser Leitfaden legt keine konkrete Bedeutung für HTTP-Codes fest.
Unterscheiden Sie zwischen einer empfangenen Antwort und einem funktionalen Ergebnis. Eine HTTP-Antwort zeigt allein nicht, ob die Operation angenommen, abgelehnt oder offengelassen wurde: Maßgeblich ist die für diese Schnittstelle dokumentierte Semantik.
Vermeiden Sie blindes erneutes Senden, wenn nach dem Absenden einer Anfrage das Zeitlimit überschritten wird. Lässt sich über die Schnittstelle nicht feststellen, ob die Operation verarbeitet wurde, könnte eine Wiederholung sie duplizieren. Klären Sie mit dem Anbieter, wie sich das Ergebnis abfragen oder ein sicherer Wiederholungsversuch durchführen lässt.
- Erfassen Sie als vorgeschlagene Kennzahlen Verbindung, Antwortzeit, HTTP-Status und das von der API gemeldete funktionale Ergebnis getrennt.
- Ordnen Sie Ergebnisse anhand des Schnittstellenvertrags ein, ohne anzunehmen, dass ein Status in allen Systemen dieselbe Bedeutung hat.
- Prüfen Sie die API-Dokumentation, um Antworten zu interpretieren und unklare Zustände zu klären, bevor Sie Wiederholungen automatisieren.
Was bei SMPP zu beobachten ist
Als allgemeine betriebliche Aufzeichnung kann es hilfreich sein, das Ergebnis des Bind-Vorgangs, den beobachteten Sitzungsstatus, konfigurierte Aktivitätsprüfungen, submit_sm-Anfragen und deren Antworten sowie Verbindungsabbrüche und erneute Verbindungen festzuhalten. Die Interpretation dieser Ereignisse hängt von der Version, der Konfiguration und der mit der Gegenstelle vereinbarten Dokumentation ab.
Leiten Sie aus einer Antwort auf eine Sendeanfrage nicht ab, dass die Nachricht beim Empfänger zugestellt wurde. Ebenso beweist eine etablierte Sitzung für sich allein weder, dass alle künftigen Anfragen angenommen werden, noch dass die Nachrichten ein bestimmtes nachgelagertes Ergebnis haben.
Ordnen Sie Sendeantworten, sofern verfügbar, den von der Schnittstelle zurückgegebenen Kennungen und den nachgelagerten Statusmeldungen zu. Behandeln Sie einen DLR als Statusmeldung des jeweiligen Systems, nicht als unabhängigen Nachweis dafür, dass das Telefon die Nachricht angezeigt oder eine Person sie gelesen hat.
- Erfassen Sie als vorgeschlagene betriebliche Beobachtungen etablierte oder verlorene Sitzungen, deren Dauer, konfigurierte Aktivitätsprüfungen und erneute Verbindungen.
- Halten Sie das Ergebnis jeder Sendeanfrage und die zugehörigen Kennungen fest; unterscheiden Sie die Sendeantwort vom nachgelagerten Status.
- Beachten Sie bei der Interpretation von Ereignissen, Grenzwerten und Statusmeldungen die vereinbarte Konfiguration und Dokumentation; nehmen Sie keine allgemeingültigen Werte an.
Sichere und aussagekräftige synthetische Tests entwerfen
Als empfohlene Vorgehensweise prüft ein synthetischer Test einen begrenzten Ablauf unter kontrollierten Bedingungen. Er steht nicht automatisch für den gesamten Verkehr, alle Ziele oder alle Betreiber. Legen Sie fest, welche Komponente geprüft wird und welche Schlussfolgerungen außerhalb des Geltungsbereichs liegen.
Verwenden Sie kontrollierte und autorisierte Testkonten, Rufnummern und Ziele sowie zulässige und vereinbarte Inhalte. Stimmen Sie Methode, Häufigkeit und Grenzwerte mit dem Anbieter und den geltenden Richtlinien ab. Gibt es kein kontrolliertes Ziel oder keine eindeutige Genehmigung, beschränken Sie den Test auf die autorisierten Prüfungen.
Halten Sie sich an eine vereinbarte Häufigkeit, um unnötigen Verkehr oder Störungen zu vermeiden. Kennzeichnen Sie die Prüfungen, damit sich ihre Ergebnisse vom realen Verkehr unterscheiden lassen. Senden Sie keine Nachrichten an Personen, die dem Test nicht zugestimmt haben.
- Legen Sie fest, was geprüft werden soll: Konnektivität, Authentifizierung, Schnittstellenantwort oder ein autorisierter Testablauf.
- Vereinbaren Sie Ziele, Inhalte, Häufigkeit, Volumen und die Kennzeichnung der Tests im Voraus.
- Dokumentieren Sie die Grenzen: Ein erfolgreiches Ergebnis für ein Ziel zu einem bestimmten Zeitpunkt garantiert weder eine allgemeine Verfügbarkeit noch künftige Ergebnisse.
Konnektivität, Antworten und nachgelagerte Statusmeldungen in Beziehung setzen
Als vorgeschlagene Untersuchungsmethode sollten Sie einer Abfolge von Belegen folgen: Prüfen Sie, ob Konnektivität bestand, ob Authentifizierung und Anfrage abgeschlossen wurden und schließlich, welche nachgelagerten Statusmeldungen verfügbar sind. Diese Reihenfolge hilft, die Untersuchung zu strukturieren, beweist aber nicht von sich aus die Ursache.
Ordnen Sie Zeitstempel, Anfrage- oder Nachrichtenkennungen, Endpunkt oder Sitzung, empfangene Antwort und Verbindungsabbruch-Ereignisse einander zu. Vergleichen Sie die Daten von Sender und Empfänger, sofern beide Seiten sie bereitstellen können. Fehlen gemeinsame Kennungen oder sind die Uhren nicht vergleichbar, halten Sie dies als Einschränkung fest.
Führen Sie eine Änderung bei den nachgelagerten Statusmeldungen nicht allein deshalb auf die Konnektivität zurück, weil sie zeitgleich mit mehr Fehlern auftritt. Eine Korrelation kann die Diagnose unterstützen, doch für die Feststellung einer Ursache sind Belege aus der betreffenden Phase erforderlich.
- Konnektivität: Erfassen Sie die bei den definierten Prüfungen beobachteten Fehler.
- Schnittstellenantwort: Erfassen Sie, was die Antwort gemäß dem vereinbarten Vertrag aussagt.
- Nachgelagerter Status: Notieren Sie verfügbare Statusmeldungen oder Berichte samt Herkunft und Grenzen.
- Führen Sie Protokolle jeder Kategorie getrennt, statt sie zu einer einzigen Fehlerrate zusammenzufassen.
Kennzahlen und Beobachtungszeiträume
Als empfohlene Vorgehensweise sollten Sie Kennzahlen wählen, die an betriebliche Entscheidungen geknüpft sind: den Anteil abgeschlossener Prüfungen, Antworten innerhalb des konfigurierten Zeitlimits, beobachtete Sitzungen, Sendeantworten und verfügbare nachgelagerte Statusmeldungen. Geben Sie Nenner, Grundgesamtheit, Prüfmethode und Datenquelle an.
Verlassen Sie sich nicht allein auf Durchschnittswerte. Ein Durchschnitt kann kurze Unterbrechungen oder Unterschiede zwischen Endpunkten und Zielen verschleiern. Bewahren Sie die Zeitreihe auf und prüfen Sie relevante Einzelereignisse, ohne allgemeingültige Grenzwerte anzunehmen.
Legen Sie Beobachtungszeiträume und Alarmgrenzen passend zum Dienst und zu den betrieblichen Vereinbarungen fest. Dokumentieren Sie Konfigurationsänderungen und Wartungsarbeiten, damit sich Abweichungen einordnen lassen. Ist ein synthetischer Test selten, beachten Sie, dass er Fehler zwischen den Prüfungen möglicherweise nicht erkennt.
- Weisen Sie Konnektivität, Schnittstellenantwort und nachgelagerte Statusmeldungen getrennt aus.
- Nennen Sie für jede Kennzahl den Zeitraum, die gemessene Grundgesamtheit und die Zahl der Beobachtungen.
- Prüfen Sie neben dem Gesamtwert auch kurze Ereignisse und Ergebnisse nach Endpunkt oder Sitzung.
Alarmierung und Eskalation mit Belegen
Als empfohlene Vorgehensweise kann ein Alarm angeben, welche Prüfung wo, wann und wie lange fehlgeschlagen ist und welche vorherigen Phasen abgeschlossen wurden. Legen Sie Eskalationsregeln anhand der beobachteten Auswirkungen und der vereinbarten Verfahren fest; dieser Leitfaden schlägt keine allgemeingültigen Grenzwerte vor.
Sammeln Sie vor einer Eskalation relevante Protokolle: Zeitstempel, Endpunkt oder Sitzung, Operation, beobachtetes Ergebnis, verfügbare Korrelationskennungen und Ausmaß der Auswirkungen. Ergänzen Sie Prüfmethode und abgeschlossene Schritte. Fügen Sie keine Passwörter, Token oder unnötigen personenbezogenen Daten hinzu.
Trennen Sie bei der Meldung an den Anbieter oder das interne Team Fakten von Hypothesen. Geben Sie zum Beispiel an, dass innerhalb des konfigurierten Zeitlimits keine Antwort eingegangen ist und in welcher Phase dies geschah. Behaupten Sie nicht, der Anbieter sei ausgefallen, wenn die Ursache nicht eingegrenzt wurde.
- Eskalieren Sie nach den vereinbarten betrieblichen Kriterien und den beobachteten Auswirkungen.
- Fügen Sie Belege zu betroffenen und nicht betroffenen Verbindungen bei, um den Umfang einzugrenzen.
- Wenn Konnektivität und Schnittstelle antworten, der Nachrichtenstatus aber unklar bleibt, fragen Sie nach der Interpretation des Status und den verfügbaren Protokollen der nachgelagerten Phase.
Häufige Fragen
Bestätigt eine HTTP-Antwort, dass die SMS zugestellt wurde?
Nicht für sich allein. Sie bestätigt, dass eine Antwort vom Endpunkt eingegangen ist. Die Bedeutung der Operation und die nachgelagerten Statusmeldungen sind der Dokumentation und dem Vertrag der jeweiligen API zu entnehmen.
Bedeutet eine erfolgreiche Antwort auf submit_sm, dass der Empfänger die Nachricht erhalten hat?
Das lässt sich daraus allein nicht schließen. Beachten Sie die Dokumentation der Schnittstelle und die verfügbaren nachgelagerten Statusmeldungen sowie deren Herkunft und Geltungsbereich.
Beweist eine etablierte SMPP-Sitzung die durchgängige Verfügbarkeit?
Nein. Sie gibt lediglich Auskunft über die beobachtete Sitzung. Für sich allein beweist sie weder, dass jede Anfrage verarbeitet wird, noch dass Nachrichten ein bestimmtes nachgelagertes Ergebnis haben.
Was sollte ein synthetischer Test tun, wenn kein kontrolliertes Ziel verfügbar ist?
Beschränken Sie sich auf autorisierte Prüfungen der Konnektivität und der Schnittstellenantwort. Senden Sie keine Nachrichten an nicht autorisierte Empfänger und leiten Sie aus einer Teilprüfung kein nachgelagertes Ergebnis ab.
Welche Informationen sollten bei der Eskalation eines Vorfalls geteilt werden?
Geben Sie Uhrzeit, Endpunkt oder Sitzung, Operation, Fehlerphase, beobachtetes Ergebnis, verfügbare Kennungen und Ausmaß an. Trennen Sie Fakten von Hypothesen und lassen Sie unnötige Zugangsdaten sowie personenbezogene Daten weg.
Verwendete Quellen
- HTTP Semantics (RFC 9110)IETF
- SMPP Protocol Specification v3.4SMPP Developers Forum
- SMPP specificationOVHcloud