Disponibilidade HTTP e SMPP em SMS A2P: o que medir e como interpretar falhas
Guia operacional geral para distinguir conectividade, respostas da interface e estados posteriores de SMS A2P. As verificações e interpretações devem ser conferidas com o contrato e a implementação de cada interface.
Disponibilidade não é o mesmo que entrega
Este é um guia operacional geral, não uma especificação normativa. As verificações e interpretações descritas devem ser conferidas com o contrato, a documentação e a implementação de cada interface.
Como estrutura de trabalho, convém distinguir três resultados: conectividade, resposta da interface e estado posterior da mensagem. Uma resposta técnica, por si só, não permite concluir que o SMS foi processado, encaminhado ou recebido no telefone.
Registre cada etapa separadamente. Se todas forem agrupadas em um único indicador de “disponibilidade”, pode ser difícil distinguir um problema de conexão de uma resposta funcional ou de um resultado posterior.
- Conectividade: a verificação definida para acessar o serviço foi concluída?
- Interface: foi recebida uma resposta à operação verificada?
- Estado posterior: que informações sobre a mensagem estão disponíveis e qual é sua origem?
- Não apresente uma resposta HTTP, uma resposta a uma solicitação SMPP ou uma sessão estabelecida como prova suficiente de entrega.
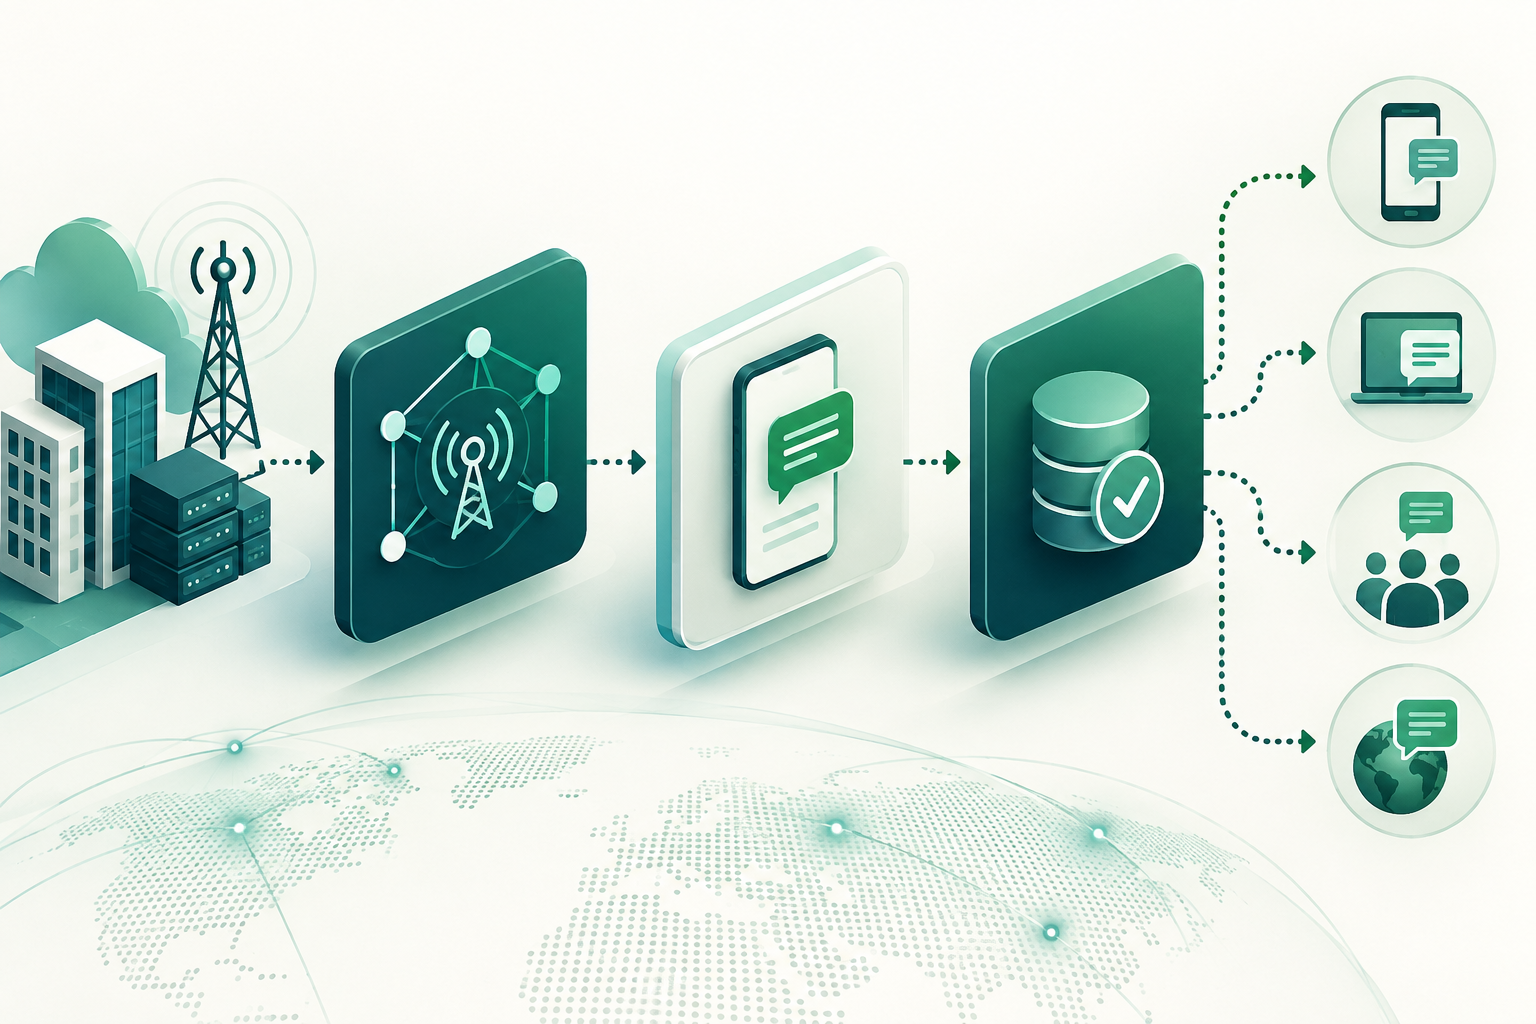
Divida a verificação em etapas
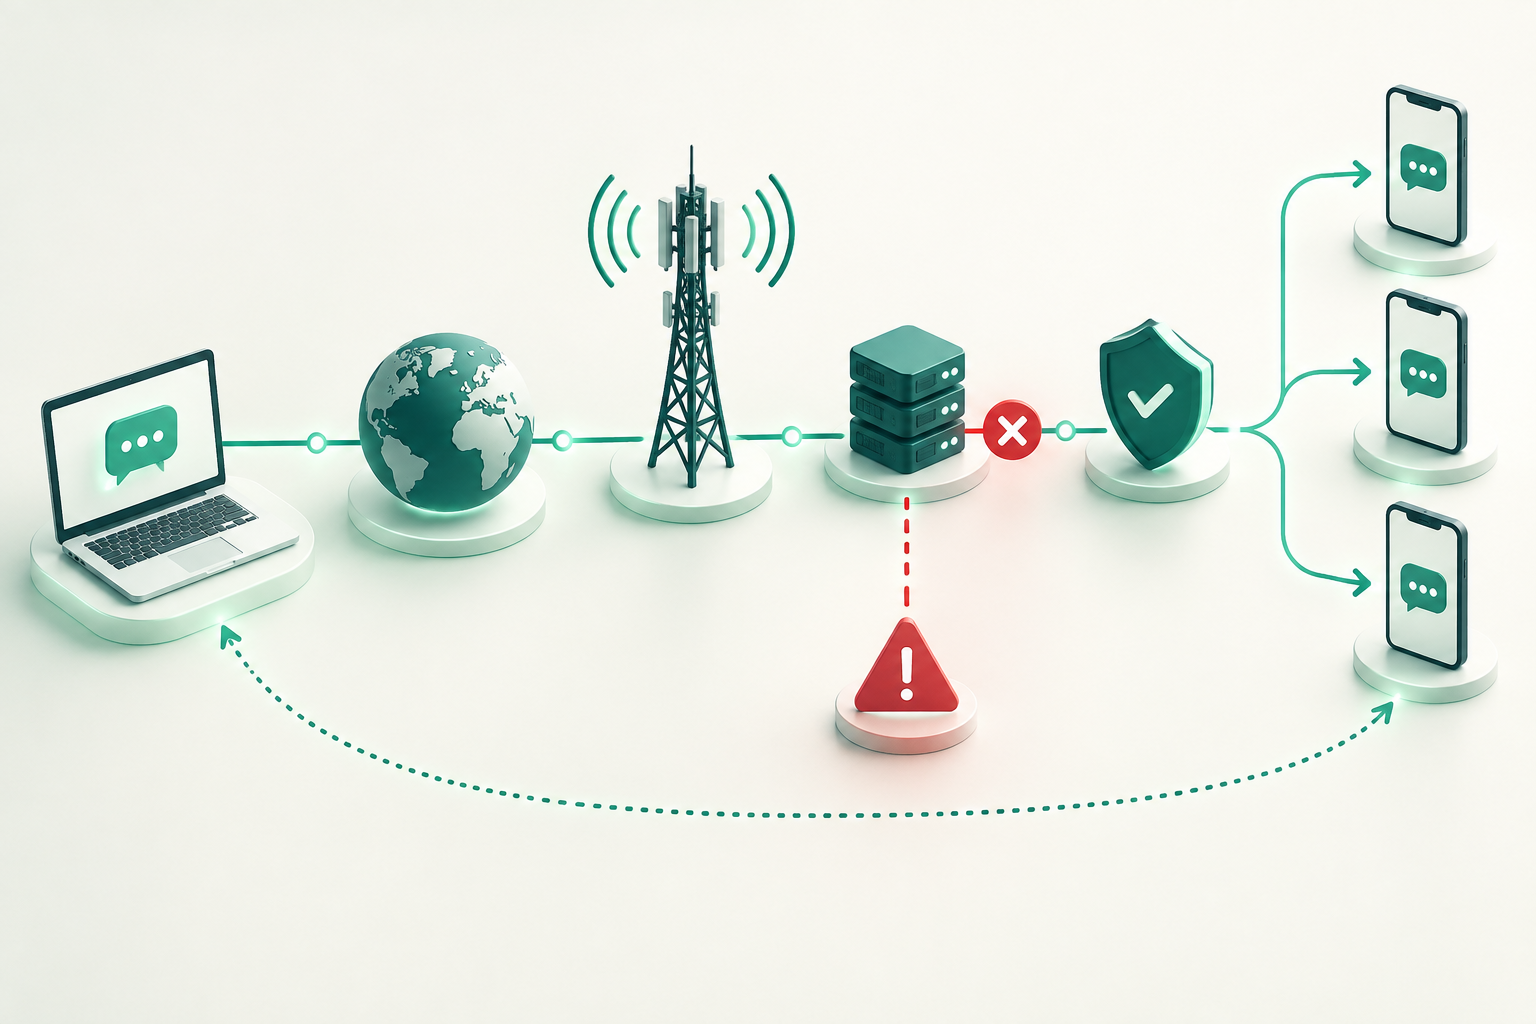
Como prática recomendada, identifique a última etapa concluída antes de atribuir uma falha ao provedor ou à aplicação. Conforme a implementação, uma verificação pode distinguir resolução de nome, conectividade de rede, estabelecimento da comunicação, autenticação, envio de uma operação e resposta da interface.
Defina previamente qual endpoint, credenciais de teste, operação e resultado são considerados válidos. Compare a verificação com uma referência conhecida e, quando disponíveis, mantenha registros e marcações de horário de ambas as extremidades. Um timeout significa que a verificação não terminou dentro do limite configurado; por si só, não identifica a causa.
Durante um incidente, verifique se o padrão afeta todas as conexões ou apenas um cliente, endpoint, operação ou destino de teste. Essa comparação pode orientar a investigação, mas não confirma, por si só, onde o problema teve origem.
- Registre a etapa exata da falha, de acordo com os passos aplicáveis à interface.
- Defina limites de espera e registre o tempo decorrido; não apresente o esgotamento do tempo de espera como diagnóstico da causa.
- Registre o horário, os identificadores de correlação disponíveis e o resultado observado; evite armazenar credenciais ou dados pessoais desnecessários.
O que observar em HTTP
Como prática operacional geral, pode ser útil separar o tempo de conexão do tempo total até o recebimento de uma resposta. Registre o status HTTP, os tempos observados, os timeouts e os erros da aplicação expostos pela interface. Interprete o resultado conforme a documentação e o contrato da API; este guia não define o significado de códigos HTTP específicos.
Diferencie o recebimento de uma resposta de um resultado funcional. Uma resposta HTTP não permite determinar, por si só, se a operação foi aceita, rejeitada ou ficou pendente: consulte a semântica documentada para essa interface.
Evite repetir a solicitação às cegas quando o tempo de espera se esgotar após o envio. Se a interface não permitir saber se a operação foi processada, uma nova tentativa poderá duplicá-la. Esclareça com o provedor como consultar o resultado ou fazer novas tentativas com segurança.
- Como indicadores recomendados, registre separadamente a conexão, o tempo de resposta, o status HTTP e o resultado funcional informado pela API.
- Classifique os resultados conforme o contrato da interface, sem presumir que um status tenha o mesmo significado em todos os sistemas.
- Consulte a documentação da API para interpretar respostas e resolver estados incertos antes de automatizar novas tentativas.
O que observar em SMPP
Como registro operacional geral, pode ser útil anotar o resultado do bind, o estado observado da sessão, as verificações de atividade configuradas, as solicitações submit_sm e suas respostas, além de desconexões e reconexões. A interpretação desses eventos depende da versão, da configuração e da documentação acordadas com a outra extremidade.
Não deduza a entrega ao destinatário a partir de uma resposta a uma solicitação de envio. Da mesma forma, uma sessão estabelecida não demonstra, por si só, que todas as solicitações futuras serão aceitas nem que suas mensagens terão determinado resultado posterior.
Quando disponíveis, correlacione as respostas de envio com os identificadores retornados pela interface e com os estados posteriores. Trate um DLR como um estado informado pelo sistema correspondente, não como verificação independente de que o telefone exibiu a mensagem ou de que a pessoa a leu.
- Como observações operacionais recomendadas, registre sessões estabelecidas ou perdidas, duração, atividade configurada e reconexões.
- Anote o resultado de cada solicitação de envio e os identificadores associados; mantenha separadas a resposta de envio e o estado posterior.
- Consulte a configuração e a documentação acordadas para interpretar eventos, limites e estados; não presuma valores universais.
Planeje testes sintéticos seguros e úteis
Como prática recomendada, um teste sintético verifica um percurso limitado em condições controladas; ele não representa automaticamente todo o tráfego, todos os destinos nem todas as operadoras. Especifique qual componente é avaliado e quais conclusões ficam fora do escopo.
Use contas, números e destinos de teste controlados e autorizados, com conteúdo permitido e acordado. Combine o método, a frequência e os limites com o provedor e as políticas aplicáveis. Se não houver um destino controlado ou uma autorização clara, limite o teste às verificações que estiverem autorizadas.
Mantenha uma frequência acordada para evitar tráfego desnecessário ou interferências. Identifique as verificações para separar seus resultados do tráfego real. Não envie mensagens a pessoas que não tenham autorizado o teste.
- Defina o que será verificado: conectividade, autenticação, resposta da interface ou um percurso de teste autorizado.
- Combine previamente destinos, conteúdo, frequência, volume e forma de identificar os testes.
- Documente os limites: um resultado satisfatório em um destino e em determinado momento não garante disponibilidade geral nem resultados futuros.
Relacione conectividade, respostas e estados posteriores
Como método de investigação recomendado, siga uma sequência de evidências: verifique se houve conectividade, se a autenticação e a solicitação foram concluídas e, por fim, quais estados posteriores estão disponíveis. Essa sequência ajuda a organizar a investigação, mas não demonstra, por si só, a causa.
Correlacione marcações de horário, identificadores de solicitação ou mensagem, endpoint ou sessão, resposta recebida e eventos de desconexão. Compare os dados do remetente e do destinatário quando ambas as partes puderem fornecê-los. Se não houver identificadores comuns ou se os relógios não forem comparáveis, registre essa limitação.
Não atribua uma alteração nos estados posteriores à conectividade apenas porque ela coincide com um aumento de erros. A correlação pode orientar o diagnóstico, mas são necessárias evidências da etapa correspondente para estabelecer uma causa.
- Conectividade: registre as falhas observadas durante as verificações definidas.
- Resposta da interface: registre o que a resposta indica segundo o contrato acordado.
- Estado posterior: anote os estados ou relatórios disponíveis, junto com sua origem e suas limitações.
- Mantenha os registros de cada categoria separados, em vez de somá-los em uma única taxa de falha.
Indicadores e janelas de observação
Como prática recomendada, escolha indicadores vinculados a decisões operacionais: proporção de verificações concluídas, respostas recebidas dentro do limite configurado, sessões observadas, respostas de envio e estados posteriores disponíveis. Especifique o denominador, a população, o método de verificação e a fonte dos dados.
Não dependa apenas de médias. Uma média pode ocultar interrupções breves ou diferenças entre endpoints e destinos. Mantenha a série temporal e examine os eventos individuais relevantes, sem presumir limites universais.
Defina janelas de observação e limites de alerta de acordo com o serviço e os acordos operacionais. Registre alterações de configuração e manutenções para interpretar variações. Se um teste sintético for pouco frequente, considere que ele poderá não detectar falhas entre as verificações.
- Apresente separadamente conectividade, resposta da interface e estados posteriores.
- Informe a janela de tempo, a população medida e o número de observações junto com cada indicador.
- Examine eventos breves e resultados por endpoint ou sessão, além do valor agregado.
Alertas e escalonamento com evidências
Como prática recomendada, um alerta pode indicar qual verificação falhou, de onde, quando e por quanto tempo, além de informar quais etapas anteriores foram concluídas. Defina regras de escalonamento conforme o impacto observado e os procedimentos acordados; este guia não propõe limites universais.
Antes de escalar, reúna registros pertinentes: marcações de horário, endpoint ou sessão, operação, resultado observado, identificadores de correlação disponíveis e alcance do impacto. Acrescente o método de verificação e as etapas concluídas. Não inclua senhas, tokens nem dados pessoais desnecessários.
Ao informar o provedor ou a equipe interna, separe fatos de hipóteses. Por exemplo, indique que não houve resposta dentro do limite configurado e em que etapa isso ocorreu; não afirme que o provedor está fora do ar se a causa não tiver sido isolada.
- Escale de acordo com os critérios operacionais acordados e o impacto observado.
- Inclua evidências das conexões afetadas e não afetadas para delimitar o alcance.
- Se a conectividade e a interface responderem, mas o estado da mensagem permanecer incerto, solicite uma interpretação do estado e os registros disponíveis da etapa posterior.
Perguntas frequentes
Uma resposta HTTP confirma que o SMS foi entregue?
Não, por si só. Ela confirma que uma resposta foi recebida do endpoint. O significado da operação e os estados posteriores devem ser consultados na documentação e no contrato dessa API.
Uma resposta satisfatória a submit_sm significa que o destinatário recebeu a mensagem?
Não é possível concluir isso apenas com essa resposta. Consulte a documentação da interface e os estados posteriores disponíveis, levando em conta sua origem e seu alcance.
Uma sessão SMPP estabelecida demonstra disponibilidade de ponta a ponta?
Não. Ela informa apenas sobre a sessão observada; por si só, não demonstra que cada solicitação será processada nem que as mensagens terão determinado resultado posterior.
O que um teste sintético deve fazer quando não há um destino controlado?
Limitar-se às verificações autorizadas de conectividade e resposta da interface. Não envie mensagens a destinatários sem autorização nem deduza um resultado posterior a partir de uma verificação parcial.
Que informações convém compartilhar ao escalar um incidente?
Inclua horário, endpoint ou sessão, operação, etapa da falha, resultado observado, identificadores disponíveis e alcance. Separe fatos de hipóteses e exclua credenciais e dados pessoais desnecessários.
Fontes consultadas
- HTTP Semantics (RFC 9110)IETF
- SMPP Protocol Specification v3.4SMPP Developers Forum
- SMPP specificationOVHcloud