Disponibilità HTTP e SMPP negli SMS A2P: cosa misurare e come interpretare gli errori
Guida operativa generale per distinguere connettività, risposte dell’interfaccia e stati successivi degli SMS A2P. Verifiche e interpretazioni vanno confrontate con il contratto e l’implementazione di ciascuna interfaccia.
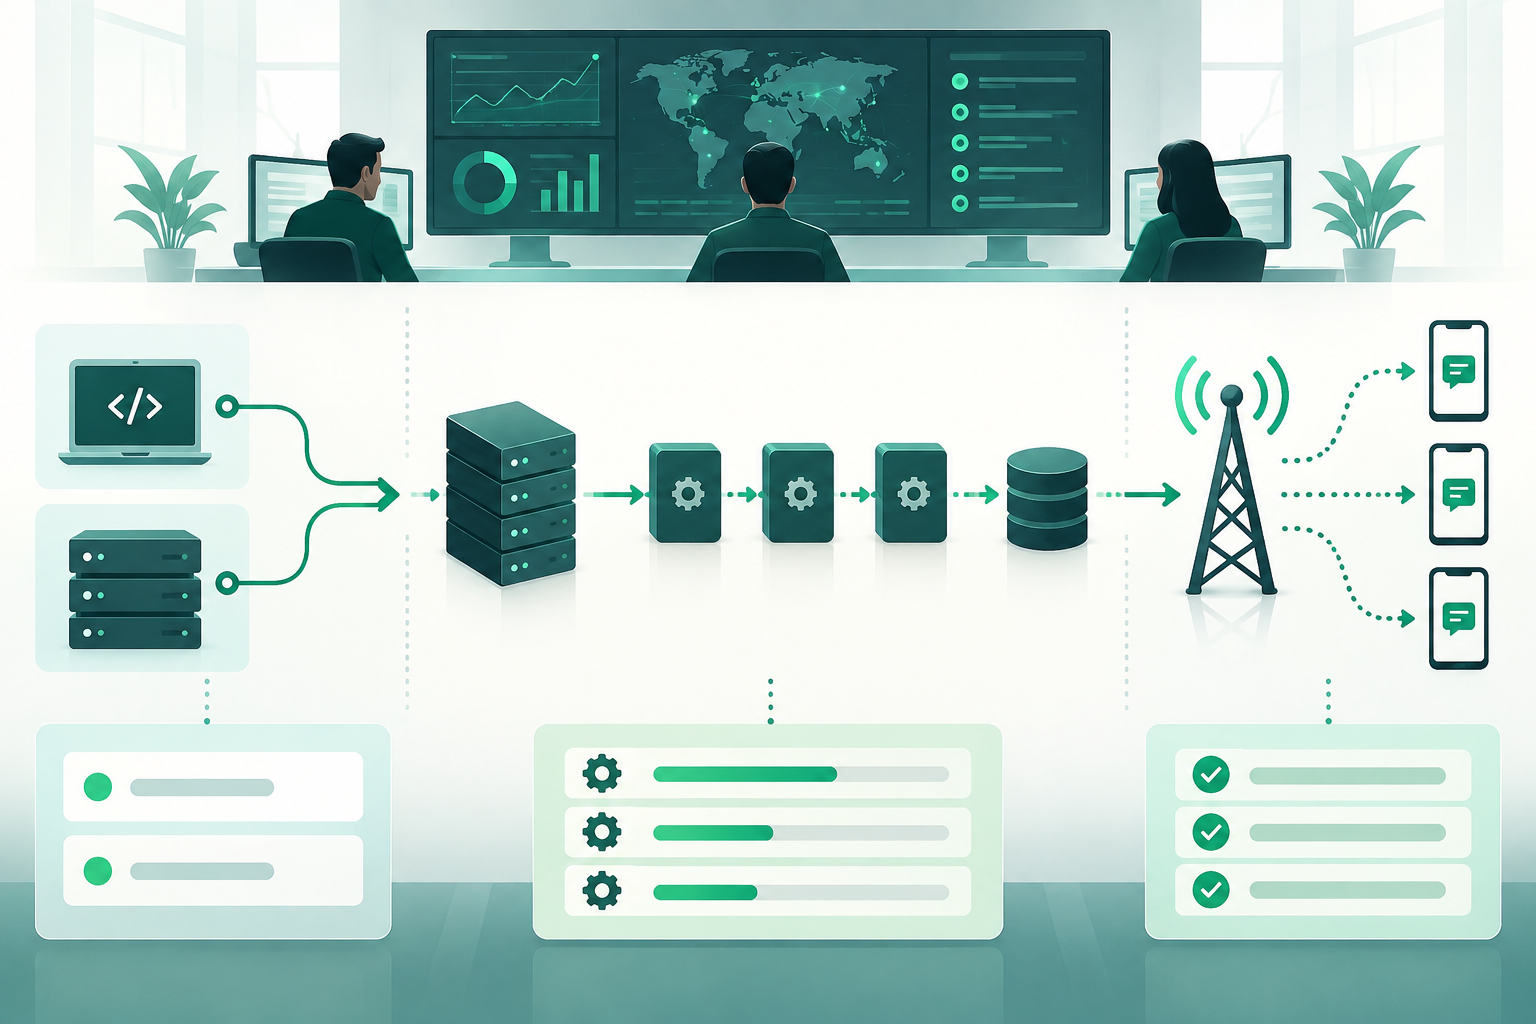
Disponibilità non significa consegna
Questa è una guida operativa generale, non una specifica normativa. Le verifiche e le interpretazioni descritte vanno confrontate con il contratto, la documentazione e l’implementazione di ciascuna interfaccia.
Come quadro di riferimento, è utile distinguere tre risultati: connettività, risposta dell’interfaccia e stato successivo del messaggio. Una risposta tecnica, da sola, non consente di concludere che l’SMS sia stato elaborato, instradato o ricevuto sul telefono.
Registra ogni fase separatamente. Se vengono raggruppate in un unico indicatore di «disponibilità», può essere difficile distinguere un problema di connessione da una risposta funzionale o da un risultato successivo.
- Connettività: la verifica definita per raggiungere il servizio è stata completata?
- Interfaccia: è stata ricevuta una risposta all’operazione verificata?
- Stato successivo: quali informazioni sul messaggio sono disponibili e qual è la loro provenienza?
- Non presentare una risposta HTTP, una risposta a una richiesta SMPP o una sessione stabilita come prova sufficiente dell’avvenuta consegna.
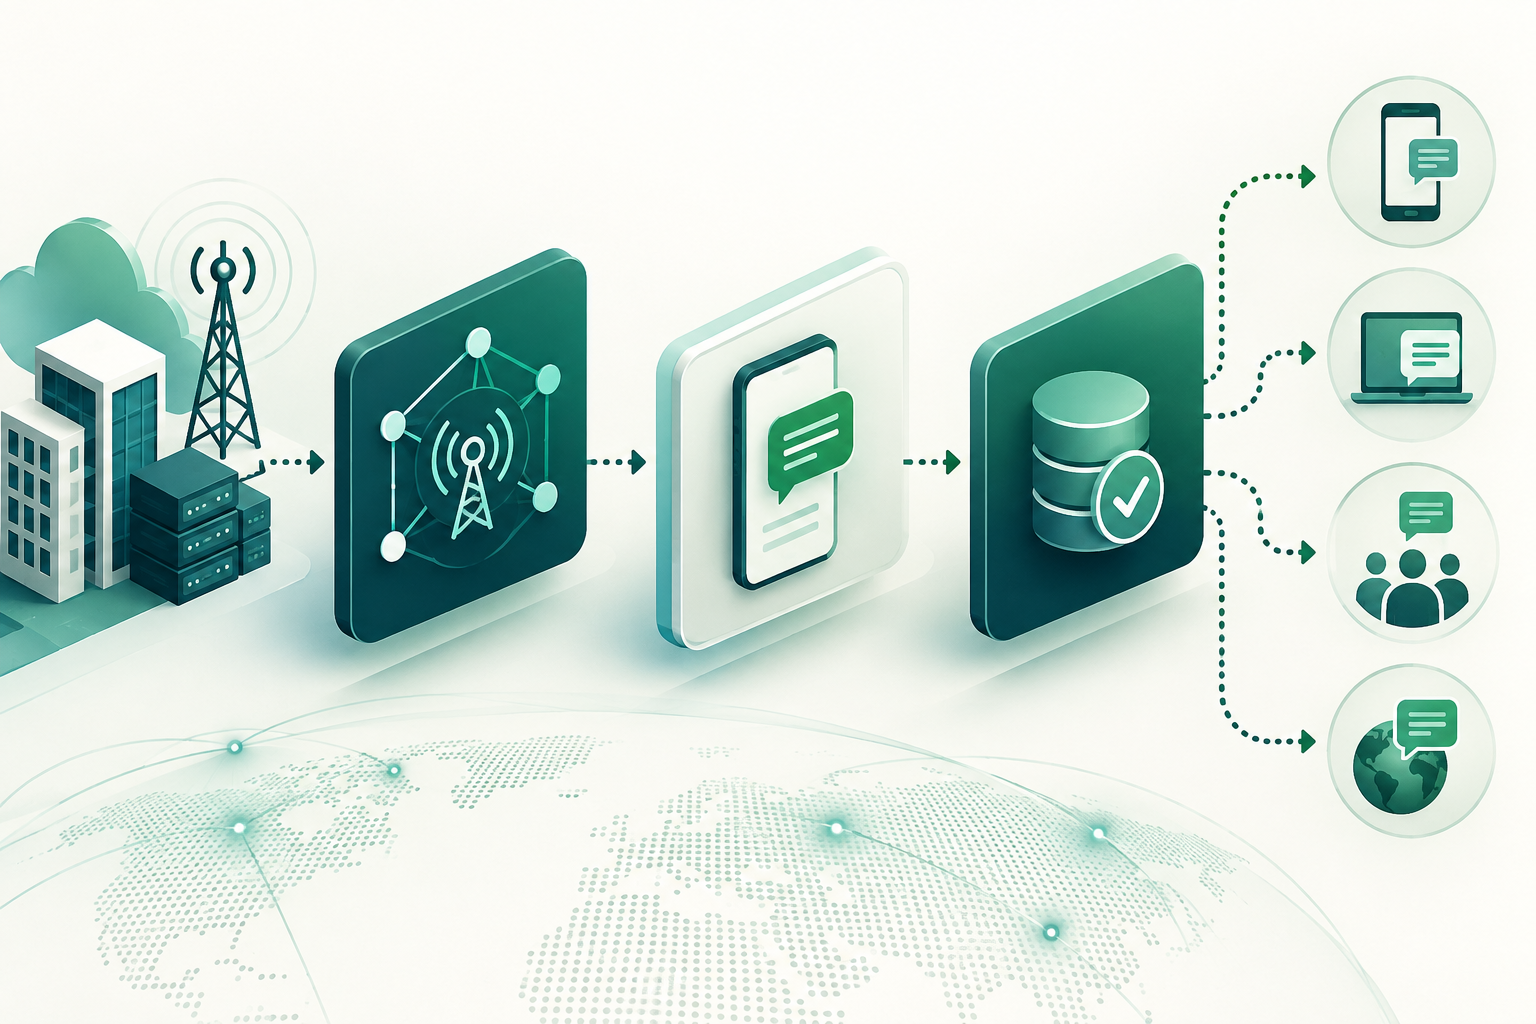
Suddividi la verifica in fasi
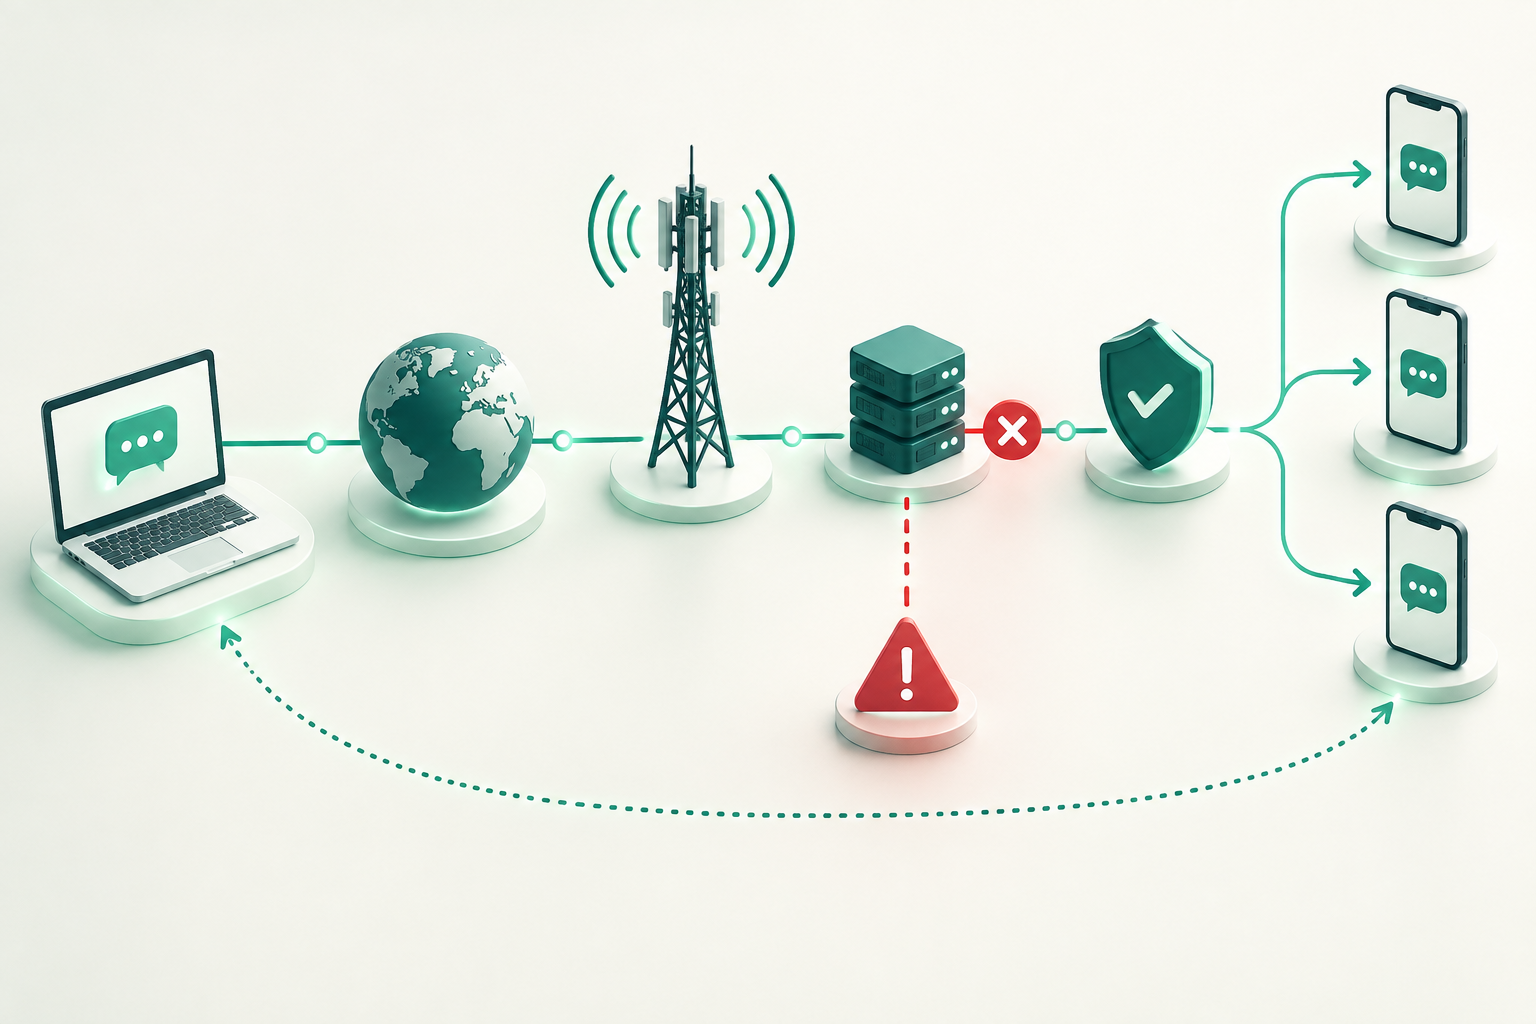
Come pratica consigliata, individua l’ultima fase completata prima di attribuire un errore al provider o all’applicazione. Una verifica può distinguere la risoluzione del nome, la connettività di rete, l’instaurazione della comunicazione, l’autenticazione, l’invio di un’operazione e la risposta dell’interfaccia, quando questi passaggi sono pertinenti all’implementazione.
Definisci in anticipo quale endpoint, credenziali di test, operazione e risultato siano considerati validi. Confronta la verifica con un riferimento noto e conserva, quando disponibili, timestamp e log di entrambi gli estremi. Un timeout significa che la verifica non è terminata entro il limite configurato; da solo non identifica la causa.
Durante un incidente, verifica se il problema interessa tutte le connessioni o solo un client, endpoint, operazione o destinatario di test. Questo confronto può orientare l’indagine, ma non conferma da solo l’origine del problema.
- Annota la fase esatta dell’errore, in base ai passaggi applicabili all’interfaccia.
- Imposta limiti di attesa definiti e registra il tempo trascorso; non presentare un timeout come diagnosi della causa.
- Conserva l’ora, gli identificativi di correlazione disponibili e il risultato osservato; evita di memorizzare credenziali o dati personali non necessari.
Cosa osservare con HTTP
Come pratica operativa generale, può essere utile distinguere il tempo di connessione dal tempo totale necessario per ricevere una risposta. Registra lo stato HTTP, i tempi osservati, i timeout e gli errori applicativi esposti dall’interfaccia. Interpreta il risultato in base alla documentazione e al contratto dell’API; questa guida non stabilisce il significato di specifici codici HTTP.
Distingui una risposta ricevuta da un risultato funzionale. Una risposta HTTP, da sola, non consente di determinare se l’operazione sia stata accettata, rifiutata o sia rimasta in sospeso: consulta la semantica documentata per quella specifica interfaccia.
Evita di riprovare alla cieca quando il timeout si verifica dopo l’invio di una richiesta. Se l’interfaccia non permette di sapere se l’operazione è stata elaborata, un nuovo tentativo potrebbe duplicarla. Chiarisci con il provider come verificare il risultato o come effettuare tentativi sicuri.
- Come indicatori consigliati, registra separatamente la connessione, il tempo di risposta, lo stato HTTP e il risultato funzionale riportato dall’API.
- Classifica i risultati in base al contratto dell’interfaccia, senza presumere che uno stato abbia lo stesso significato in tutti i sistemi.
- Consulta la documentazione dell’API per interpretare le risposte e risolvere gli stati incerti prima di automatizzare nuovi tentativi.
Cosa osservare con SMPP
Come registrazione operativa generale, può essere utile annotare l’esito del bind, lo stato osservato della sessione, i controlli di attività configurati, le richieste submit_sm e le relative risposte, oltre a disconnessioni e riconnessioni. L’interpretazione di questi eventi dipende dalla versione, dalla configurazione e dalla documentazione concordate con l’estremo remoto.
Non dedurre la consegna al destinatario dalla risposta a una richiesta di invio. Allo stesso modo, una sessione stabilita non dimostra da sola che tutte le richieste future saranno accettate né che i relativi messaggi avranno un determinato esito successivo.
Quando disponibili, correla le risposte di invio con gli identificativi restituiti dall’interfaccia e con gli stati successivi. Considera un DLR come uno stato riportato dal sistema corrispondente, non come verifica indipendente del fatto che il telefono abbia mostrato il messaggio o che la persona lo abbia letto.
- Come osservazioni operative consigliate, registra le sessioni avviate o perse, la loro durata, l’attività configurata e le riconnessioni.
- Annota l’esito di ogni richiesta di invio e gli identificativi associati; mantieni distinta la risposta all’invio dallo stato successivo.
- Consulta la configurazione e la documentazione concordate per interpretare eventi, limiti e stati; non presumere valori universali.
Progetta test sintetici sicuri e utili
Come pratica consigliata, un test sintetico verifica un percorso limitato in condizioni controllate; non rappresenta automaticamente tutto il traffico, tutti i destinatari o tutti gli operatori. Specifica quale componente valuta e quali conclusioni non rientrano nel suo ambito.
Utilizza account, numeri e destinatari di test controllati e autorizzati, insieme a contenuti consentiti e concordati. Coordina metodo, frequenza e limiti con il provider e con le policy applicabili. Se non sono disponibili un destinatario controllato o un’autorizzazione chiara, limita il test alle verifiche autorizzate.
Mantieni una frequenza concordata per evitare traffico non necessario o interferenze. Identifica i test per separarne i risultati dal traffico reale. Non inviare messaggi a persone che non hanno autorizzato il test.
- Definisci cosa verificare: connettività, autenticazione, risposta dell’interfaccia o un percorso di test autorizzato.
- Concorda in anticipo destinatari, contenuto, frequenza, volume e modalità di identificazione dei test.
- Documenta i limiti: un risultato positivo per un destinatario e in un determinato momento non garantisce la disponibilità generale né i risultati futuri.
Collega connettività, risposte e stati successivi
Come metodo d’indagine consigliato, segui una sequenza di evidenze: verifica se c’è stata connettività, se l’autenticazione e la richiesta sono state completate e, infine, quali stati successivi sono disponibili. Questa sequenza aiuta a organizzare l’indagine, ma non dimostra da sola la causa.
Correla timestamp, identificativi della richiesta o del messaggio, endpoint o sessione, risposta ricevuta ed eventi di disconnessione. Confronta i dati del mittente e del destinatario quando entrambe le parti possono fornirli. Se mancano identificativi comuni o gli orologi non sono confrontabili, segnalalo come limite.
Non attribuire un cambiamento negli stati successivi alla connettività solo perché coincide con un aumento degli errori. La correlazione può orientare la diagnosi, ma per stabilire una causa servono evidenze relative alla fase corrispondente.
- Connettività: registra gli errori osservati durante le verifiche definite.
- Risposta dell’interfaccia: registra quanto indica la risposta secondo il contratto concordato.
- Stato successivo: annota gli stati o i report disponibili, insieme alla loro provenienza e ai relativi limiti.
- Mantieni distinti i log di ciascuna categoria, anziché sommarli in un unico tasso di errore.
Indicatori e finestre di osservazione
Come pratica consigliata, scegli indicatori collegati a decisioni operative: proporzione di verifiche completate, risposte ricevute entro il limite configurato, sessioni osservate, risposte di invio e stati successivi disponibili. Specifica denominatore, popolazione, metodo di verifica e fonte dei dati.
Non basarti solo sulle medie. Una media può nascondere interruzioni brevi o differenze tra endpoint e destinatari. Conserva la serie temporale e controlla gli eventi individuali rilevanti, senza presumere soglie universali.
Definisci finestre di osservazione e limiti di allerta in base al servizio e agli accordi operativi. Registra le modifiche di configurazione e le attività di manutenzione per interpretare le variazioni. Se un test sintetico è poco frequente, considera che potrebbe non rilevare gli errori tra una verifica e l’altra.
- Presenta separatamente connettività, risposta dell’interfaccia e stati successivi.
- Indica, insieme a ogni indicatore, la finestra temporale, la popolazione misurata e il numero di osservazioni.
- Esamina gli eventi brevi e i risultati per endpoint o sessione, oltre al valore aggregato.
Allerte ed escalation basate su evidenze
Come pratica consigliata, un’allerta può indicare quale verifica è fallita, da dove, quando e per quanto tempo, oltre alle fasi precedenti completate. Definisci le regole di escalation in base all’impatto osservato e alle procedure concordate; questa guida non propone soglie universali.
Prima di effettuare un’escalation, raccogli i log pertinenti: timestamp, endpoint o sessione, operazione, risultato osservato, identificativi di correlazione disponibili e portata dell’impatto. Aggiungi il metodo di verifica e i passaggi completati. Non includere password, token o dati personali non necessari.
Quando segnali il problema al provider o al team interno, separa i fatti dalle ipotesi. Per esempio, indica che non è stata ricevuta una risposta entro il limite configurato e in quale fase è accaduto; non affermare che il provider è fuori servizio se la causa non è stata isolata.
- Effettua l’escalation secondo i criteri operativi concordati e l’impatto osservato.
- Includi evidenze relative alle connessioni interessate e a quelle non interessate, per delimitare la portata del problema.
- Se connettività e interfaccia rispondono ma lo stato del messaggio è incerto, chiedi chiarimenti sullo stato e i log disponibili della fase successiva.
Domande frequenti
Una risposta HTTP conferma che l’SMS è stato consegnato?
Non da sola. Conferma che è stata ricevuta una risposta dall’endpoint. Il significato dell’operazione e gli stati successivi vanno consultati nella documentazione e nel contratto di quella API.
Una risposta positiva a submit_sm significa che il destinatario ha ricevuto il messaggio?
Non consente di concluderlo da sola. Consulta la documentazione dell’interfaccia e gli stati successivi disponibili, tenendo conto della loro provenienza e portata.
Una sessione SMPP stabilita dimostra la disponibilità end-to-end?
No. Fornisce informazioni solo sulla sessione osservata; da sola non dimostra che ogni richiesta venga elaborata né che i messaggi abbiano un determinato esito successivo.
Cosa deve fare un test sintetico se non è disponibile un destinatario controllato?
Limitarsi alle verifiche di connettività e risposta dell’interfaccia autorizzate. Non inviare messaggi a destinatari senza autorizzazione né dedurre un esito successivo da una verifica parziale.
Quali informazioni è utile condividere durante l’escalation di un incidente?
Includi ora, endpoint o sessione, operazione, fase dell’errore, risultato osservato, identificativi disponibili e portata del problema. Separa i fatti dalle ipotesi ed escludi credenziali e dati personali non necessari.
Fonti consultate
- HTTP Semantics (RFC 9110)IETF
- SMPP Protocol Specification v3.4SMPP Developers Forum
- SMPP specificationOVHcloud