Disponibilité HTTP et SMPP pour les SMS A2P : que mesurer et comment interpréter les défaillances
Guide opérationnel général pour distinguer la connectivité, les réponses de l’interface et les états ultérieurs des SMS A2P. Les contrôles et leur interprétation doivent être vérifiés au regard du contrat et de l’implémentation de chaque interface.
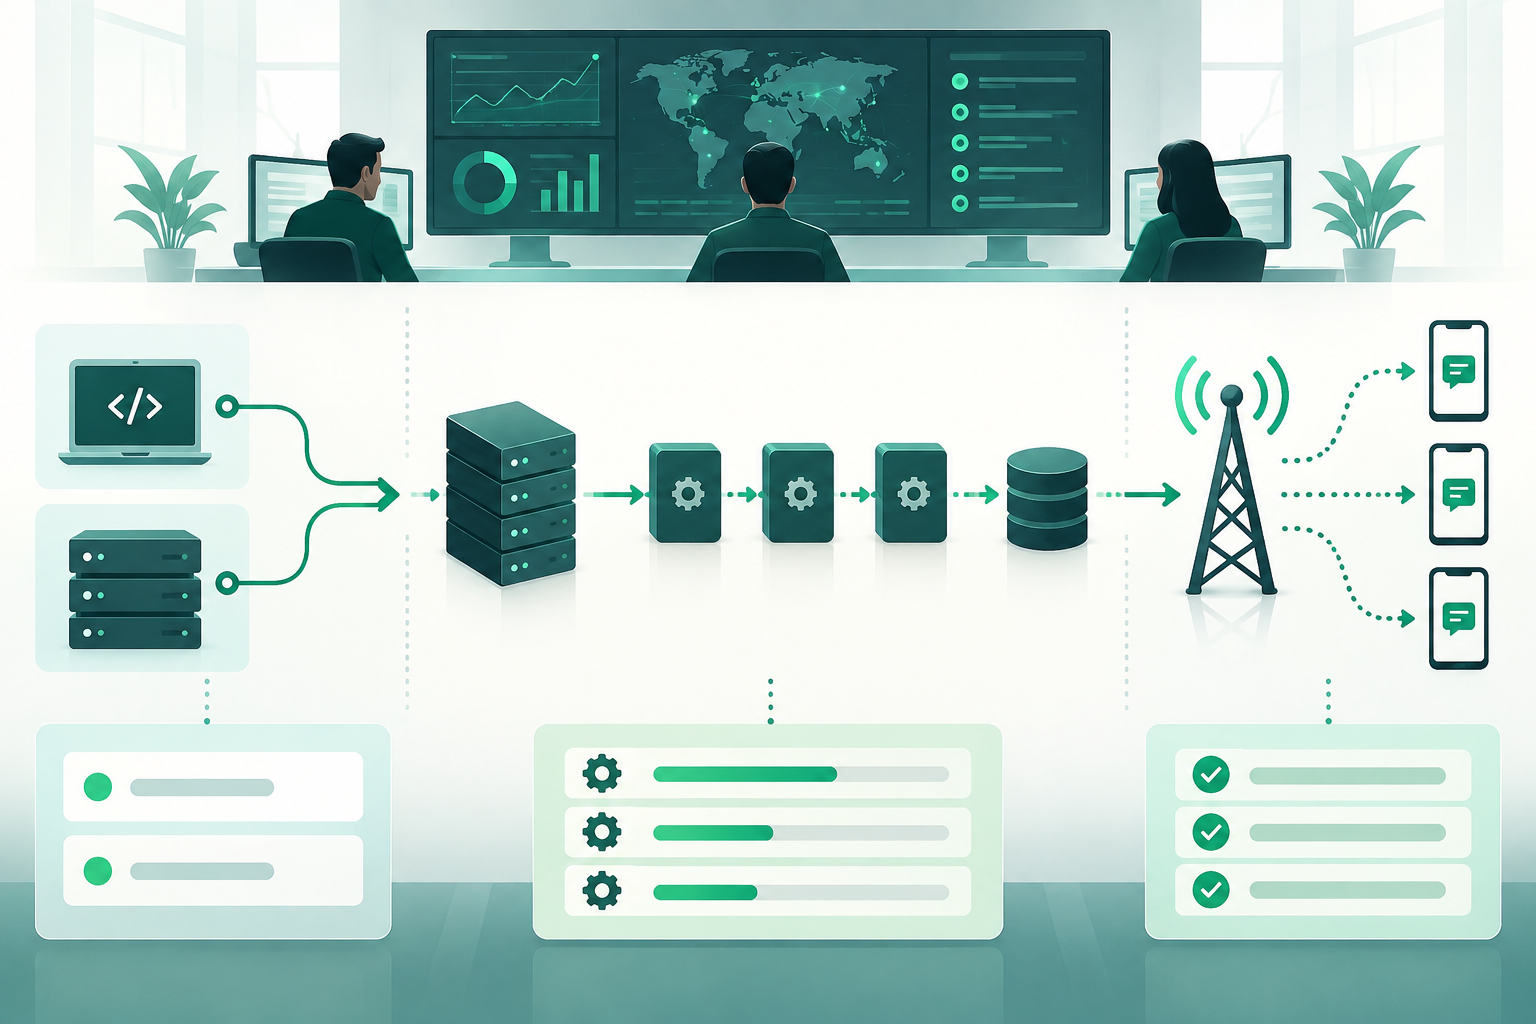
La disponibilité ne signifie pas livraison
Il s’agit d’un guide opérationnel général, et non d’une spécification normative. Les contrôles et interprétations décrits doivent être vérifiés au regard du contrat, de la documentation et de l’implémentation de chaque interface.
Comme cadre de travail, il est utile de distinguer trois résultats : la connectivité, la réponse de l’interface et l’état ultérieur du message. À elle seule, une réponse technique ne permet pas de conclure que le SMS a été traité, acheminé ou reçu sur le téléphone.
Consignez chaque étape séparément. Si elles sont regroupées sous un seul indicateur de « disponibilité », il peut être difficile de distinguer un problème de connexion d’une réponse fonctionnelle ou d’un résultat ultérieur.
- Connectivité : le contrôle défini pour accéder au service a-t-il abouti ?
- Interface : une réponse a-t-elle été reçue pour l’opération vérifiée ?
- État ultérieur : quelles informations sur le message sont disponibles, et quelle en est la provenance ?
- Ne présentez pas une réponse HTTP, une réponse à une requête SMPP ou une session établie comme une preuve suffisante de livraison.
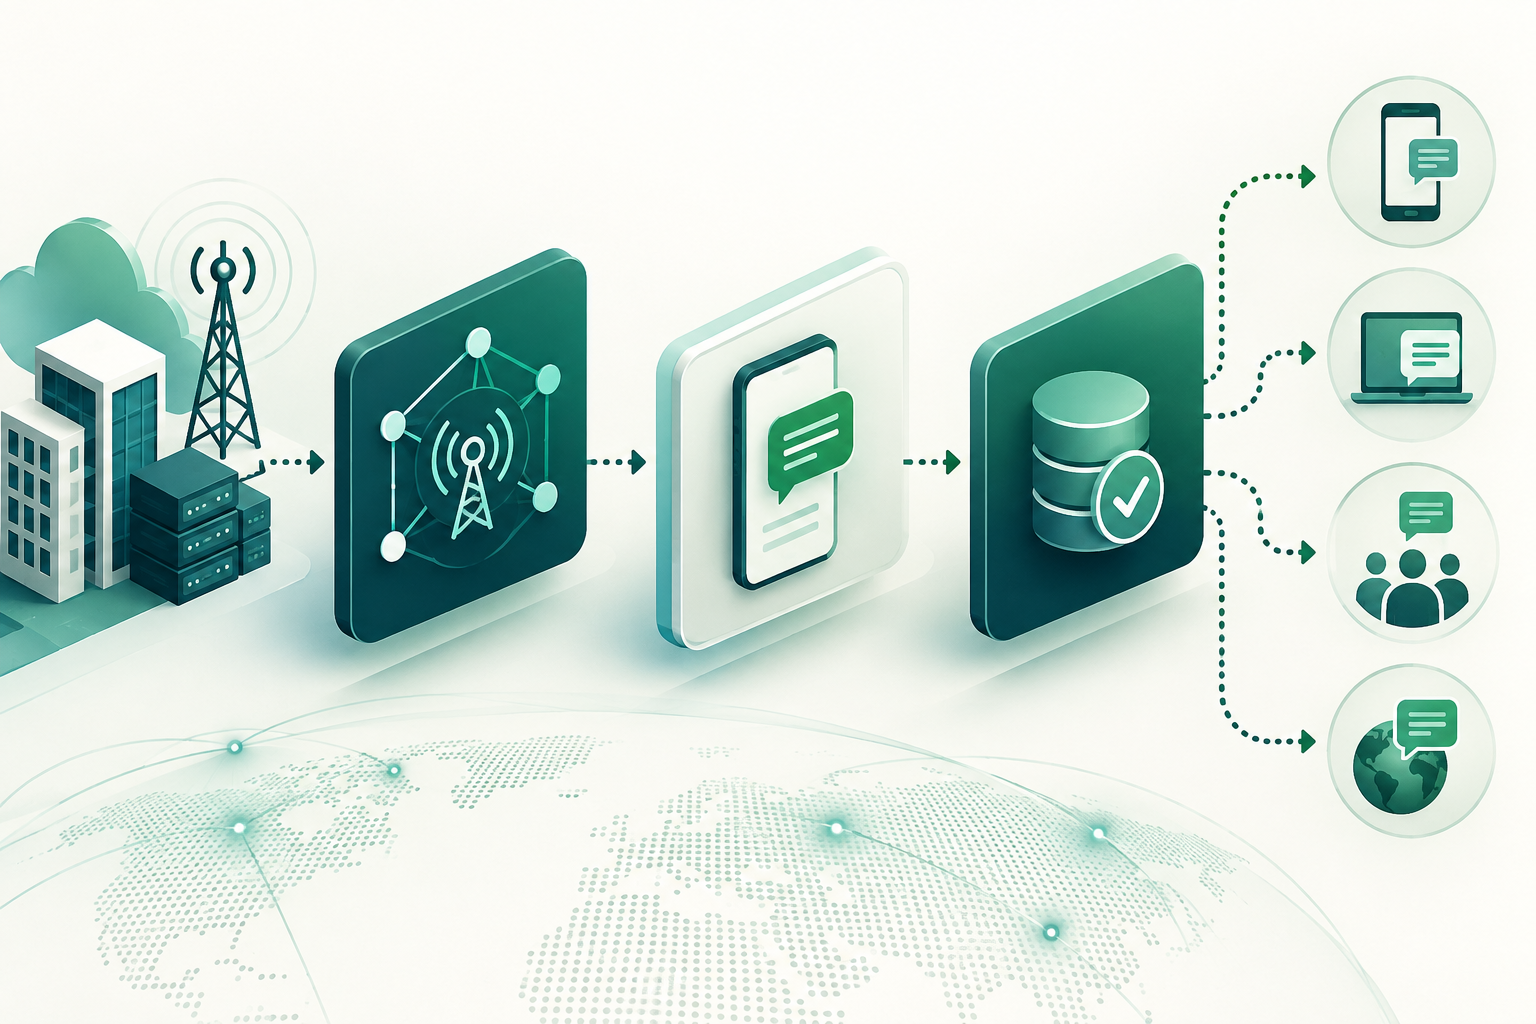
Décomposer le contrôle en étapes
À titre de bonne pratique suggérée, identifiez la dernière étape franchie avant d’attribuer une défaillance au fournisseur ou à l’application. Selon l’implémentation, un contrôle peut distinguer la résolution de nom, la connectivité réseau, l’établissement de la communication, l’authentification, l’envoi d’une opération et la réponse de l’interface.
Définissez à l’avance l’endpoint, les identifiants de test, l’opération et le résultat considérés comme valides. Comparez le contrôle à une référence connue et conservez, lorsqu’elles sont disponibles, les horodatages et les journaux des deux extrémités. Un timeout signifie que le contrôle n’a pas abouti dans le délai configuré ; à lui seul, il n’en identifie pas la cause.
En cas d’incident, vérifiez si le schéma concerne toutes les connexions ou seulement un client, un endpoint, une opération ou une destination de test. Cette comparaison peut orienter l’enquête, mais elle ne confirme pas à elle seule l’origine du problème.
- Notez l’étape exacte de la défaillance, en fonction des étapes applicables à l’interface.
- Définissez des délais d’attente et consignez le temps écoulé ; ne présentez pas un dépassement de délai comme un diagnostic de la cause.
- Conservez l’heure, les identifiants de corrélation disponibles et le résultat observé ; évitez de stocker des identifiants d’accès ou des données personnelles inutiles.
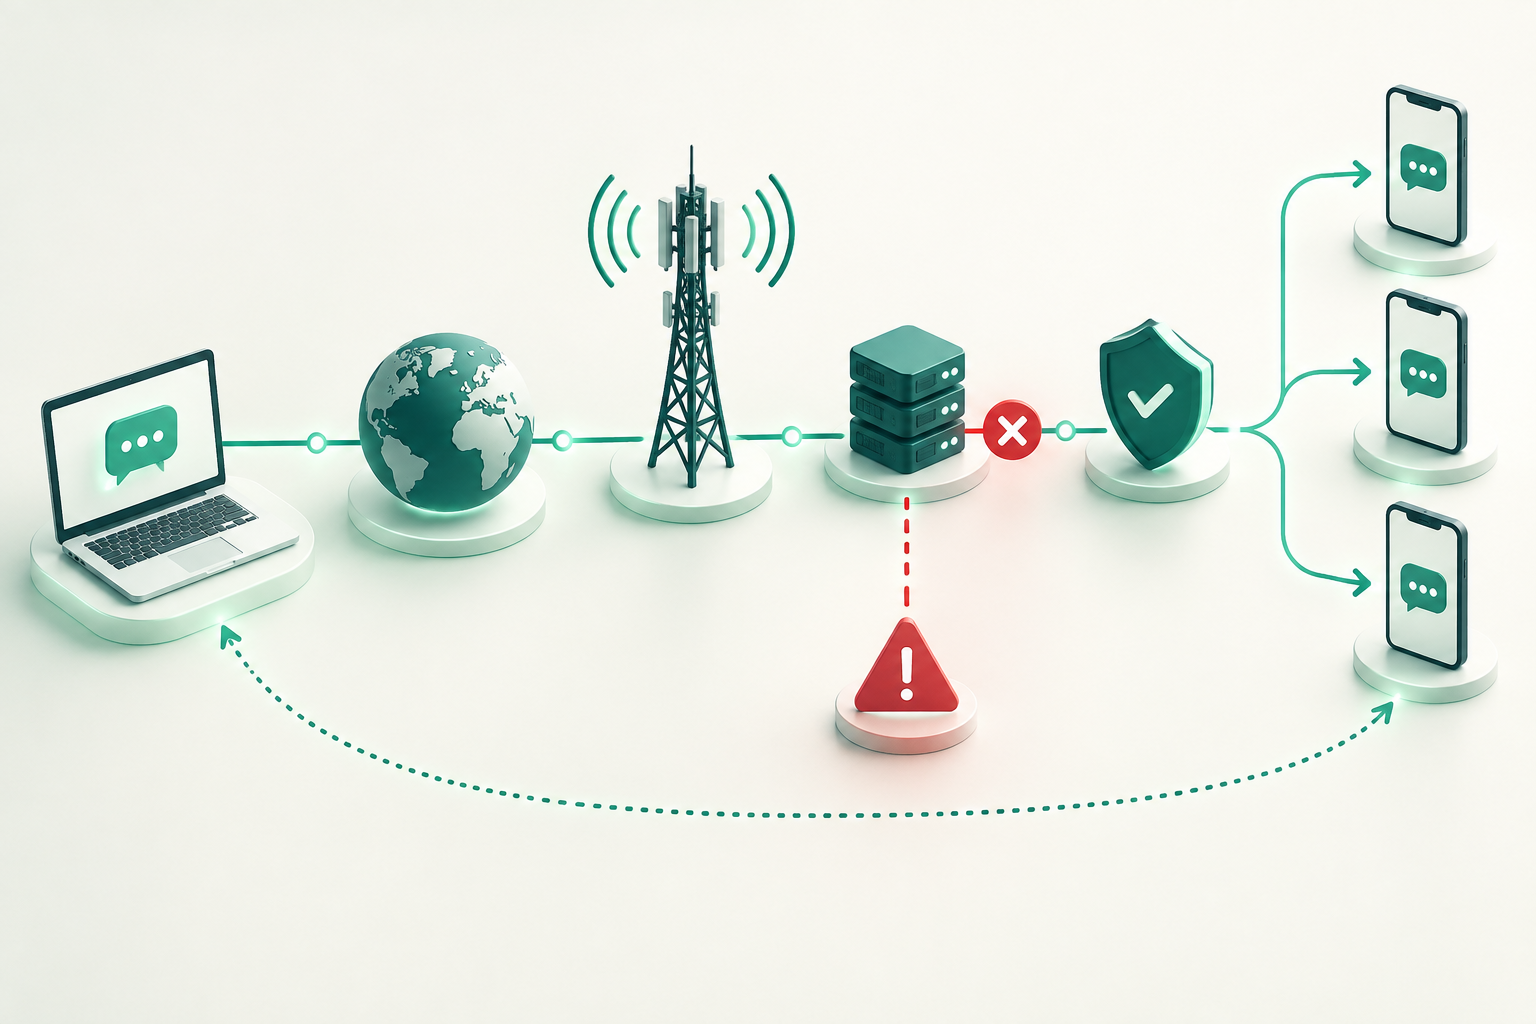
Que surveiller avec HTTP
À titre de pratique opérationnelle générale, il peut être utile de distinguer le temps de connexion du temps total nécessaire pour recevoir une réponse. Consignez le statut HTTP, les temps observés, les timeouts et les erreurs applicatives exposées par l’interface. Interprétez le résultat selon la documentation et le contrat de l’API ; ce guide ne définit pas la signification de codes HTTP particuliers.
Distinguez la réception d’une réponse d’un résultat fonctionnel. Une réponse HTTP ne permet pas à elle seule de déterminer si l’opération a été acceptée, refusée ou laissée en attente : consultez la sémantique documentée pour cette interface.
Évitez de relancer aveuglément une requête après un timeout survenu une fois celle-ci envoyée. Si l’interface ne permet pas de savoir si l’opération a été traitée, une nouvelle tentative pourrait la dupliquer. Demandez au fournisseur comment vérifier le résultat ou effectuer des relances en toute sécurité.
- Parmi les indicateurs suggérés, consignez séparément la connexion, le temps de réponse, le statut HTTP et le résultat fonctionnel communiqué par l’API.
- Classez les résultats selon le contrat de l’interface, sans supposer qu’un statut a la même signification dans tous les systèmes.
- Consultez la documentation de l’API pour interpréter les réponses et résoudre les états incertains avant d’automatiser les nouvelles tentatives.
Que surveiller avec SMPP
À titre de journal opérationnel général, il peut être utile de consigner le résultat du bind, l’état observé de la session, les contrôles d’activité configurés, les requêtes submit_sm et leurs réponses, ainsi que les déconnexions et reconnexions. L’interprétation de ces événements dépend de la version, de la configuration et de la documentation convenue avec l’extrémité distante.
Ne déduisez pas qu’un destinataire a reçu le message à partir de la réponse à une requête d’envoi. De même, une session établie ne prouve pas, à elle seule, que toutes les requêtes ultérieures seront acceptées ni que leurs messages auront un résultat ultérieur déterminé.
Lorsqu’ils sont disponibles, corrélez les réponses d’envoi avec les identifiants renvoyés par l’interface et avec les états ultérieurs. Considérez un DLR comme un état signalé par le système correspondant, et non comme une vérification indépendante que le téléphone a affiché le message ou que la personne l’a lu.
- À titre d’observations opérationnelles suggérées, consignez les sessions établies ou perdues, leur durée, l’activité configurée et les reconnexions.
- Notez le résultat de chaque requête d’envoi et les identifiants associés ; distinguez la réponse d’envoi de l’état ultérieur.
- Consultez la configuration et la documentation convenues pour interpréter les événements, les limites et les états ; ne supposez pas l’existence de valeurs universelles.
Concevoir des tests synthétiques sûrs et utiles
À titre de pratique suggérée, un test synthétique vérifie un parcours limité dans des conditions contrôlées ; il ne représente pas automatiquement l’ensemble du trafic, toutes les destinations ou tous les opérateurs. Précisez le composant évalué et les conclusions qui dépassent le cadre du test.
Utilisez des comptes, des numéros et des destinations de test contrôlés et autorisés, ainsi qu’un contenu permis et convenu. Coordonnez la méthode, la fréquence et les limites avec le fournisseur et les politiques applicables. En l’absence de destination contrôlée ou d’autorisation claire, limitez le test aux contrôles autorisés.
Respectez une fréquence convenue afin d’éviter du trafic inutile ou des interférences. Identifiez les contrôles pour séparer leurs résultats du trafic réel. N’envoyez pas de messages à des personnes qui n’ont pas autorisé le test.
- Définissez l’objectif du contrôle : connectivité, authentification, réponse de l’interface ou parcours de test autorisé.
- Convenez à l’avance des destinations, du contenu, de la fréquence, du volume et de la méthode d’identification des tests.
- Documentez les limites : un résultat satisfaisant pour une destination et à un moment donné ne garantit ni une disponibilité générale ni des résultats futurs.
Mettre en relation connectivité, réponses et états ultérieurs
À titre de méthode d’enquête suggérée, suivez une séquence de preuves : vérifiez s’il y a eu connectivité, si l’authentification et la requête ont abouti, puis quels états ultérieurs sont disponibles. Cette séquence aide à structurer l’enquête, mais ne prouve pas à elle seule la cause.
Corrélez les horodatages, les identifiants de requête ou de message, l’endpoint ou la session, la réponse reçue et les événements de déconnexion. Comparez les données de l’émetteur et du récepteur lorsque les deux parties peuvent les fournir. Si des identifiants communs manquent ou si les horloges ne sont pas comparables, signalez-le comme une limite.
N’attribuez pas une évolution des états ultérieurs à la connectivité au seul motif qu’elle coïncide avec une hausse des erreurs. La corrélation peut orienter le diagnostic, mais il faut des éléments probants concernant l’étape correspondante pour établir une cause.
- Connectivité : consignez les défaillances observées lors des contrôles définis.
- Réponse de l’interface : consignez ce que la réponse indique selon le contrat convenu.
- État ultérieur : notez les états ou rapports disponibles, ainsi que leur provenance et leurs limites.
- Gardez les journaux de chaque catégorie séparés au lieu de les regrouper dans un taux de défaillance unique.
Indicateurs et périodes d’observation
À titre de pratique suggérée, choisissez des indicateurs utiles aux décisions opérationnelles : proportion de contrôles aboutis, réponses reçues dans le délai configuré, sessions observées, réponses d’envoi et états ultérieurs disponibles. Précisez le dénominateur, la population, la méthode de contrôle et la source des données.
Ne vous fiez pas uniquement aux moyennes. Une moyenne peut masquer des interruptions brèves ou des écarts entre endpoints et destinations. Conservez les séries temporelles et examinez les événements individuels pertinents, sans supposer l’existence de seuils universels.
Définissez les périodes d’observation et les seuils d’alerte en fonction du service et des accords opérationnels. Consignez les changements de configuration et les opérations de maintenance pour interpréter les variations. Si un test synthétique est peu fréquent, gardez à l’esprit qu’il pourrait ne pas détecter les défaillances survenant entre deux contrôles.
- Présentez séparément la connectivité, les réponses de l’interface et les états ultérieurs.
- Indiquez, pour chaque indicateur, la période, la population mesurée et le nombre d’observations.
- Examinez les événements de courte durée et les résultats par endpoint ou session, en plus de la valeur agrégée.
Alertes et escalade fondées sur des éléments probants
À titre de pratique suggérée, une alerte peut préciser quel contrôle a échoué, depuis quel emplacement, à quel moment et pendant combien de temps, ainsi que les étapes précédentes qui ont abouti. Définissez les règles d’escalade en fonction de l’impact observé et des procédures convenues ; ce guide ne propose pas de seuils universels.
Avant une escalade, rassemblez les journaux pertinents : horodatages, endpoint ou session, opération, résultat observé, identifiants de corrélation disponibles et étendue de l’impact. Ajoutez la méthode de contrôle et les étapes franchies. N’incluez pas de mots de passe, de jetons ni de données personnelles inutiles.
Lorsque vous informez le fournisseur ou l’équipe interne, distinguez les faits des hypothèses. Indiquez, par exemple, qu’aucune réponse n’a été reçue dans le délai configuré et à quelle étape cela s’est produit ; n’affirmez pas que le fournisseur est en panne si la cause n’a pas été isolée.
- Procédez à l’escalade selon les critères opérationnels convenus et l’impact observé.
- Incluez des éléments concernant les connexions affectées et non affectées afin de délimiter l’étendue du problème.
- Si la connectivité et l’interface répondent, mais que l’état du message reste incertain, demandez comment interpréter cet état et quels journaux de l’étape ultérieure sont disponibles.
Questions fréquentes
Une réponse HTTP confirme-t-elle que le SMS a été livré ?
Pas à elle seule. Elle confirme qu’une réponse a été reçue de l’endpoint. La signification de l’opération et des états ultérieurs doit être vérifiée dans la documentation et le contrat de cette API.
Une réponse satisfaisante à submit_sm signifie-t-elle que le destinataire a reçu le message ?
Cela ne permet pas de le conclure à elle seule. Consultez la documentation de l’interface et les états ultérieurs disponibles, en tenant compte de leur origine et de leur portée.
Une session SMPP établie démontre-t-elle une disponibilité de bout en bout ?
Non. Elle renseigne uniquement sur la session observée ; à elle seule, elle ne prouve ni que chaque requête sera traitée ni que les messages auront un résultat ultérieur déterminé.
Que doit faire un test synthétique en l’absence de destination contrôlée ?
Se limiter aux contrôles de connectivité et de réponse de l’interface qui sont autorisés. N’envoyez pas de messages à des destinataires sans autorisation et ne déduisez pas un résultat ultérieur d’un contrôle partiel.
Quelles informations partager lors de l’escalade d’un incident ?
Indiquez l’heure, l’endpoint ou la session, l’opération, l’étape de la défaillance, le résultat observé, les identifiants disponibles et l’étendue de l’impact. Distinguez les faits des hypothèses et excluez les identifiants d’accès et les données personnelles inutiles.
Sources consultées
- HTTP Semantics (RFC 9110)IETF
- SMPP Protocol Specification v3.4SMPP Developers Forum
- SMPP specificationOVHcloud